


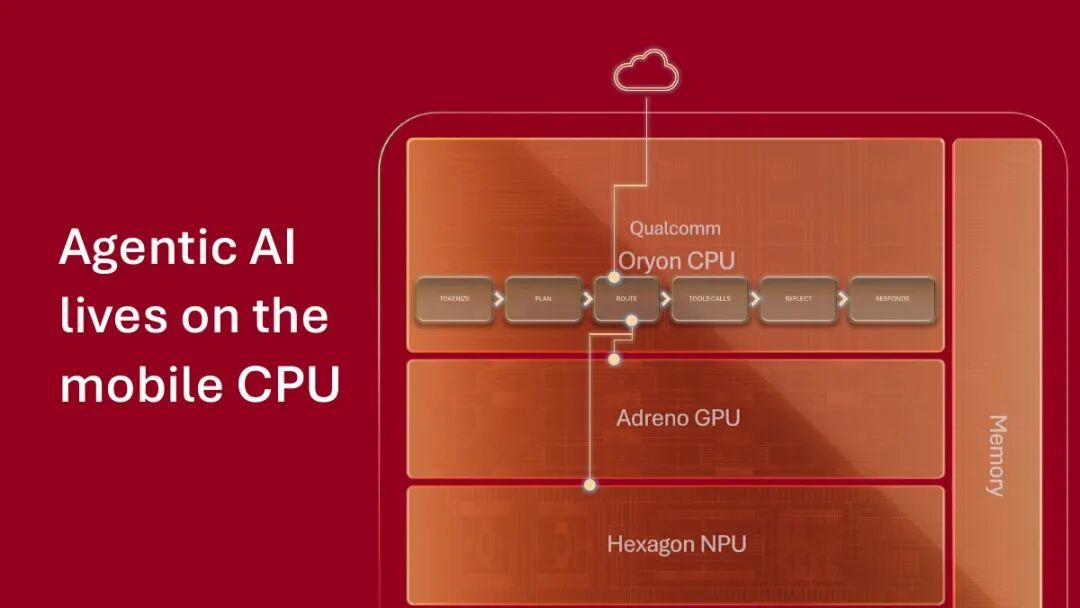
9月13日消息,高通公司即将于本月下旬在美国夏威夷举办年度骁龙技术峰会,届时将会正式发布新一代骁龙旗舰移动平台——骁龙 8 Elite Gen 6 系列。近日,关于该平台的部分技术细节内部资料被曝光,展示出其在“智能体AI(Agentic AI)时代”对移动计算平台的完整构想。
新一代Oryon CPU:移动端首个5GHz Prime核心
根据最新曝光内部资料显示,高通新一代骁龙旗舰移动平台将会集成新一代Oryon CPU,这也将是高通首个面向智能体AI时代的CPU核心。根据高通的说法,Oryon CPU负责“编排智能体工作负载”,协调规划、工具调用与加速器任务的分发。这意味着CPU正在从单纯的通用计算单元,转变为移动端整个AI代理系统的调度中枢。
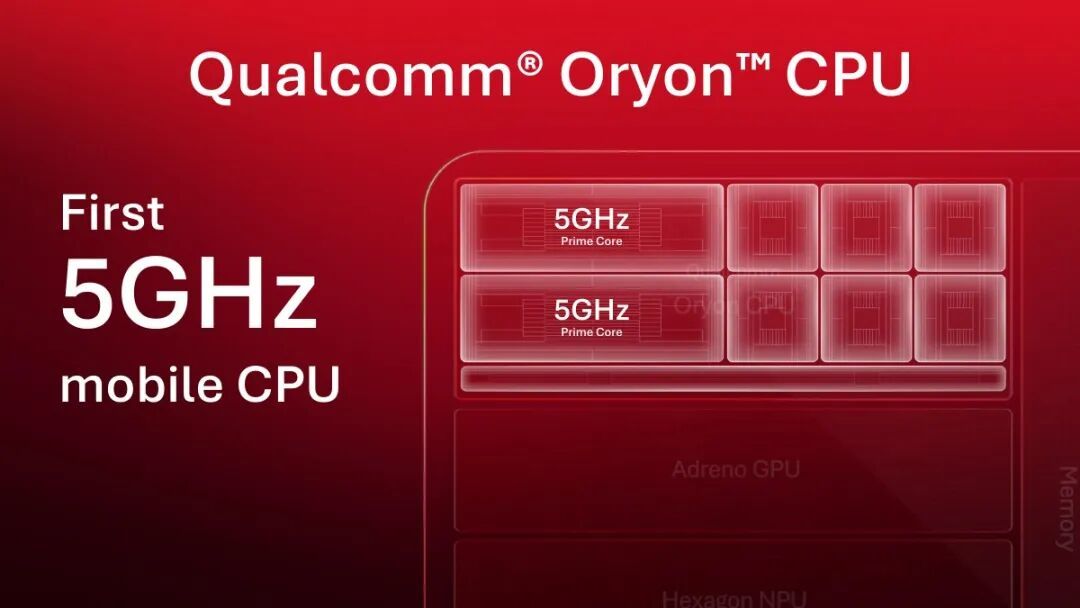
新一代骁龙旗舰移动平台将会采用2+6的八核架构,其中两颗Prime核心主频高达 5 GHz,这将是移动CPU首次达到这一频率(据说即将发布的联发科天玑9600 Pro也将达到这一频率)。这一设计也依托于高通自研的CPU微架构、实现方案与子系统协同优化。
另一项关键技术是FlexCache。这是一个由异构CPU核心动态分配的缓存池。
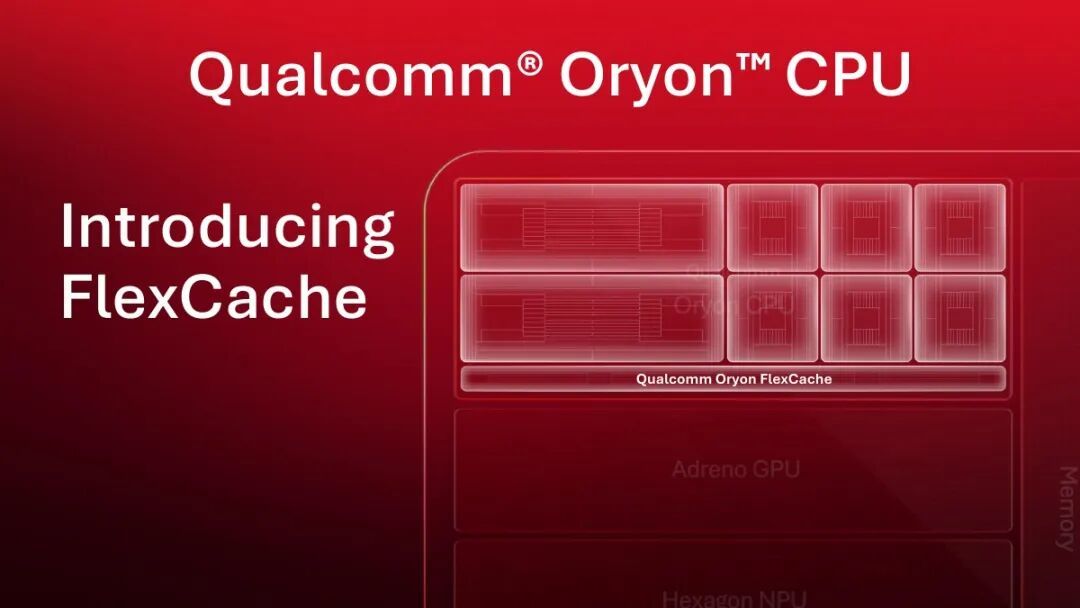
据介绍,Prime核心可以根据工作负载需求调用整个缓存池,从而将更大的工作集保留在缓存中,减少对系统内存的访问。
新一代Adreno GPU:加入矩阵核心与18MB HPM本地存储
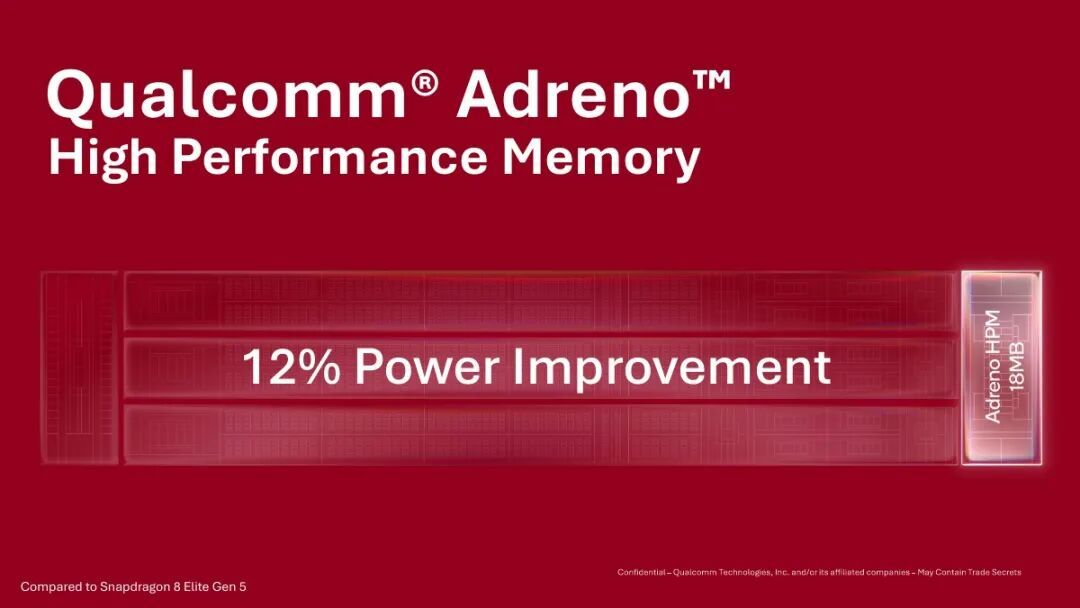
新一代Adreno GPU的架构由三个模块组成,包括三个运行在1.45 GHz的GPU切片(slice)、一个命令处理器和一个18 MB的Adreno High Performance Memory(HPM)组成。
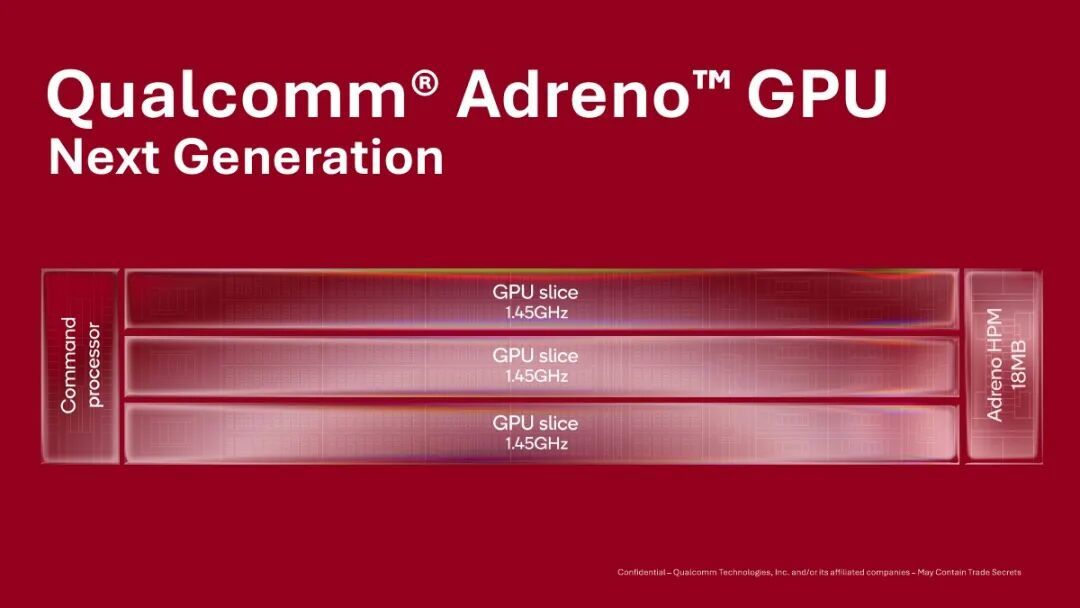
其中,HPM作为本地图形存储,用于存放GPU Tiles和帧缓冲(frame buffers)等工作数据,从而减少对系统内存的访问。
高通表示,这一设计相比Snapdragon 8 Elite Gen 5基线带来了12%的功耗改善。
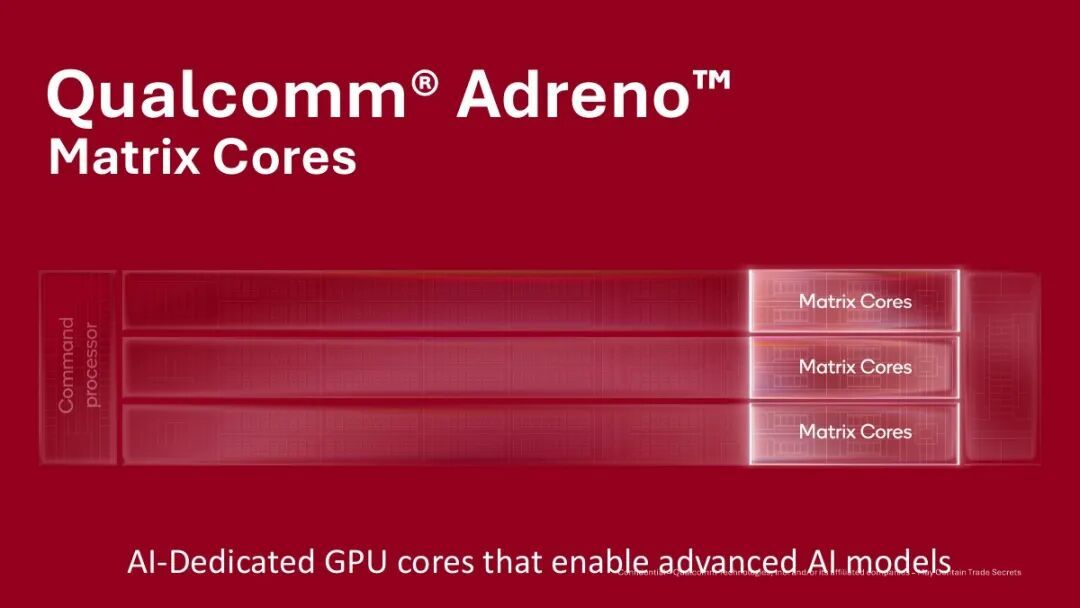
每个GPU切片内部都包含Matrix Cores,将专用的矩阵计算与AI处理能力引入图形管线。结合HPM将工作数据保持在近端,Adreno GPU在能效上减少了对片外内存的依赖。
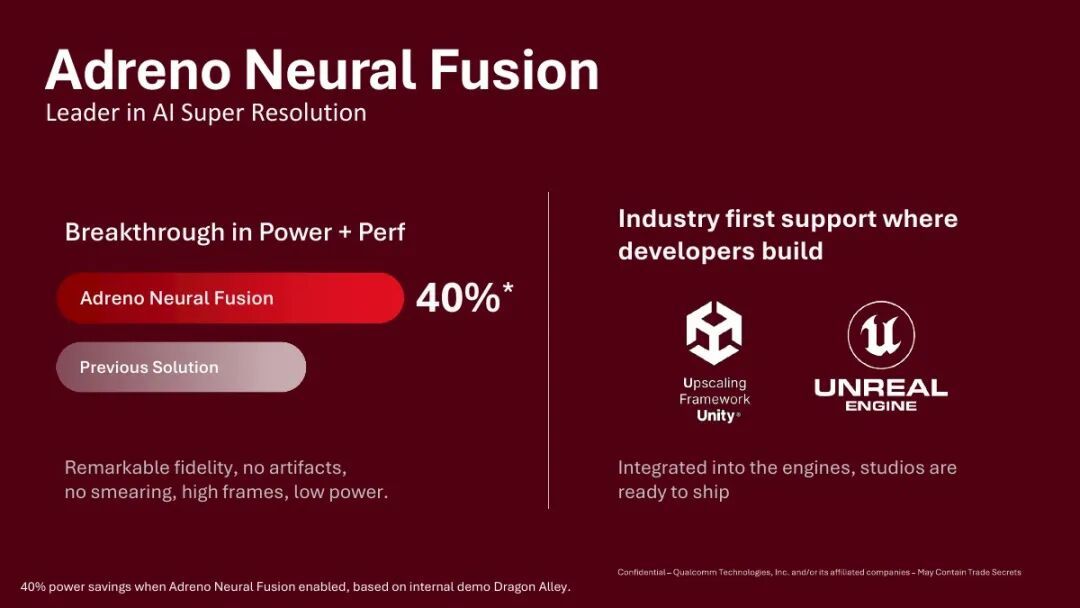
在AI渲染方面,Adreno Neural Fusion提供了AI渲染与超分辨率能力,并与Unity和Unreal Engine的上采样框架集成。高通称,在内部“Dragon Alley”演示中,启用Neural Fusion后实现了40%的功耗节省。
新一代Hexagon NPU:元素加速器、50%共享内存增长与30B MoE模型支持
Hexagon NPU是高通新一代骁龙旗舰移动平台中变化最为显著的部分。它新增了一个专为Transformer运算设计的Element Accelerator(元素加速器),可与既有的向量计算单元(Vector) 和标量计算单元(Scalar) 协同工作,进一步加速大模型中最关键的Transformer运算,帮助智能体更快响应、更高效推理。
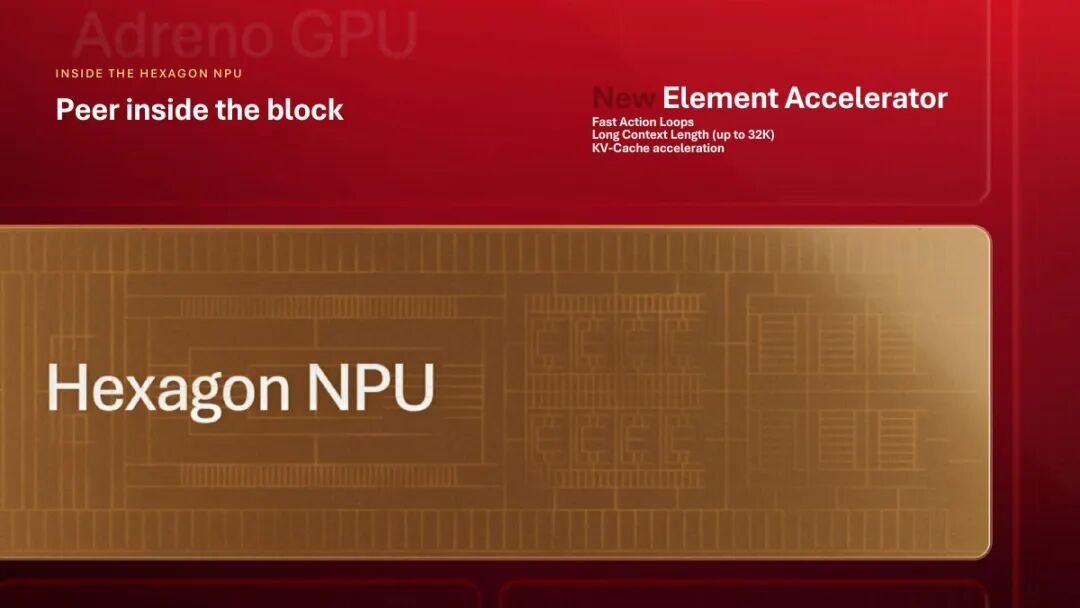
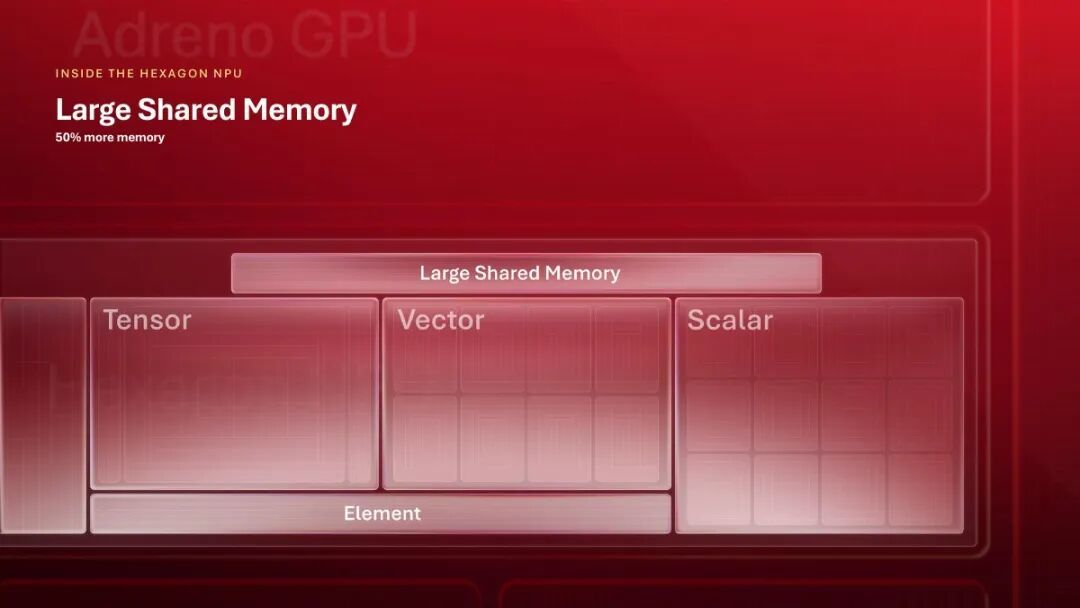
同时,新一代Hexagon NPU还支持最长32K的上下文长度,并包含KV-cache加速。
支持最长32K的上下文长度,这意味着设备端可以一次性处理更长的对话历史、更复杂的文档或多轮任务规划,而无需频繁截断或遗忘早期信息。对于需要保持长期记忆的智能体应用至关重要。
KV-Cache是大模型推理过程中用于缓存已计算键值对的关键机制,加入了专门的KV-Cache硬件加速器,将直接提升生成速度和内存效率。
此外,新一代Hexagon NPU还拥有更大的共享内存系统,据称比上一代提升了50%,但未公布具体容量。通过扩大的共享内存系统,可以将模型状态、上下文信息和KV-Cache数据存储在更靠近计算单元的位置,减少对外部内存的访问频次。这直接缓解了内存带宽瓶颈——对于大模型推理而言,瓶颈往往不在算力,而在数据搬运的延迟与功耗。
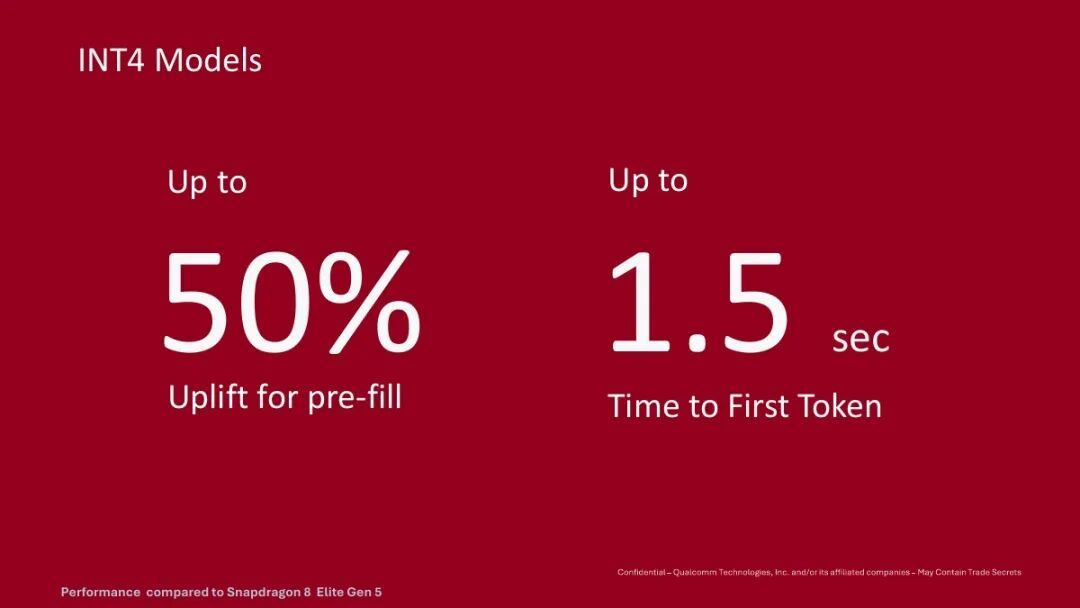
高通表示,在INT4模型上,新一代Hexagon NPU的prefill(预填充,是指模型在生成后续Token之前对输入提示的处理阶段)性能相比上一代的Snapdragon 8 Elite Gen 5提升了最高50%。首个Token的生成提升了1.5秒。
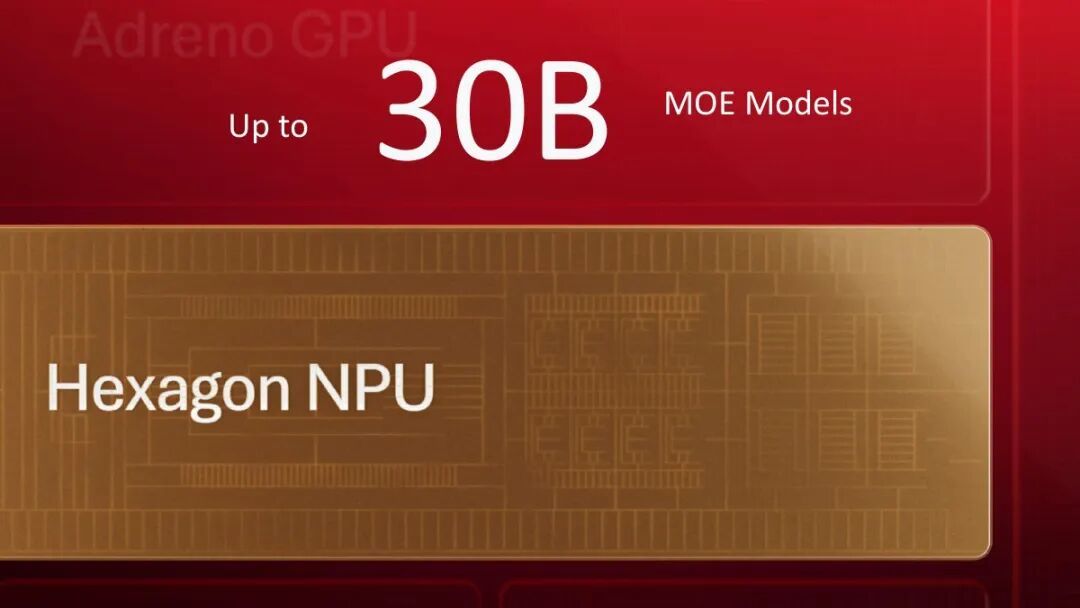
在混合专家(MoE)模型方面,新一代Hexagon NPU可运行参数量高达300亿的MoE模型,每个token生成步骤大约激活30亿参数。高通通过Flash-to-memory的专家管理与缓存机制来支撑这类模型的运行。
Sensing Hub:智能体AI的感知中枢
高通还对新一代骁龙旗舰移动平台“智能体AI工作流”在芯片层面进行了完整描述。它把此前分别介绍的Oryon CPU、Adreno GPU、Hexagon NPU和Sensing Hub串联成了一个端到端的闭环。
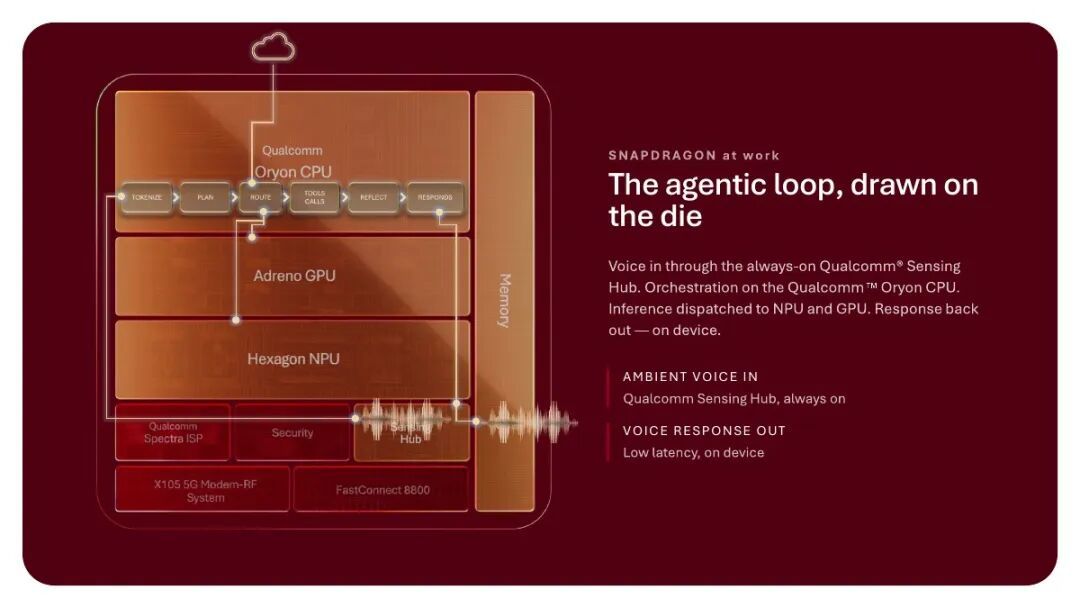
其中,新一代Sensing Hub将负责始终在线的环境语音捕获,在将其交给Oryon CPU,由Oryon CPU编排任务执行。推理工作负载则被分发至GPU或NPU,并保留云端卸载路径。
让数据与计算尽可能靠近
高通新一代骁龙旗舰移动平台是面向智能体AI的全新移动平台,为了顺应这一需求,其遵循的一大设计方向是针对智能体AI进行加速,无论是将两颗Prime核心主频提升至5GHz,在GPU中加速矩阵计算核心,还是在NPU中加入专为Transformer运算设计的Element Accelerator(元素加速器),都是为了提升端侧智能体AI的性能。
另一大设计方向则是,让数据与计算尽可能靠近使用它们的处理资源,从而减少对较慢系统内存的依赖,从而提升智能体AI的运行速率、降低延时。无论是Oryon CPU的FlexCache、Adreno的HPM,还是Hexagon NPU的共享内存扩展,都遵循这一思路。
高通预计,当这一代平台最终进入终端产品时,将带来相当可观的性能提升。随着接下来骁龙技术峰会的召开,届时将会有更多关于新一代骁龙移动平台的详细规格与实际表现数据。