


【CNMO科技消息】DeepSeek近日发布新一代AI模型V4.1-Flash。按照官方介绍,V4.1-Flash虽然总参数规模和激活参数均低于V4-Pro,但在性能、推理速度和成本控制方面表现更突出,尤其在智能体和编程相关任务上,部分基准测试成绩超过V4-Pro以及GPT-5.6 Sol等部分前沿模型。

DeepSeek
CNMO科技注意到,V4.1-Flash采用专家混合架构,总参数为5520亿,输入阶段激活参数为80亿,输出阶段为160亿。相比之下,上一代V4-Flash总参数为2840亿,V4-Pro总参数则达到1.6万亿。该模型的一项重点改进是大幅压缩KV缓存,缓存占用降至每个token约890字节,同时输出速度达到每秒约214.4个token,首个token响应时间为1.13秒。独立评测机构AA给出了“速度显著较快”的评价。
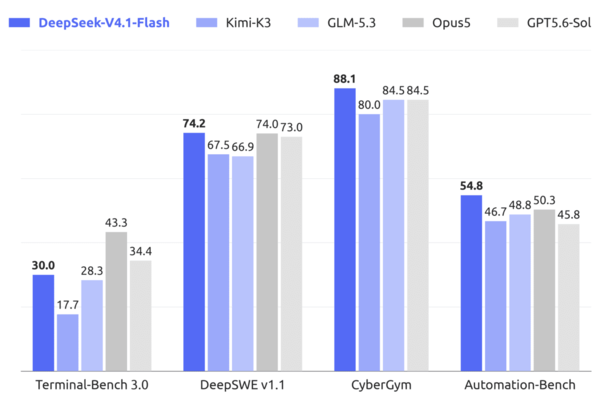
在性能方面,DeepSeek称,V4.1-Flash在高推理强度设置下,于终端操作、代码修复和自动化任务等测试中领先于GPT 5.6 Sol和Claude Opus 5。不过在更广泛的高难度通用推理任务中,该模型成绩相对一般。AA数据显示,V4.1-Flash的综合智能指数为40分,高于多数同类开源权重模型中位水平,但仍低于头部前沿模型。需要注意的是,AA近期升级了评测体系,整体评分标准明显收紧,不少高分模型的分数也出现下调。
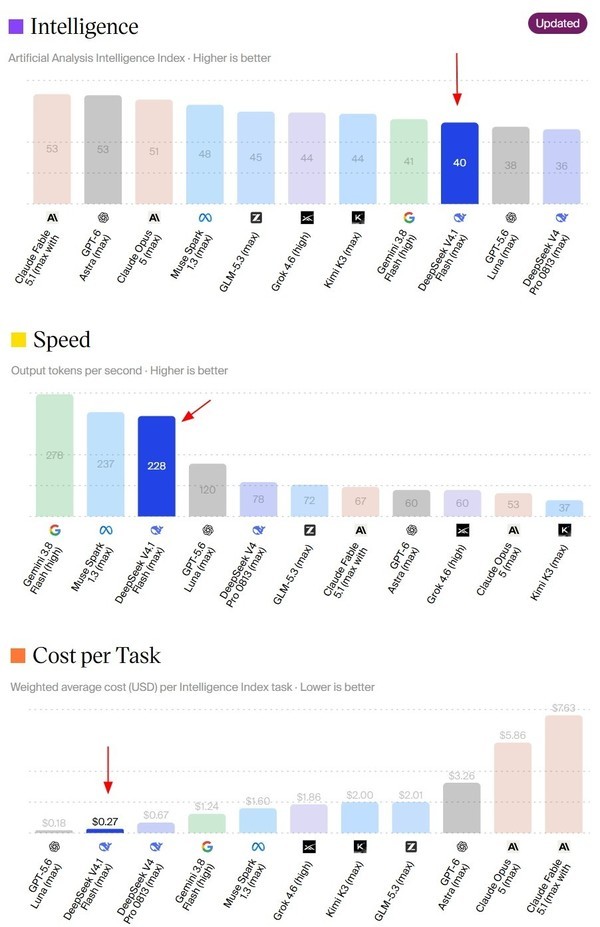
价格方面,AA数据显示,V4.1-Flash每100万输入token价格为0.3美元,每100万输出token价格为1.2美元,综合成本约0.184美元,低于同档模型中位数。若命中缓存,价格可进一步降至每100万token 0.006美元。AA同时指出,该模型回答偏长,评测中输出token总量明显高于同类模型,可能对实际使用中的时间和费用带来影响。
技术层面,V4.1-Flash引入名为CED的新结构,将40层Transformer拆分为20层因果编码器和20层解码器,减少传统交叉注意力带来的重复计算,并结合CSA2、FP4量化等方法压缩缓存与内存占用。
整体来看,DeepSeek此次更新重点放在智能体执行、代码能力和部署成本优化上。