


允中 发自 凹非寺
量子位 | 公众号QbitAI
10万个原子,一张GPU,就能开始跑精确的化学反应。
这是分子之心最新反应性机器学习力场QuantaMind正在推进的计算尺度。
最新扩展测试中,QuantaMind已能够以接近量子化学计算的精度模拟十万原子级体系数百纳秒的反应,单步计算耗时仅约0.25秒;
而在发表于《Science Advances》的研究中,它已经在一个包含17,792个原子的完整PET水解酶体系中连续模拟6 ns,让质子转移、断键、成键,直到完整酶催化循环,都在计算机里一步步清晰地发生。
AI不只是给分子“拍照”,现在开始给真实化学反应“拍电影”。
困局:精度、时间、规模的不可能三角
要把“拍电影”变成现实,首先得跨过分子模拟领域长期存在的一个“不可能三角”,即精度、时间、规模三者不可兼得——要精度就得牺牲规模和时间,要规模就得牺牲精度。
过去,分子模拟主要依靠两类计算方法,但它们各自只能解决“不可能三角”的一部分。
一类是高精度计算(如量子力学方法),能看清化学反应的每一个细节,但计算量巨大。
在大型体系上的算力成本和耗时都很高,实际研发中难以直接运行这类计算,通常只能算几百上千个原子、几万亿分之一秒的极短瞬间。
另一类是传统分子模拟,能跑数万乃至百万原子、更长的时间,规模最高可达前者的上千倍,但它假设分子结构是固定的,不会成键断键。酶催化、酸碱反应这类过程,它天然“看不见”。
近年来兴起的AI分子模拟模型,试图用神经网络学习高精度计算数据,兼顾精度与速度,已成为国际前沿机构持续投入的热点。
但多数模型的训练数据只来自分子稳定状态下的样子,没见过“反应正在发生的那个瞬间”,遇到化学反应就露怯;而且在大型生物体系的长时间模拟中难以维持稳定性,规模上仍受限。
破局:三步让AI同时拿到精度、速度和规模
针对上述AI模型的短板,QuantaMind做了三件事,即在保持精度的同时,把速度和规模提上去。
其一,让AI大量看“反应正在发生”的瞬间。
论文用5,286个化学反应的关键瞬间数据训练模型,让AI真正见过“化学键正在断裂、正在形成”的样子。
其二,让AI学会整合不同来源、不同精度的计算数据。
模型把各种数据来源的“风格”作为特征学进去,训练时还能按数据质量分配权重。
其三,让AI自己发现薄弱环节,再针对性补课。
针对特定的蛋白质和酶体系,先用模型跑模拟,再对AI拿不准的构型做高精度计算、补充训练,如此循环。
为了进一步提升模拟在实际研发场景的可用性,QuantaMind把稳定性也作为指标攻了下来:长时间模拟中,体系的总能量漂移极小,可稳定支撑数百纳秒的连续模拟而不崩溃。
三道基础反应“压力测试”:从质子跳跃到酸碱中和
QuantaMind首先面对三道性质截然不同的基础反应测试:
质子在水中的连续跳跃(需要上万次事件积累才能统计收敛);
纯水的自发解离(难得一遇的罕见事件);
几乎瞬间完成的酸碱中和(已知最快的溶液反应之一)。
三道测试覆盖了从慢统计、罕见事件到超快反应的完整谱系,结果均与实验高度吻合,而且QuantaMind并没有针对这类反应做专门训练,全凭通用模拟能力自己学会了。
但这些还只是几千到几万原子的小体系测试,真正的大考在后面。
进阶验证:蛋白质环境中的酸碱度感知
更进一阶的测试来到真实生物环境:蛋白质中的特定位点会随酸碱度改变性质,进而影响蛋白质功能。
传统模拟需要人工预设这些状态,而QuantaMind不需要——它将一种蛋白质放入接近真实实验条件的缓冲液环境中跑了20纳秒,让关键位置自己“接”或“放”质子,估算的临界点(5.81)与核磁共振实验值(5.5)接近,说明它能描述环境变化如何影响蛋白质的微观状态。
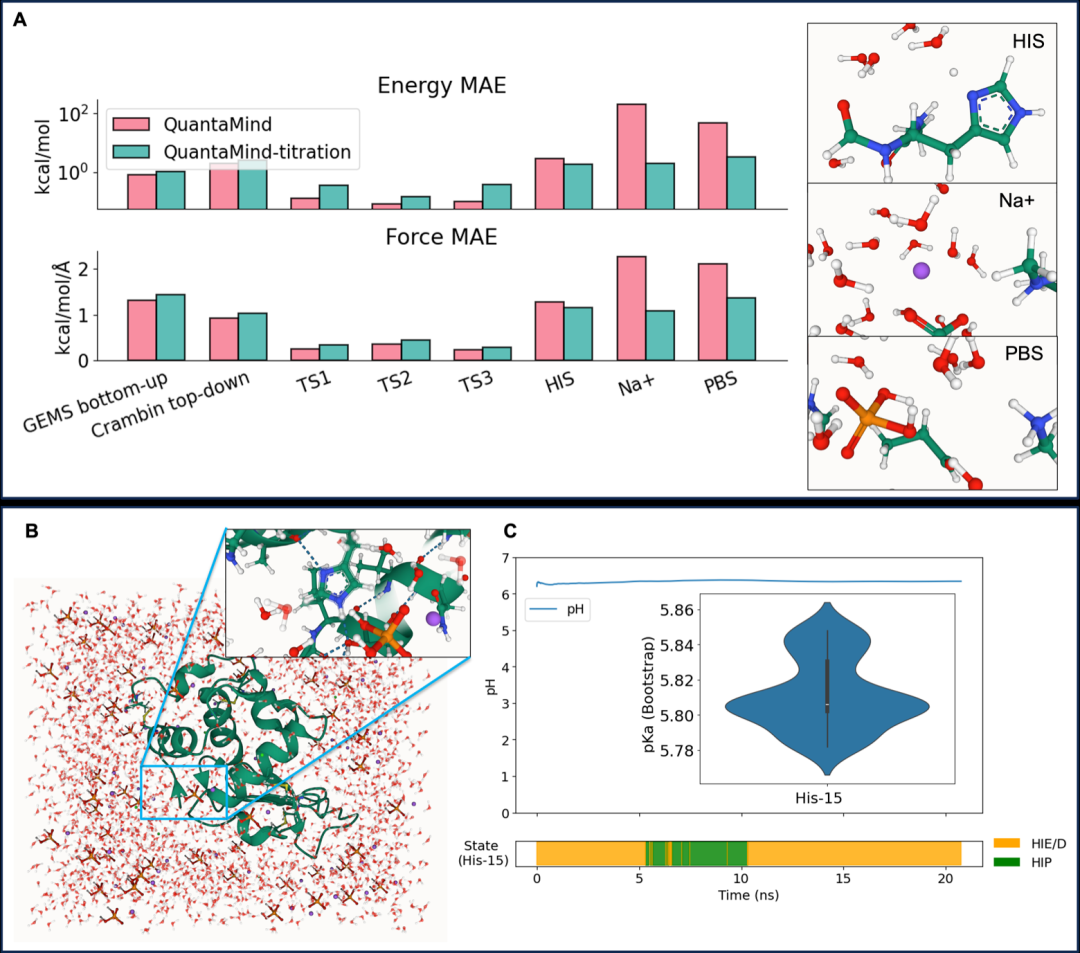
△组氨酸滴定模拟与pKa估算(来源:论文原图)
压轴:1.8万原子的酶催化全程模拟
如果说前面几场是“小试牛刀”,那真正的压轴戏则是PETase,这是一种能降解PET塑料的酶。
QuantaMind对包含17,792个原子的完整体系(PETase蛋白+底物+近5000个水分子)做了6纳秒全程模拟:所有原子由AI直接计算,不预设任何反应路径,完整跑通了酶干活的全过程。
真正难的不是把1.8万颗原子装进计算机,而是让它们连续运动6 ns,并在过程中自然经历质子转移、断键、成键和完整催化循环。
结果与实验高度一致:反应最慢的一步所需的能量,与实验中同类酶的测量区间吻合;其他几步的能量也都能与既有机理研究对上。催化关键的微观结构也被清晰捕捉。
论文还从各阶段随机抽取构型,用量子力学级别的计算方法做验证:吻合度超过0.99。也就是说,AI的判断和量子力学计算几乎完全一致。
以前研究者看反应模拟,往往只能看一张张静态剧照;这一次,QuantaMind直接拍出了一部“催化电影”——1.8万原子、6纳秒、全程不间断,而且是在真正大型、复杂、接近真实生物环境的体系中。
而据分子之心最新披露,这个规模如今已被推到十万原子——是论文中1.8万原子体系的5倍以上,而且单张GPU即可运行,不需要昂贵的超算集群,大幅降低了这类模拟的计算基础设施门槛。
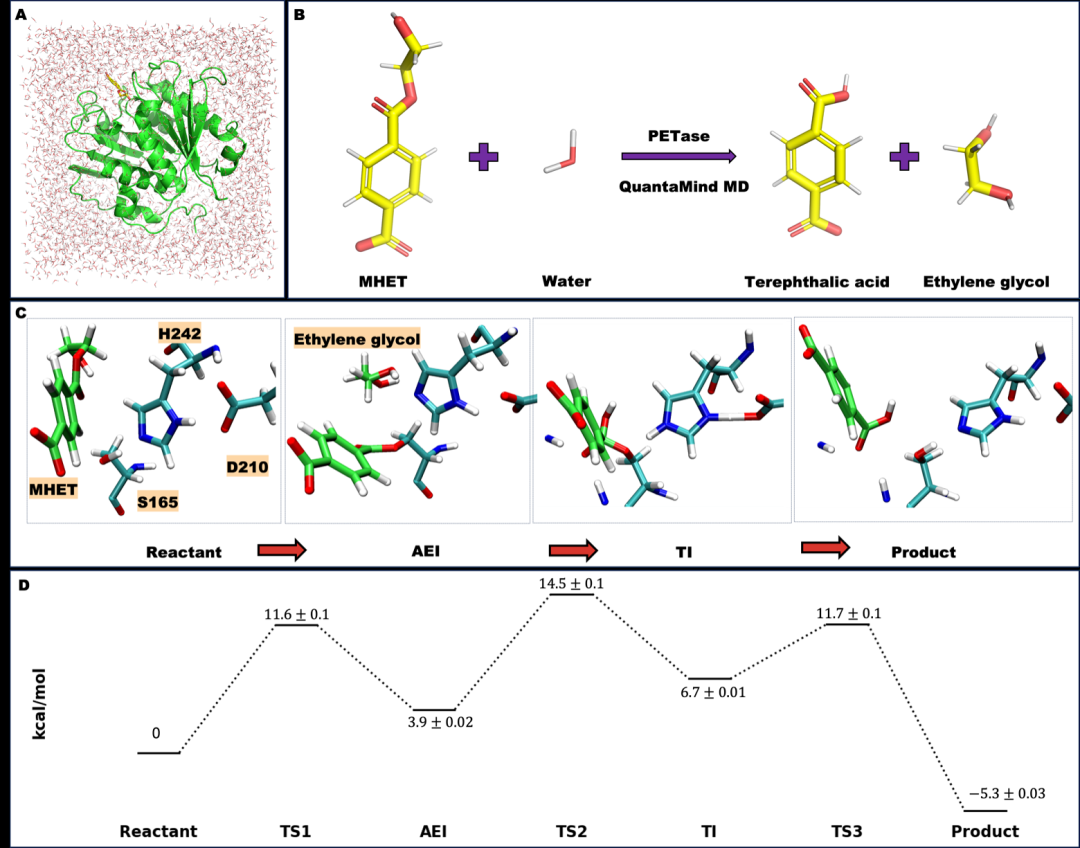
△PETase完整催化循环与自由能剖面(来源:论文原图)
从“折叠”到“反应”:分子之心把AI推向分子动态世界
论文通讯作者许锦波,是公认的“AI蛋白质折叠奠基人”。
2016年他提出的RaptorX-Contact,是全球首个有效的AI蛋白质结构预测算法,后来AlphaFold的早期版本也建立在其核心思想之上。
他创办的分子之心成立于2022年,定位是AI蛋白质设计平台;2026年6月完成A轮系列融资、累计逾亿美元;7月正式开放AI原生的生物经济操作系统MoleculeOS,让生物研发像使用操作系统一样调用AI能力。
如果说过去十年AI改变的是“如何预测和设计分子结构”,QuantaMind所代表的方向,则是进一步让AI进入“结构如何运动、反应如何发生”的动态世界。
加上此前在蛋白质生成、结构预测和从头设计上的积累,分子之心已构建起从“生成-预测-设计-机理理解”的完整技术链路。
在论文基础上,分子之心最新披露:QuantaMind正在把三个边界同时往外推,体系规模从万原子拓展到数十万原子,单张GPU即可运行;模拟时长从数十纳秒延伸到数百纳秒,让更多过去难以完整追踪的分子过程进入可计算范围;计算速度再翻倍,十万原子体系单步计算仅需0.25秒,为更贴近真实研发环境的大型体系提供了计算基础。
团队的愿景很明确:希望能把化学反应的验证,从实验室提前到计算机里。
值得一提的是,QuantaMind的能力不止于论文验证。
在一项延长半衰期的pH敏感抗体设计项目中,QuantaMind辅助设计的候选抗体在pH 6.0下的解离速率达到pH 7.4下的62倍——这样的结果,过去往往需要多轮湿实验筛选才能获得。
在酶工程领域,分子之心也已借助QuantaMind探明多种复杂催化酶的反应机理,锁定关键突变位点,直接指导后续突变选择,缩小湿实验范围。
许锦波这样解释团队的初衷:“QuantaMind希望成为连接分子设计、机制模拟与实验验证的关键基础设施,让过程可追踪、机制可分析、结论可验证,推动建立更加完整、可信的AI分子研发新范式。”
论文原文:https://www.science.org/doi/epdf/10.1126/sciadv.aeg3595
*本文系量子位获授权刊载,观点仅为原作者所有。
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟
科技前沿进展每日见