


ZeroDiff++ 团队 投稿
量子位 | 公众号 QbitAI
零样本学习的目标,是让模型识别训练时从未出现过的类别。
继ICLR 2025论文ZeroDiff之后,其扩展工作《ZeroDiff++: Generative Test-Time Adaptation for Zero-shot Learning》(以下简称ZeroDiff++)已发表于IEEE TPAMI 2026。
新框架继续使用扩散机制缓解少样本训练中的过拟合,并把研究重点推进到测试阶段:让生成器利用真实测试样本适应未见类别,再沿扩散路径生成可追溯的部分合成特征。
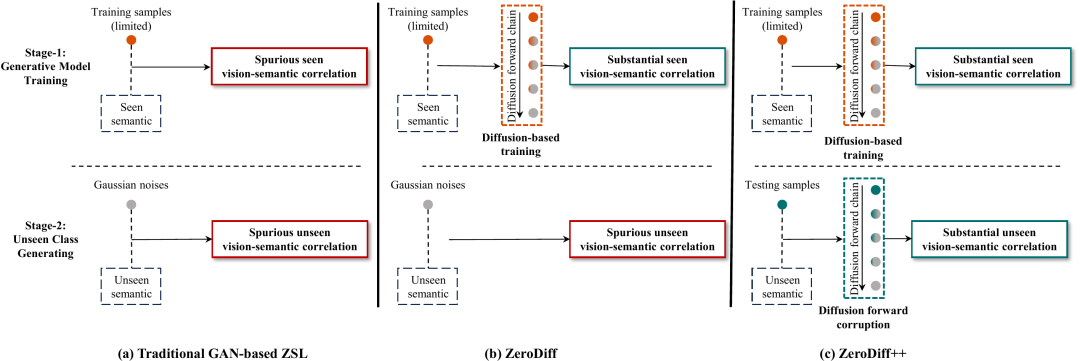
△传统GAN、ZeroDiff与ZeroDiff++的整体思路对比。(论文Figure1)
合成特征看似可分,真实分布依然遥远
生成式零样本学习通常先在已见类别上学习视觉特征与属性、文本等语义之间的关系,再根据未见类别语义合成特征,用这些“虚拟样本”训练分类器。
问题在于,类别语义是静态概括,单张图片却只呈现部分属性;训练样本越少,生成器越容易记住偶然关系。到了测试阶段,传统方法又冻结生成器并从纯高斯噪声出发,合成特征即使类别边界清楚,也可能离真实未见类分布很远。论文把两类偏差统一概括为虚假视觉-语义关联。
论文还用判别器对训练特征、留出的已见类与未见类测试特征的critic score差值观察虚假关联:差距越大,模型越容易把真实测试样本判作“假”。数据越少,两类差距越明显。由此,少样本过拟合与未见类分布断裂被放进同一问题框架。
论文Figure2把五个问题与五项设计一一对齐:训练阶段的有限数据、静态语义、单视角判别,以及测试阶段的不适应生成器、完全噪声生成。右侧可视化显示,训练数据降至10%时,ZeroDiff++仍能生成接近真实分布的特征。
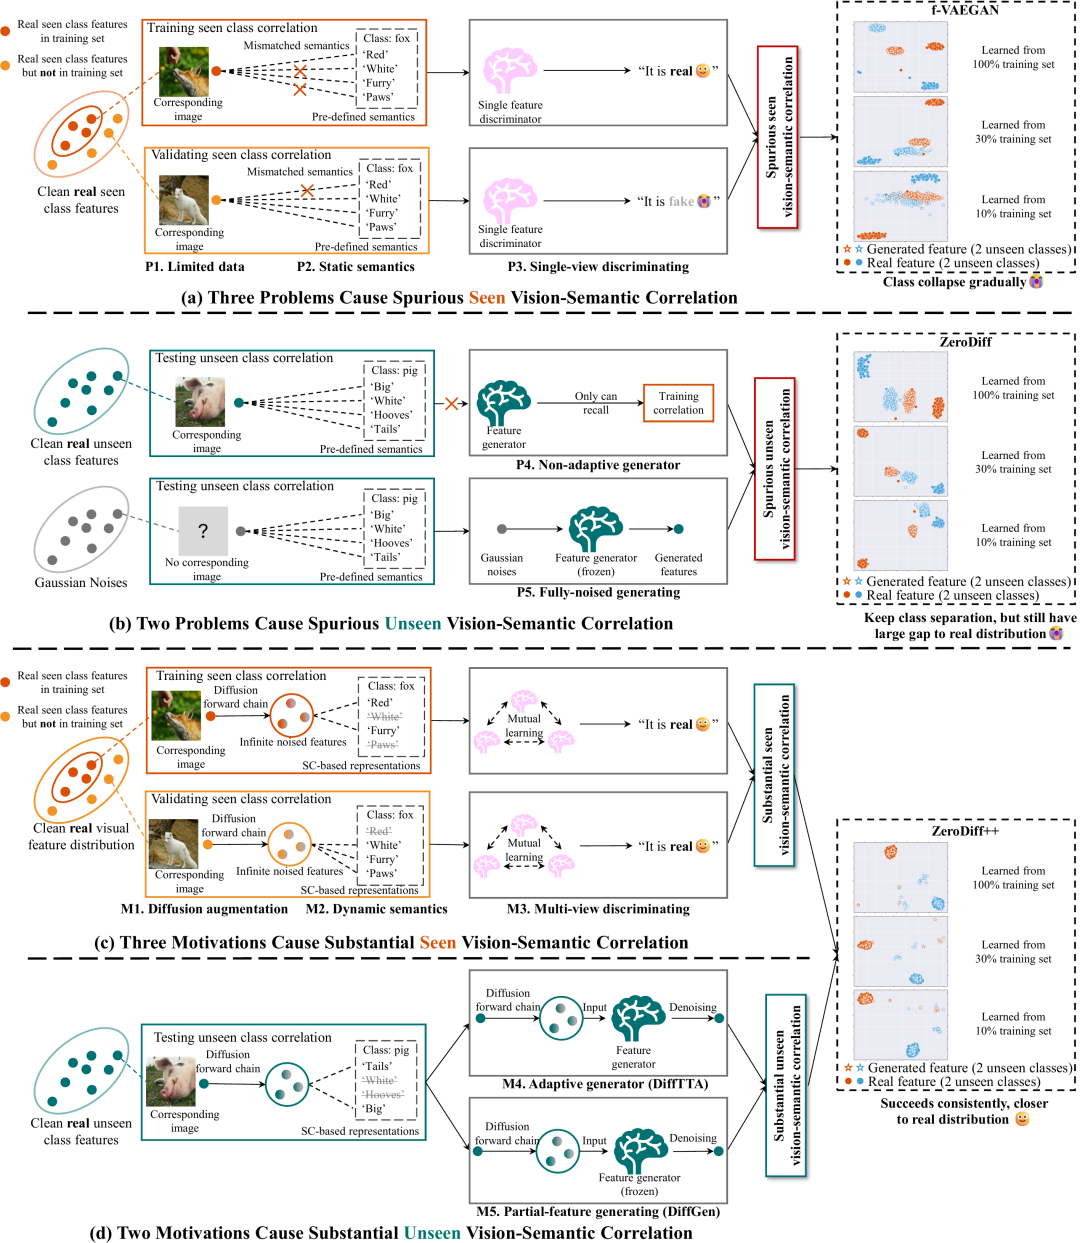
△ZeroDiff++的五个问题与五项对应设计。(论文Figure2)
扩散增强拓展样本,多视角判别加固关联
前三项设计构成ZeroDiff的核心,也是ZeroDiff++的训练基础。它们不是简单“加噪”,而是从数据、语义和判别三个角度共同加固已见类别上的视觉—语义关系。
扩散增强:同一个干净视觉特征经过扩散前向链,可在不同噪声比例下形成大量训练状态,相当于用一条样本构造连续的数据增强轨迹,降低生成器对少量原始样本的记忆。
动态实例语义:预定义属性对同类所有图片完全相同,难以表达个体差异。ZeroDiff++引入监督对比表征,为每个实例提供动态、细粒度的语义条件,让“白狐”和“红狐”不必被同一组静态属性生硬约束。
多视角判别:三个判别器分别检查生成特征是否匹配类别语义、扩散过程和实例级对比表征,并通过基于Wasserstein距离的互学习交换信息。论文还从理论上分析了扩散判别器缓解GAN过拟合的原因。
DiffTTA适应未见类别,DiffGen连接真实与生成
ZeroDiff++的主要新增部分位于生成阶段。传统生成器只见过已见类别,测试时却直接为未见类别造数据;这种“训练完即冻结”的流程,正是生成分布与真实分布脱节的来源。ZeroDiff++通过DiffTTA和DiffGen让真实测试特征进入闭环。
DiffTTA——扩散测试时适应:预分类器先为无标签测试样本给出伪标签及对应语义,扩散生成器再以特征重建为目标,持续向未见类别分布适应;同时保留已见类重建约束,减少适应过程中的遗忘。这里被调整的不是最终分类器,而是负责合成特征的生成器本身。
DiffGen——扩散测试时生成:适应之后,方法不再只从完全噪声起步,而是给一条真实测试特征加入可控噪声,再从扩散链的中间位置去噪。扩散时间t控制真实信息的保留比例:t=0接近重建原样本,t=T退化为传统的完全合成,0< span><>
DiffGen可理解为“以真实样本为草稿的特征想象”。中等扩散时间在复制与完全合成间取得折中:步数太小多样性不足,太大又会引入分布漂移,消融实验也验证了这一点。
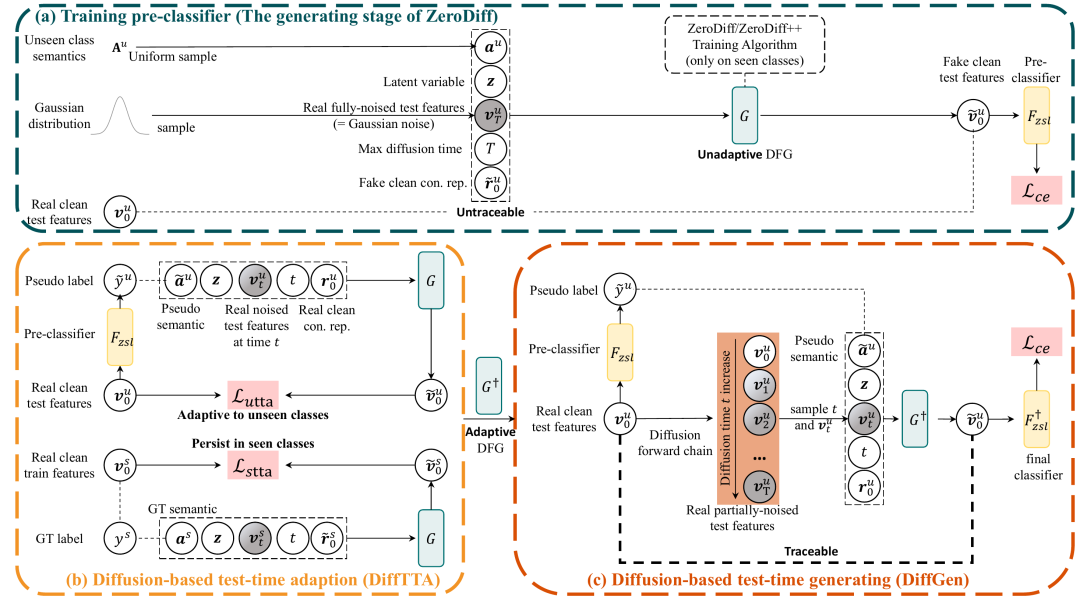
△ZeroDiff++的生成阶段:传统完全噪声生成、DiffTTA与DiffGen。图源:ZeroDiff++论文
真实样本提供生成锚点,扩散路径记录特征来源
由于每次生成都从具体测试特征出发,生成器还能同时接收与该样本配对的实例级对比语义,减少条件语义与视觉输入错配。最终,每个星形生成特征都能沿箭头追溯到某个真实测试特征;这不仅缩短真假分布之间的距离,也为失败样本定位、筛选和误差分析提供了路径证据。
图中的两种颜色代表两个未见类别。沿箭头观察,可以看到生成特征从具体真实样本出发形成连续轨迹,而不是成为无法解释来源的孤立点;一旦某条轨迹偏离类别簇,便能回查其真实起点和中间生成状态。
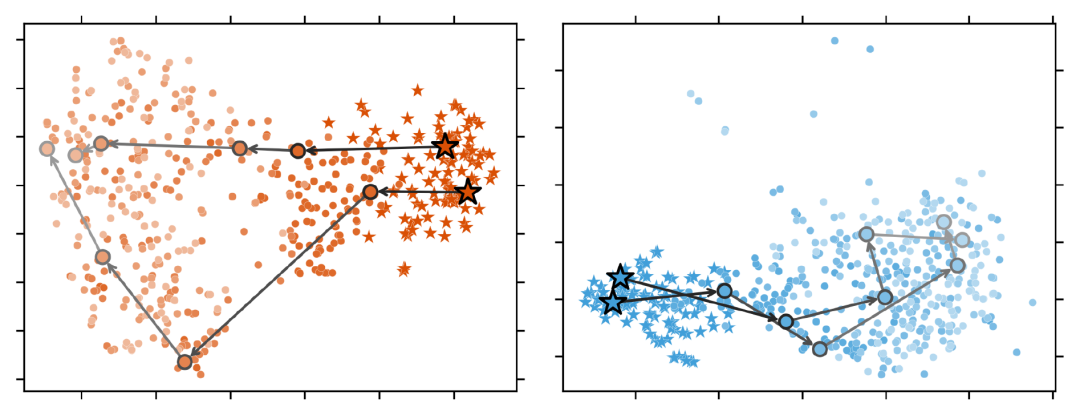
△AWA2两个未见类别上的DiffGen可追溯生成路径。星形为真实特征,圆点为生成特征,箭头连接具体生成轨迹。图源:ZeroDiff++论文
完整训练刷新指标,少量样本保持稳健
在AWA2、CUB和SUN三个基准上,ZeroDiff++的标准零样本准确率分别达到93.5%、87.7%和80.2%,对应ZeroDiff的87.3%、87.5%和77.3%。在更难的广义零样本设置中,模型需要同时识别已见类与未见类;ZeroDiff++的调和平均值H分别达到92.3%、85.4%和69.6%,相较ZeroDiff提升10.9、3.8和9.8个百分点。
尤其在AWA2上,H的两位数提升说明改进并非单纯偏向未见类,而是同时保持了已见类与未见类之间的识别平衡;这正对应了ZeroDiff++在测试阶段缩小真实—生成分布差距的设计目标。
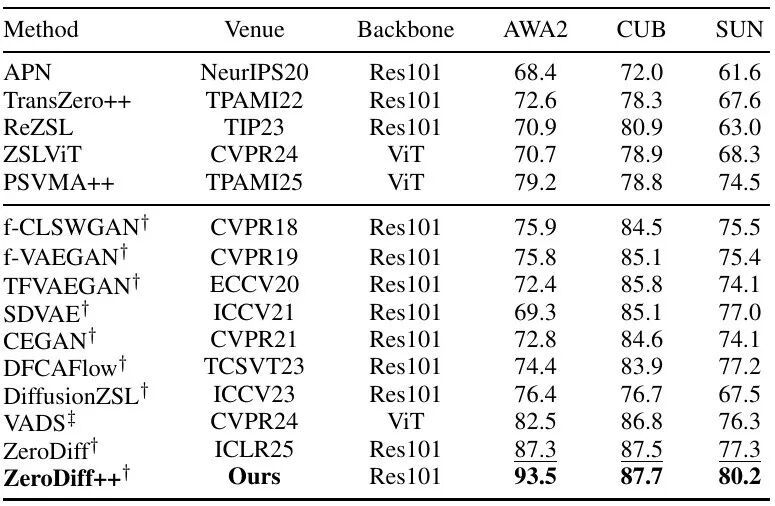
△标准零样本学习结果(论文Table I),粗体行为ZeroDiff++。
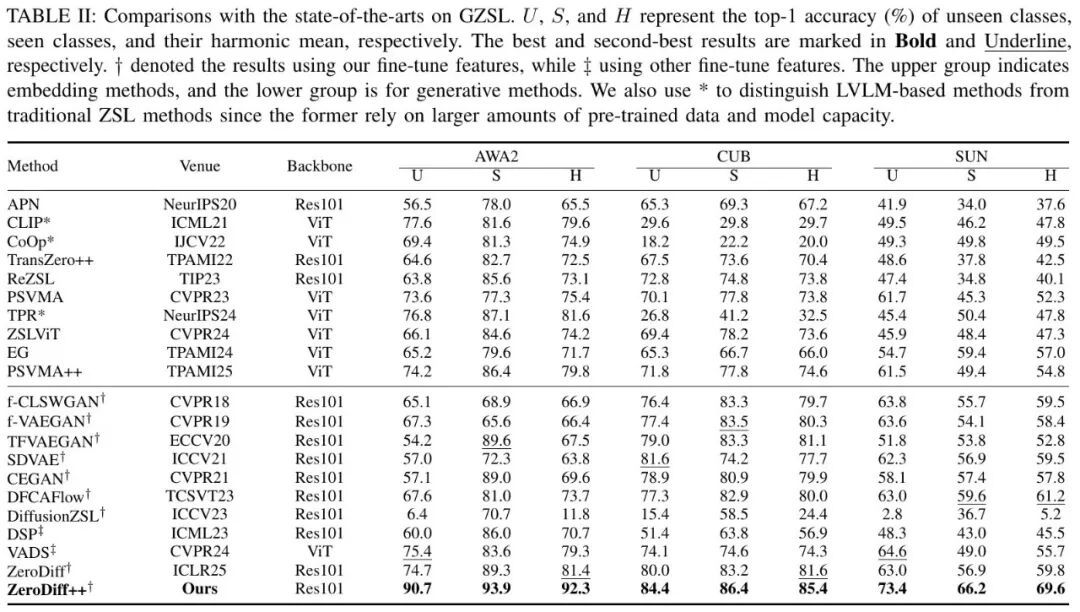
△广义零样本学习结果(论文Table II),U/S/H分别表示未见类准确率、已见类准确率及其调和平均值。
数据越少,框架的优势越直观。只使用10%已见类训练样本时,ZeroDiff++在AWA2、CUB和SUN上的广义零样本H仍达到92.0%、77.3%和41.0%。推理方式对比进一步显示:不开启DiffTTA时,DiffGen在三套数据上的标准零样本准确率已达92.9%、87.0%和80.0%,AWA2的H为88.0%;开启DiffTTA后,AWA2的未见类/已见类准确率达到90.7%/93.9%,H提升到92.3%。
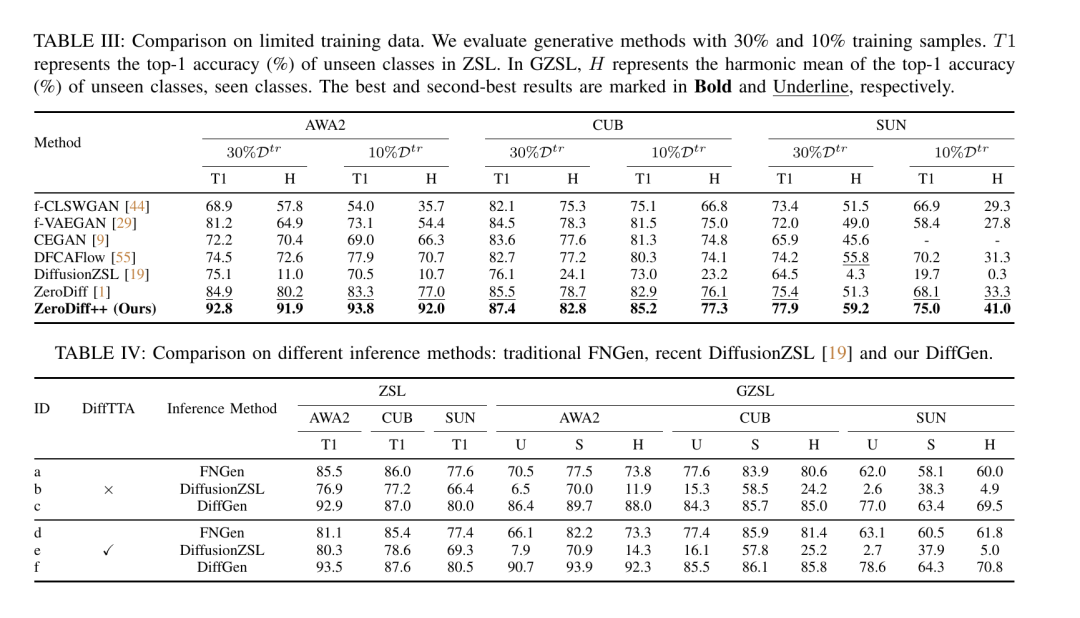
△少量训练数据与不同推理方式的对比(论文Table III、IV)。
指标提升验证效果,生成路径支持回查
ZeroDiff++的价值不只在指标。它把扩散过程从训练增强工具变成测试阶段连接真实样本与生成特征的可控路径,为生成式零样本学习增加适应性和可追溯性。DiffTTA仍依赖伪标签质量;论文显示过滤高熵样本可继续改善结果,未来也可结合伪标签校正和不确定性加权。
作者:Zihan Ye(1)、Shreyank N Gowda(2)、Kaile Du(3)、Weijian Luo(4)、Ling Shao(1,*)(通讯作者)
研究机构:(1)中国科学院大学工程科学学院;(2)诺丁汉大学计算机科学学院;(3)东南大学;(4)小红书Hi Lab
ZeroDiff++(TPAMI 2026)论文:https://ieeexplore.ieee.org/abstract/document/11672276
ZeroDiff(ICLR 2025)论文:https://proceedings.iclr.cc/paper_files/paper/2025/file/9796170d31d42b943534df40bdee68d3-Paper-Conference.pdf
个人主页:https://fouriye.github.io/
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
【学术投稿】请在工作日发送邮件至:ai@qbitai.com,标题注明【投稿】,并告诉我们:你是谁,从哪来,投稿内容附上项目/主页链接,以及联系方式。
🎓 我们会 (尽量) 及时回复你 :)
🌟 点亮星标 🌟
科技前沿进展每日见