


CEDAR 团队 投稿
量子位 | 公众号 QbitAI
真实世界的时间序列,不仅被外部事件冲击,也被人为决策持续重塑。
来自中科大和阿里巴巴的研究团队提出CEDAR“双重解耦”建模框架:动作交错Transformer显式刻画人为决策对序列的影响,残差修正模块实现外界干预因子的语义融合。
研究团队在阿里1688约3200万条商品轨迹上验证了方法的有效性,预测误差较最优基线降低超57%,线上A/B测试带来商家LTV提升13%、店铺ROI提升15%。
从一个“答不上来”的问题说起
以1688平台上的一位商家为例,月底需要制定下季度的营销规划。商家打开数据后台,提出了一个自然的问题:
“如果商家在接下来三周将广告预算提高50%,同时打九折,销量会变成什么样?”
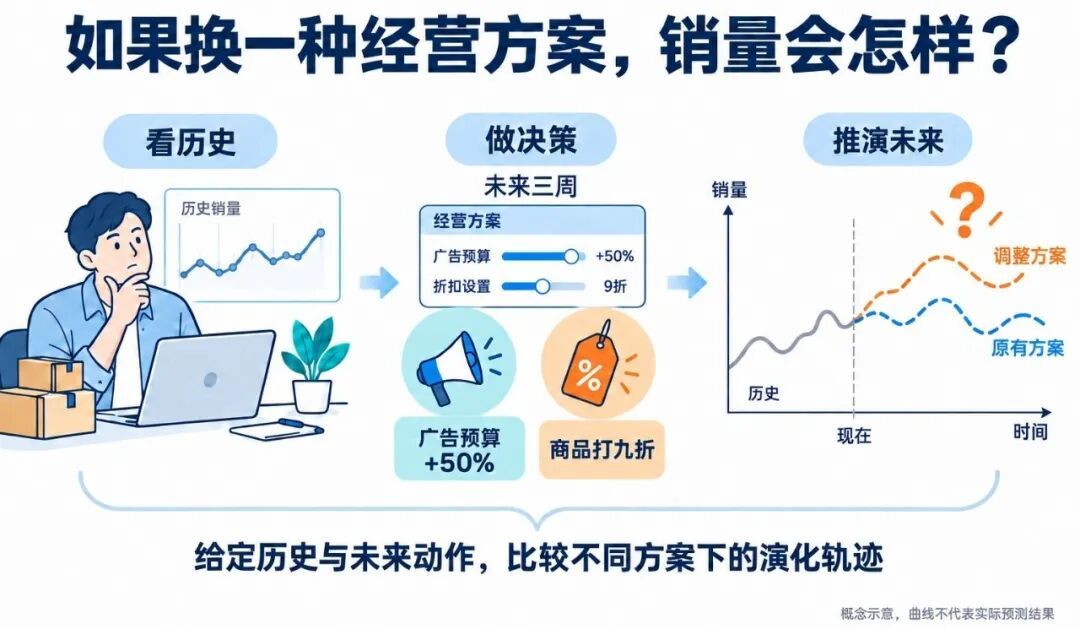
△决策条件模拟示意:给定历史与未来动作,比较不同经营方案下的需求轨迹
遗憾的是,市面上绝大多数时间序列预测模型都答不上来。它们能做的是另一件事——看着历史曲线告诉商家“照这个趋势,下周大概卖这么多”。至于商家“打算做什么”,它们要么视而不见,要么只是把商家的决策当作一个普通特征拼进输入,学出一堆相关而非因果的规律。
这个问题并不局限于电商。在能源调度、交通管理、金融投资等场景中,决策者真正需要的往往不是“预测未来会发生什么”,而是“如果采取这套行动方案,未来会发生什么”。研究团队将这类问题形式化为决策条件模拟(decision-conditioned simulation):给定历史状态与一套未来的动作序列,推演时间序列在该方案下的演化轨迹。
这正是KDD’26研究成果CEDAR(Controlled and Event-Driven Demand Forecasting via Residual Decomposition)要解决的核心问题。研究团队认为,它的本质是外界干预与人为决策双重影响下的非平稳时间序列建模——而现有方法恰恰在这两个维度上都存在结构性缺陷。
问题的本质:非平稳性的两个来源
为什么传统模型做不好决策条件模拟?症结可以分为两层,它们恰好对应这类序列的两个非平稳来源。
来源一:人为决策的影响被“平均”掉了。传统的协变量建模(如TFT)把人为决策(调价、投放、调度指令)和历史观测拼在一起喂给模型。模型学到的是历史数据里“决策和序列通常一起出现”的相关性,而不是“决策驱动序列变化”的因果机制。结果就是自回归惯性:模型倾向于沿着历史趋势外推,对反事实的新决策方案极不敏感——商家明明加大了投放,它却还在按老剧本走。
来源二:外界干预与决策效果被“搅”在一起。真实序列随时会被外生事件扰动:突发热点、节假日、天气变化、宏观冲击。如果不把这些外界干预与决策效果分离开,模型就会“张冠李戴”——把一次外部热点带来的暴涨错记在人为决策头上,进而给出灾难性的决策建议。
打个比方:开车时车速的变化,既可能来自驾驶者踩油门(人为决策),也可能来自突然下雨(外界干预)。一个靠谱的车速模拟器,必须把这两件事分开建模,否则无法回答“驾驶者再多踩一点油门会怎样”。
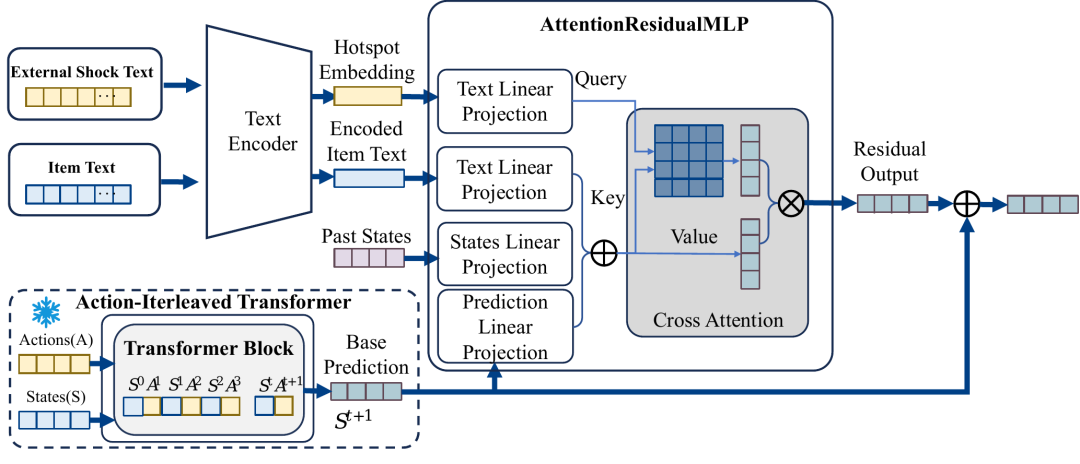
△CEDAR整体框架:左侧为动作交错Transformer(Stage I),右侧为残差修正模块(Stage II)
CEDAR的整体设计:一次“双重解耦”
针对上述两个来源,CEDAR的设计哲学非常清晰——既然序列的生成过程天然由两部分组成,那就用两个模块分别建模、分阶段训练:
最终预测=人为决策条件下的基础推演+外界干预驱动的残差修正
核心点一:显式建模人为决策对时间序列的影响——动作交错Transformer(AIT)学习决策条件下的状态转移算子;
核心点二:外界干预因子的语义融合——残差修正模块借助大模型提取外部事件信号,并修正其引发的序列偏移。
两阶段解耦训练还带来一个额外好处:决策条件动态在策略漂移下保持稳定,而残差模块可以灵活适应非平稳的外部环境。消融实验也证明,一阶段联合训练的效果明显更差。
核心点一:显式建模人为决策对时间序列的影响
这一阶段的核心是动作交错Transformer(Action-Interleaved Transformer,AIT)。它不再把决策动作当成附属特征,而是把状态S和动作A都视为“一等公民”的独立token,按照真实的因果顺序交错排列:
上一期状态→本期决策→本期状态
(s(t-1)→a(t)→s(t))
这个顺序大有深意:现实中,决策者总是观察到上一期的系统状态后才做出本期决策,而本期决策又驱动了本期状态的转移。把这种因果时序直接编码进序列结构,相当于赋予模型一种结构性归纳偏置,让注意力机制显式对齐“决策→状态转移”这条影响通路,从而学到真正可控的动态机制。
这一思路受到Decision Transformer等离线强化学习工作的启发,但目标不同:DT类方法学的是“什么策略最优”,而CEDAR学的是可控的状态转移算子——不求给出唯一最优策略,而是能稳定地推演任意候选决策方案下的未来轨迹,供决策者比较和挑选。这正是What-if分析的关键能力。
核心点二:外界干预因子的语义融合
决策条件动态管不了的事,交给第二阶段。残差修正模块专门捕捉那些从历史状态—决策轨迹中推不出来的外生扰动,做法颇有巧思:
大模型当“信息过滤器”:每周从小红书、抖音等平台的热搜榜单中,用LLM(Qwen-Plus)滤掉娱乐八卦等噪声,只提取可能引发需求变化的商品关键词;
大模型再当“市场分析师”:把这些关键词与未来时间窗内的26个节假日/购物节信息,合成为一段连贯的市场描述文字;
文本编码器转向量:用BGE-zh-v1.5把这段描述编码成“热点嵌入”;
交叉注意力做“精准匹配”:以热点嵌入为Query,商品文本与历史状态为Key/Value,动态对齐“哪个事件会影响哪个对象”。
第4步是点睛之笔。举个生动的反例:圣诞帽的需求不太可能因为春节而暴涨——同样是节日事件,对不同对象的影响天差地别。简单MLP对所有协变量一视同仁,而交叉注意力能显式建模外界干预与具体对象之间的相关性,把事件的影响精确地“投放到”该影响的序列上。
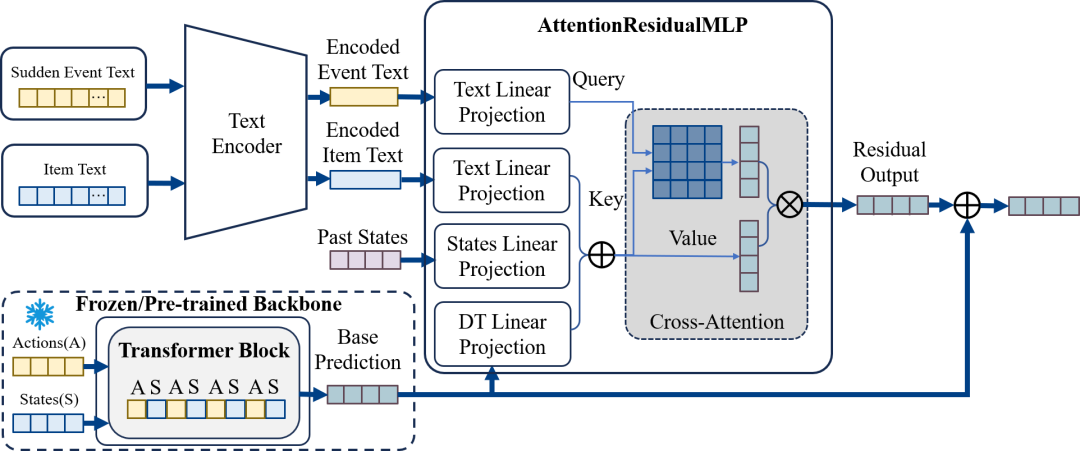
△残差修正模块(AttentionResidualMLP):热点文本经编码后通过交叉注意力与商品上下文对齐
最终,每个时间步的预测值=AIT的基础推演+残差模块的事件修正,再以自回归方式滚动多步,实现长horizon的稳定模拟。
在阿里1688上的应用与验证
研究团队将CEDAR应用于阿里1688平台的商家需求预测与预算规划场景。作为国内最大的B2B批发平台,1688为研究决策条件预测提供了独特的真实环境。
数据集:研究团队构建了E-Comm15-Week数据集,约3200万条商品轨迹,横跨2024—2025年,覆盖8942个细分类目。每条轨迹包含9个状态指标(曝光、浏览、收藏、加购、买家数、GMV、广告曝光、广告点击、询盘数)和2个决策变量(营销折扣率、广告花费),以15周为窗口切片。研究团队也在推动该数据集的脱敏开放,希望为社区提供一个动作感知序列建模的大规模基准。
主实验(对比Informer、TFT、PatchTST、PETFormer、Timer-XL五个基线,5次随机种子取均值):
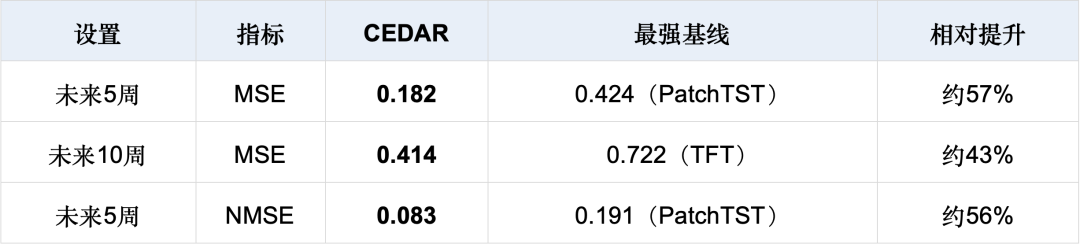
△主实验结果:CEDAR在全部指标与预测窗口上均为最优
差距在经典模型身上体现得淋漓尽致:Informer在next-10设置下MSE高达32.2,几乎完全失效——这正是“决策盲”模型在决策驱动的分布偏移下的必然结局。
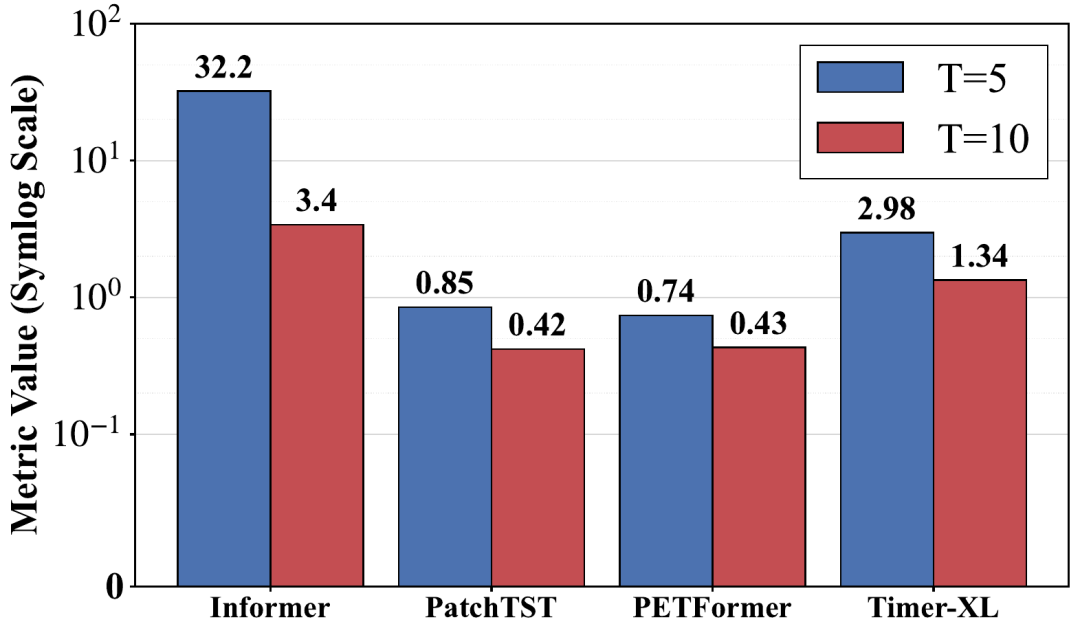
△各模型预测误差对比(纵轴为对数尺度,越低越好)
决策敏感性实验更能说明核心点一的价值。商家在第5周和第12周分别启动两轮广告投放:把决策当协变量的基线们反应迟钝,仍在按历史流量峰值外推;只有CEDAR敏锐地捕捉到了广告预算削减后的流量下行趋势,而不是盲目延续历史模式。
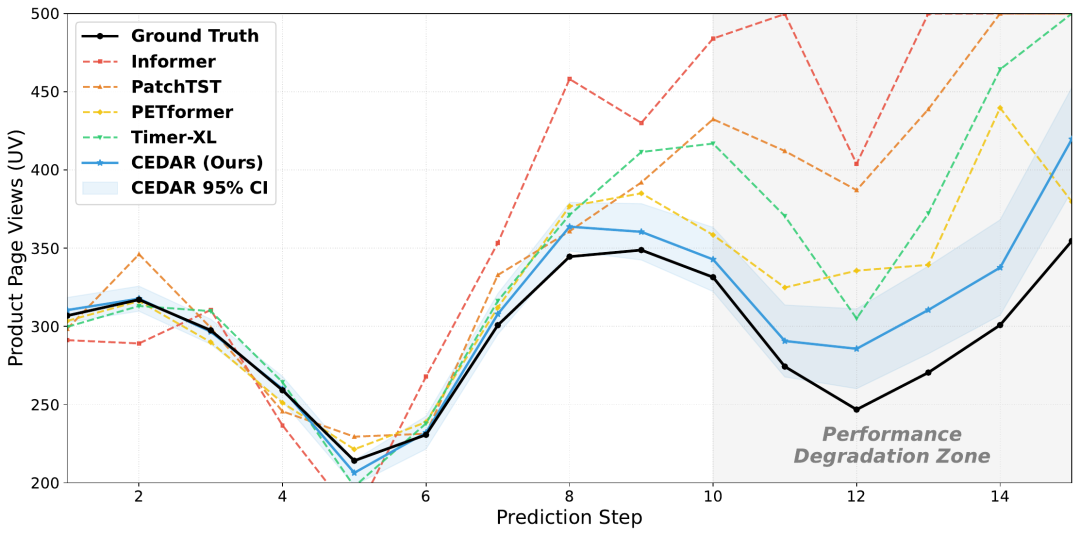
△两轮广告投放下的流量推演:只有CEDAR正确预判了预算削减后的下行趋势
外界干预建模的效果(核心点二),一个真实案例足以说明:社交媒体上“奶皮子糖葫芦”突然爆火,某糖葫芦供应商需求骤增。没有事件建模机制的基线们集体“踏空”;而CEDAR的残差修正模块成功从热搜和外部热点中提取出“糖葫芦”等关键词,准确预判了这次流量暴涨。更有意思的是“时间打乱”消融:把节假日和热点信号随机分配到其他日期后,模型性能反而比不加事件还差——说明CEDAR真正学到的是事件与需求在时间上的对齐关系,而非把事件嵌入当万能味精。
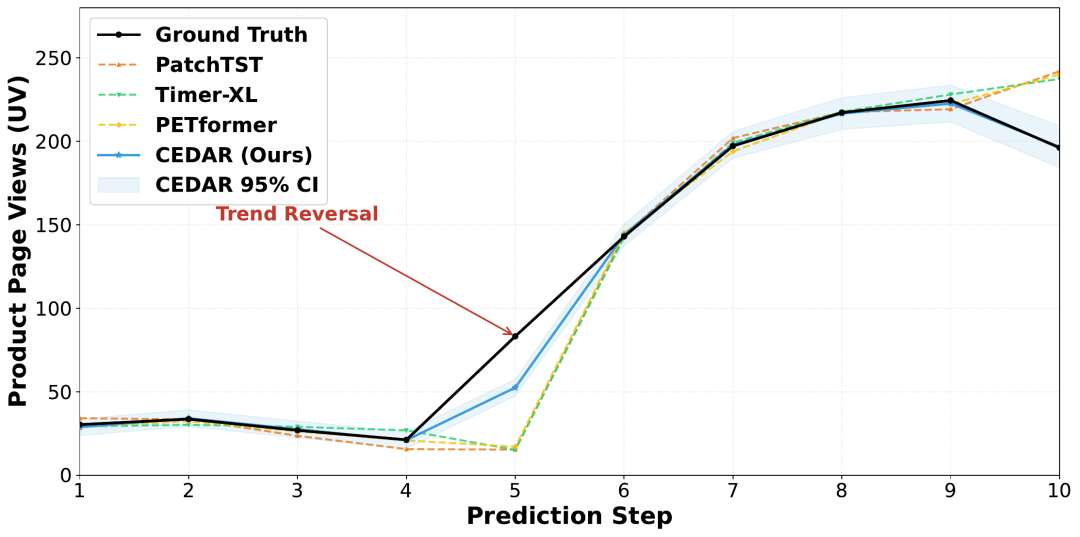
△“奶皮子糖葫芦”爆火案例:CEDAR成功捕捉趋势反转,基线集体踏空
长程模拟同样稳健:一直预测到未来25周,CEDAR的MSE为1.612,显著低于PatchTST的2.847和PETFormer的2.561——误差随步长累积得更慢,这对需要中长期推演的规划类场景至关重要。此外,CEDAR在公开的Kaggle StoreSales数据集上同样全面领先(MSE 0.5819vs最优基线0.6321),证明“决策条件建模+外界干预残差”的解耦范式具有普适性。
几个值得玩味的设计细节
为什么不加时间戳embedding?研究团队尝试后发现时间embedding与从文本提取的突发热点语义难以对齐,还徒增学习难度。而且节假日的需求波动已经被残差修正模块覆盖,再加时间戳收益甚微——这个“减法”的判断很务实。
残差模块的另一重价值:保持轨迹多样性。没有它,同一细分类目下的对象会得到高度雷同的预测曲线;有了它,个体所受的独特外部影响被重新注入,推演更真实。
因果视角的理论支撑。研究团队在论文附录中从结构因果模型(SCM)出发,把系统形式化为加性噪声模型:AIT近似干预分布、残差模块显式建模外生项以阻断后门路径,从结构上保证了反事实模拟时的不变性。这让CEDAR不只是工程trick的堆叠,而是有清晰的因果语义。
结语
CEDAR的价值,不在于又刷了一个预测榜单,而在于它重新定义了问题:在决策密集、外部扰动频繁的真实场景中,时间序列建模的终点不是“看清未来”,而是“比较不同行动方案下的未来”。把人为决策建模为一等模态、把外界干预从可控动态中剥离——这“双重解耦”的两步走得干净漂亮,也都被大规模真实数据和线上实验扎扎实实地验证了。
研究团队认为,这套范式适用于所有“人为决策×外界干预”双重驱动的非平稳序列场景。对业务方而言,这意味着规划从“凭经验拍脑袋”走向“先推演再决策”;对研究者而言,“决策条件模拟”这个问题本身,以及3200万条带决策—事件对齐信号的真实轨迹,都值得更多关注。
论文标题:CEDAR:Controlled and Event-Driven Demand Forecasting via Residual Decomposition
论文链接:https://arxiv.org/pdf/2608.25871
发表:KDD’26,2026年8月9-13日,韩国济州岛
作者:Junjie Meng,Ranxu Zhang,Zi-an Zhang,Shujun Liu,Xiaoning Qi,Xiaozhou Xu,Yanyong Zhang,Hui Xiong,Chao Wang(通讯作者)
机构:中国科学技术大学、阿里巴巴、香港科技大学(广州)/香港科技大学
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
【学术投稿】请在工作日发送邮件至:ai@qbitai.com,标题注明【投稿】,并告诉我们:你是谁,从哪来,投稿内容附上项目/主页链接,以及联系方式。
🎓 我们会 (尽量) 及时回复你 :)
🌟 点亮星标 🌟
科技前沿进展每日见