

昇腾910C超节点已部署超1000套;业界首个使用NPO的昇腾960超节点发布;鲲鹏全球开发者超过了416万……华为全联接大会2026今天在上海启幕,华为副董事长、轮值董事长汪涛在“智启新未来,打造智能世界的硅基黑土地”主题演讲中透露了“超节点+集群”的最新情况。
今天,AI变革的速度超过历史上任何一次技术革命。大模型参数已经快速迈向10万亿,到2030年将达到100万亿以上;智能体已经可以按小时级连续工作,到2030年将以月为单位执行任务;中国每日推理Token已增长到每日500万亿左右,到2030年将达到百万万亿级。端侧智能也在快速增强,手机模型从2024年的3B发展到今天的30B,未来将进一步走向100B级。这些变化,都对AI基础设施的规模、性能和可靠性提出了更高的要求,只有打造更加强大的AI基础设施,才能筑牢智能世界的坚实底座。
汪涛表示,华为坚持聚焦AI基础设施,打造智能世界的硅基黑土地。华为AI战略的核心是算力,坚持硬件变现,围绕“超节点+集群”,通过系统架构创新构建竞争力,打造中国坚实算力底座,为世界构建新的选择;坚持构建开源开放的算力生态,支持主流大模型基于昇腾原生训练、积极拥抱“百模千态”。
超节点已成为产、学、研共识
2026年,国产算力领域最火的关键词非超节点莫属。步入AI时代之后,将多颗GPU所处的服务器“融合”成一台超级计算机,这就是超节点如今正在做的事。
在此前的WAIC2026期间,华为现场亮相的超节点成为“打卡”地,汪涛在会上透露,截至目前,昇腾910C超节点已部署超1000套,昇腾950超节点也已规模商用。超节点在规模商用的同时,已成为产、学、研在AI基础设施领域的共识。
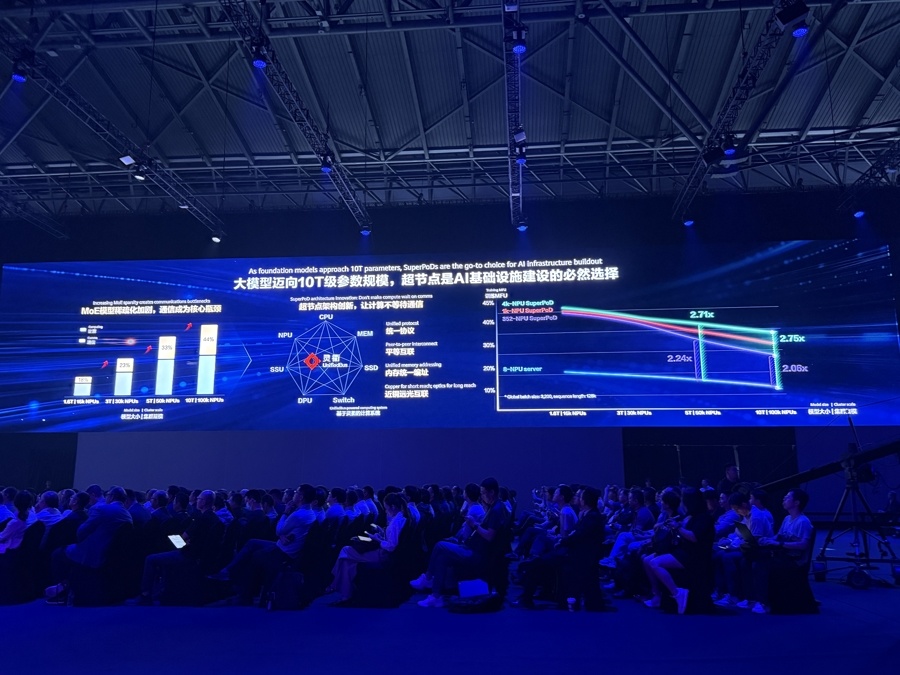
汪涛认为,超节点已成为建设超大规模AI基础设施的必然选择。当前,10万卡集群已成为训练十万亿级SOTA模型的标配,但传统服务器架构导致集群内通信超过训练时间的40%,严重制约了MFU(模型浮点算力利用率)。华为马尔科夫实验室仿真结果显示,4K超节点组成的10万卡集群相比由8卡服务器组成的10万卡集群MFU提升了2.75倍。
发布业界首个使用NPO的昇腾960超节点
在所有芯片中,昇腾芯片是整个系统中的核心部件,现场,华为宣布昇腾960芯片研发进度超出预期,性能实现倍增。960DT比原计划提前三个季度,2027年第一季度就绪;960PR比原计划提前一个季度,2027年第三季度就绪。
未来,昇腾系列芯片将持续坚持一年一代的演进节奏。2028和2029年,华为将陆续推出昇腾970、980芯片,依托τ定律的创新方向,实现算力规格继续翻倍,访存带宽、访存容量、互联带宽等也将大幅提升。
除了昇腾芯片以外,华为还基于灵衢UnifiedBus打造了系列化套片,全面覆盖计算、互联、存储、管理等关键能力。
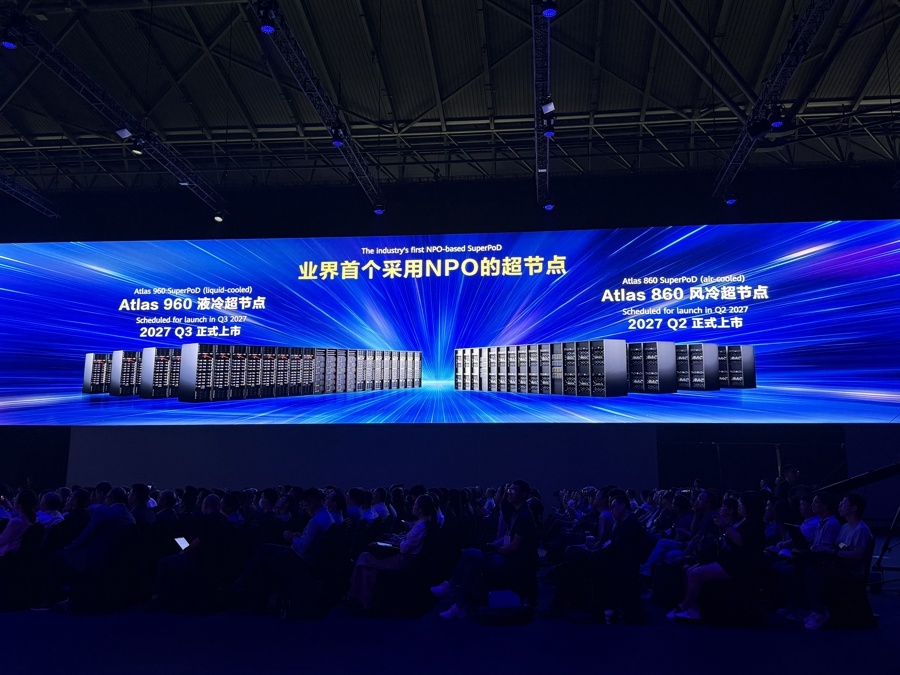
超节点的设计理念是通过互联实现多NPU的协同。华为研发了新一代NPO(Near-Packaged Optics)形态的光互联产品——Hi-ONE,基于华为自主创新技术,通过光、机、电、磁、热等要素的均衡设计,实现了单引擎7.2T的传输容量。这是业界首个量产的NPO产品,是行业目前最大传输能力的NPO产品,也是唯一实现内置光源的NPO产品。同时,华为在全球光互联标准组织OIF提出了NPO标准立项的建议,得到了众多行业伙伴的积极响应,进一步完善NPO的产业生态。
基于昇腾960芯片和Hi-ONE,华为打造了业界首个采用NPO技术的超节点——昇腾960超节点,单个超节点为4096卡规模,最大可提供8E FP8的算力,高达1PB的HBM容量。超节点中用5500个Hi-ONE,替代原本需要的4万8千颗800G光模块,降低了超550千瓦功耗,系统无故障运行时间提升一倍,系统可用度达到99.8%。
鲲鹏超节点与AI记忆存储亮相
随着SOTA模型的参数规模达到10T级,其训练、推理系统不再是单一的AI服务器或单一的智算超节点,而是一个复杂的算力系统。该系统包括智算超节点、通算超节点、一套平等互联且免协议转换的互联系统,在推理系统中还需要部署PB级的KV缓存集群。
首先,鲲鹏超节点全新升级。基于灵衢全光组网,鲲鹏超节点最大支持4096节点,并形成高达256TB的统一内存池,可显著加速Agent性能。在Agent沙箱场景,十万级别沙箱启动相比传统服务器方案提升30倍,且沙箱密度还可以再提升25%;在Agent向量检索场景,在百亿千维的复杂向量检索场景下,检索效率比传统服务器性能实现倍增。
其次,华为基于灵衢打造AI记忆存储-OceanStor M900。Agent与长序列需要多层次KV Cache架构,面向Agent推理系统,华为提出了多层KV缓存架构,推出基于灵衢UnifiedBus、支持“一跳直连”的华为L3.5层PB级KV缓存——OceanStor M900集群。同时,M900采用混合介质加优化Retention算法,可将SSD读写寿命提升16倍,从底层保障KV命中和长稳可靠。
同时,华为发挥“计算+通信”综合优势,为业界带来全新的Agentic超节点集群,加速10万亿大模型训练和推理。基于灵衢UnifiedBus统一互联,把多种互联协议统一为灵衢协议,大幅减少协议转换开销,实现昇腾超节点、鲲鹏超节点、KV缓存集群等子系统平等互联,提供多层次、高带宽、大容量的存储系统,且各类KV缓存均可一跳直达的KV缓存。通过二层CLOS四平面组网,最大集群规模可达到51.2万卡,再结合多轨道拓扑技术,最大可支持100万卡昇腾超节点集群。
构建开源开放的算力生态是核心战略
鲲鹏生态引领千行百业数智化创新。截至目前,鲲鹏全球开发者超过了416万,全球生态合作伙伴超过7200家,支持了560多个全球开源项目,openEuler装机量也已超过2000万套,成为中国服务器操作系统第一份额。
昇腾已跨越生态拐点。CANN作为昇腾生态的根基,已进入常态化的开源社区运作,从“可用”走向“易用”。CANN外部开发者首次超越内部开发者,占比61%,社区月活开发者突破5200名,是中国最活跃的开源社区;基于昇腾+CANN的原生训练模型已超过40个,也是国内唯一支持预训练的技术路线;昇腾已覆盖90多个主流三方社区,如PyTorch、Triton、vLLM、veRL等。在Linux基金会的大力支持下,昇腾已正式成为在 PyTorch 官网可直接安装的算力平台,并且是首个来自中国的算力平台,全球所有开发者可以更便捷地获取昇腾生态的创新成果。