


算力的故事已经讲完,数据的故事才刚刚开始。AI下半场拼的不是谁的模型大,而是谁能把企业沉睡的数据变成AI的燃料。万亿级新基建的门,正在为敢撕掉旧标签的人打开。

原创ⓒ科技新知 AI新科技组
作者丨凤梨 编辑丨九黎
过去两年,所有人都在聊大模型、聊算力、聊GPU。但直到现在为止,世界上还有近70亿人从未使用过生成式AI工具,长江商学院调查显示,足足有90%的企业没有在生产环节使用AI。
个人没有使用,可以理解为认知缺失或者是需求不足,但企业在这个AI能力早已溢出的时代,仍然有个很重要的问题没办法解决:到底该怎么把自己的海量业务数据,喂给嗷嗷待哺的大模型?
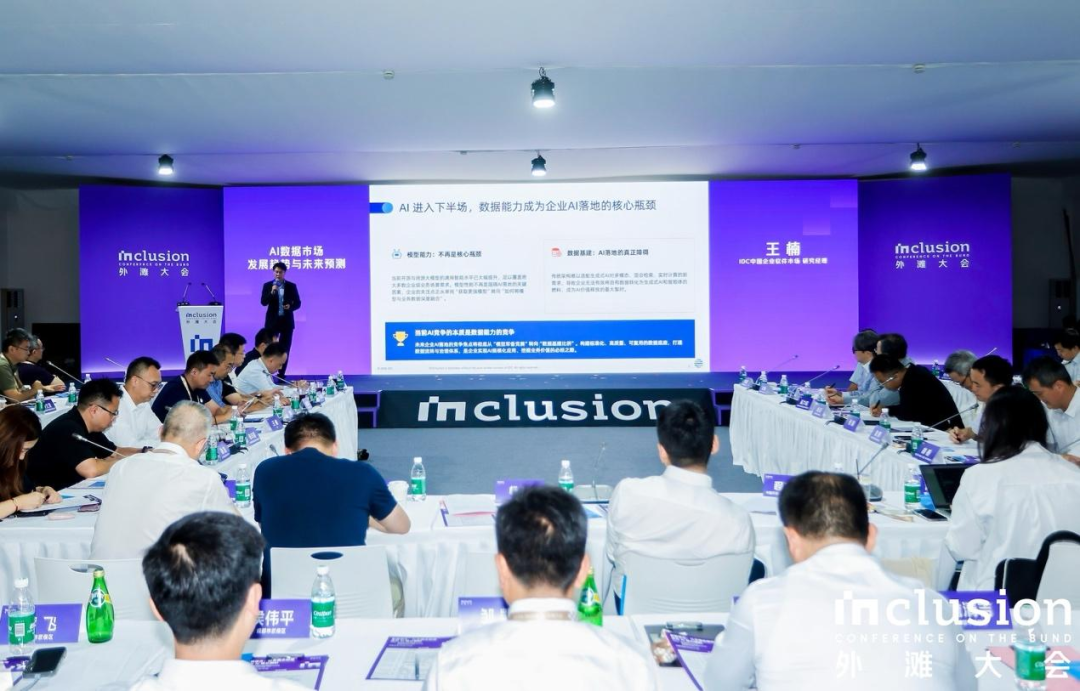
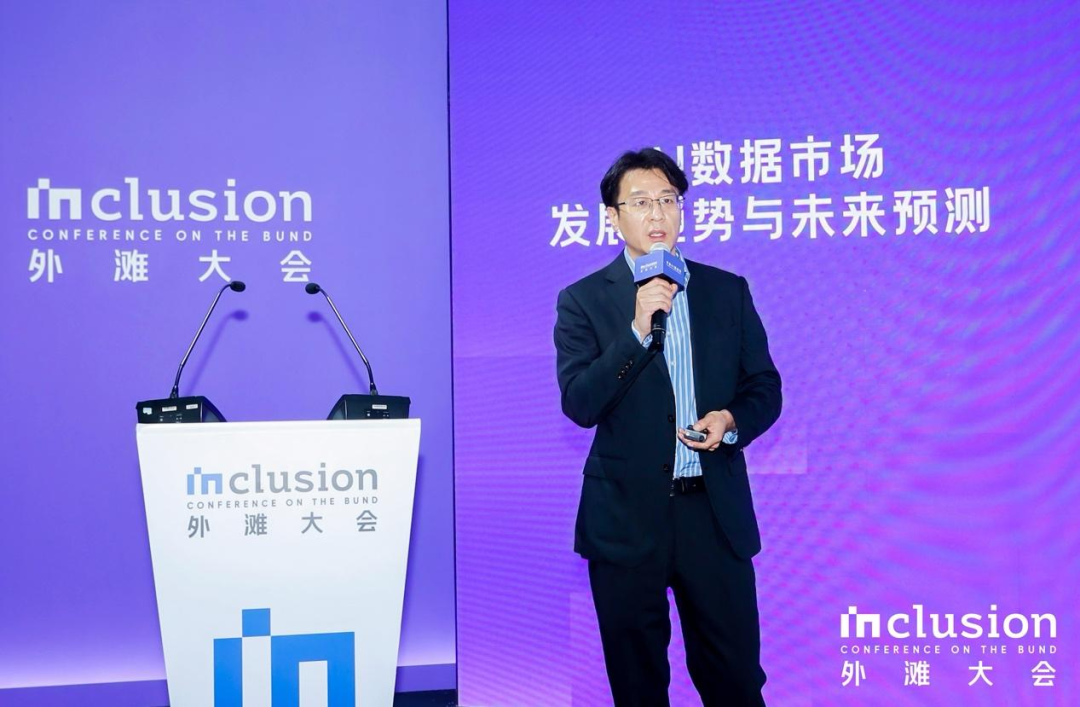
9月外滩大会上,IDC抛出一个判断:AI上半场拼模型和算力,下半场拼数据基础设施。这句话的背后,既是一个从百亿级跃升到万亿级的新市场,也是一批公司估值坐标的集体切换。
01
打破算力迷信:多模态数据洪流,倒逼万亿新基建
今天的人工智能赛道,正面临着一种诡异的消化不良。如果把大模型比作一台拥有顶级V8引擎的超跑,算力决定了这台车的理论极速,那么企业自身的数据,就是让这台车跑起来的高纯度汽油。
遗憾的是,目前大多数企业油箱里装的,不仅杂质极多,而且根本无法通过现有的输油管道直接加进AI的引擎里。
IDC最新发布的预测数据显示:未来五年,中国的数据生成量将从2025年的76ZB,以惊人的速度飙升至2030年的147ZB。然而,在这些企业新生成的海量数据资产中,约有90%都是非结构化数据,也就是图片、音视频、无格式文档以及复杂的交互日志。
想象一下如今企业真实的AI落地场景:当一个智能客服Agent试图为一个高净值客户解决问题时,它不仅需要瞬间读取结构化的账户余额,更需要实时检索长达几十页的PDF产品手册、跨越数年的历史客服语音通话记录,以及散落在各个部门系统里的非结构化交互日志。
这就导致了一个极其尴尬的局面:企业花重金购买了算力,部署了最先进的大模型,但因为底层的路径依然是上个时代的遗留,最终AI得到的数据依然寥寥无几。这种数据处理能力的严重脱节,正在成为制约企业数字化转型的最大短板。换而言之,大模型饿肚子,不是因为企业没有数据,而是因为现有的基础设施根本喂不进去。
这就意味着,单纯的、以存储和简单查询为目的的传统数据库,已经无法满足AI时代的需求,一场席卷底层数据设施的换代浪潮已经到来。
这里的市场跨度有多大?根据沙利文的数据,中国传统分布式事务型数据库市场的整体盘子,大约维持在141.7亿人民币左右;而根据IDC的预测,随着AI对数据底座的重塑,到2035年,中国AI数据基础设施将长成一个约1万亿人民币的超级赛道。一边是百亿级的传统存量市场,一边是万亿级的AI数据基础设施新赛道。这不是大家想象中同一个池子的自然扩容,而是整个数据价值边界的彻底重构。
面对大模型时代多模态、实时、高并发的数据吞吐需求,拿着旧时代的数据库,注定装不下AI时代的新野心。
02
撕掉底层标签:突破存储边界,变阵AI燃料站
在这场向万亿市场迁徙的历史性浪潮中,谁有资格拿到第一张船票?作为中国基础软件标杆的OceanBase,提供了一个极具商业样本价值的战略变阵。
提到OceanBase,业界的普遍认知依然停留在传统分布式数据库扛把子的阶段。客观的数据也印证了这一王者地位:沙利文报告显示,OceanBase以20.2%的市场份额位居中国分布式数据库第一;赛迪同样给出了其在相关领域市场第一的评级。而在商业化层面,业内预计其2026年的年化收入将超过14亿人民币。
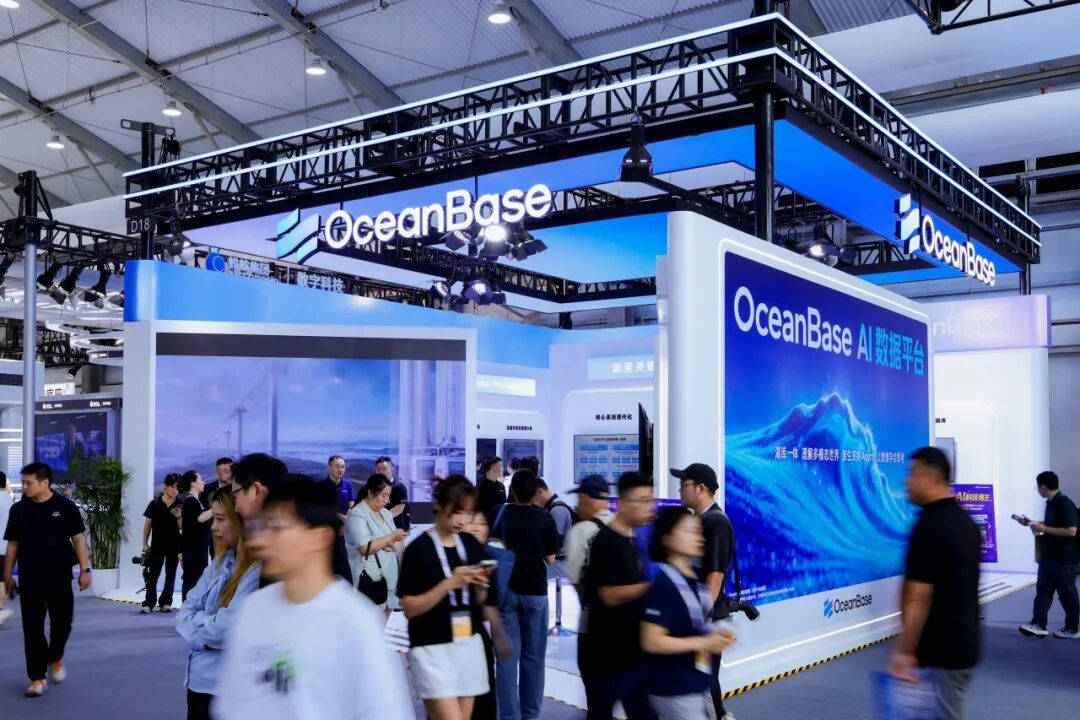
对于一家底层软件公司而言,坐拥近两成市场份额、年化营收超十亿,这已经是极佳的商业成绩单。但在科技史的铁律里,真正的巨头从来不会在存量池里舒服地内卷,而是去新大陆制定游戏规则。对于头部玩家而言,传统市场的第一从来不是天花板,而是进入AI数据平台新阶段的入场券和起点。
在第三方行业观察者的审视下,我们发现OceanBase并没有沉溺于向客户兜售传统的数据库产品,而是极其敏锐地踩中了IDC报告中指出的核心技术演进路径:小模型+多模态底座。
在这一极具前瞻性的核心路径中,OceanBase展现出了深厚的战略定力。大模型虽然聪明,但调用成本极高且处理冗杂数据时极易产生幻觉。OceanBase通过前置的小模型与多模态底座打配合,在底层对海量复杂数据进行初步的清洗、切片、向量化和语义提取。这就像是在把食材喂给大模型这位顶级大厨之前,先由专业的中央厨房进行了一次极其高效的粗粮精作,大幅降低了AI的算力损耗。
更关键的是,DataPilot和Lakebase的结合,直接击穿了技术与业务的厚障壁。过去业务人员想调取数据,必须排队求IT部门写SQL代码;现在,借助Data Agent能力,业务人员可以用自然语言直接让AI在一体化底座中穿梭查询、生成分析。
从过去的被动存储,跃迁为主动为AI造血的数据平台。OceanBase正在撕掉自己身上沉重的传统数据库标签,它的本质已经不再是一个简单的存数据的地方,而是一个全生命周期的AI数据燃料站。这不仅是产品技术路线的底层升级,更是其商业模式向AI核心基础设施的全面靠拢。
03
重塑估值锚点:跨越百亿天花板,重构估值坐标系
看懂了这种底层商业逻辑与技术路径的跃迁,我们才能真正理解,为什么整个资本市场需要重新审视这类数据基础设施公司的价值。
在IDC近期发布的重磅报告中,官方极具深意地将全球数据赛道的玩家进行了分类,其中明确指出:以OceanBase、Databricks为代表的数据厂商,正在从核心数据底座向Agent层扩张。虽然两者的历史起点和具体路径有所不同,但它们在AI时代的演进方向与估值坐标系正在加速趋同。
这就触及到了这场变革中最核心的商业命题:估值重构。据彭博社等商业媒体的长期观察视角,随着生成式AI的爆发,全球资本市场正在为“数据+AI”赛道寻找全新的估值标尺。作为美国市场最炙手可热的超级独角兽,Databricks正是凭借其强大的湖仓一体架构和对AI计算的深度支持,撑起了数百亿美元的惊人估值,成为了全行业仰望的标杆。
传统数据库公司的估值模型,长期困在IT成本中心的逻辑里,只能按照存储节点的多少、处理并发量的规模来向客户按件收费,其增长天花板被企业有限的IT预算死死压住。
然而,当你跨入AI数据平台的语境,这套老掉牙的逻辑就彻底失效了。Databricks之所以能拿到数百亿美元的估值,正是因为它跳出了卖存储的泥潭,转而向企业交付AI-ready的生产力。这也是IDC将OceanBase与其列入同一演进阵营的深层用意。当OceanBase通过多模态底座成为企业AI不可或缺的供血系统时,它赚取的就不再是冰冷的IT运维费,而是企业为了获取智能化转型所支付的业务增长红利。这种从IT工具到业务引擎的身份转换,才是资本市场重构其估值倍数的最强劲动力。
这并不是说我们要将两家公司简单等同,或者粗暴地对标具体的估值数字,而是意味着资本市场正在将Databricks这一类AI数据平台巨头,作为衡量未来基础软件价值的关键参照系。
如果依然固执地用141.7亿规模的传统数据库市场逻辑,去衡量如今的OceanBase,那将是极具破坏性的视线错位。因为这种视角下看到的只是一个存量游戏里的赢家。只有将其放入支撑未来所有AI应用落地、长达十年红利的万亿级AI数据基础设施坐标系中,才能真正看懂OceanBase这次战略变阵的威力。
正所谓衡量一条龙的价值,不能再用量一条鱼的尺子。当旧王座上的赢家主动破壁,投资人和市场的衡量标尺,也是时候换一换了。
市场的基础规律就是:谁能解决时代最痛的痛点,谁就能拿走最大的蛋糕。在AI以摧枯拉朽之势全面重塑千行百业的今天,算力决定了我们能走多快,而数据基础设施则决定了我们能走多远。
IDC的一纸报告,抬高的不只是一个约一万亿的市场规模预期,更是重塑了整个数据基础设施领域的估值锚点。谁掌握了数据喂养AI的咽喉,谁就拿到了通向下一个智能十年的诺亚方舟船票。万亿深海已现,一场属于世界级AI数据平台的卡位战,才刚刚开始。