



编辑|张倩
把一个杯子从桌子左边推到右边,对人来说再自然不过。但如果把这个过程拆开,会发现所谓的「未来」其实并不是凭空出现的:手臂先移动,接触发生后杯子才开始滑动,运动又改变物体的位置和空间关系,最终才形成下一刻我们看到的画面。
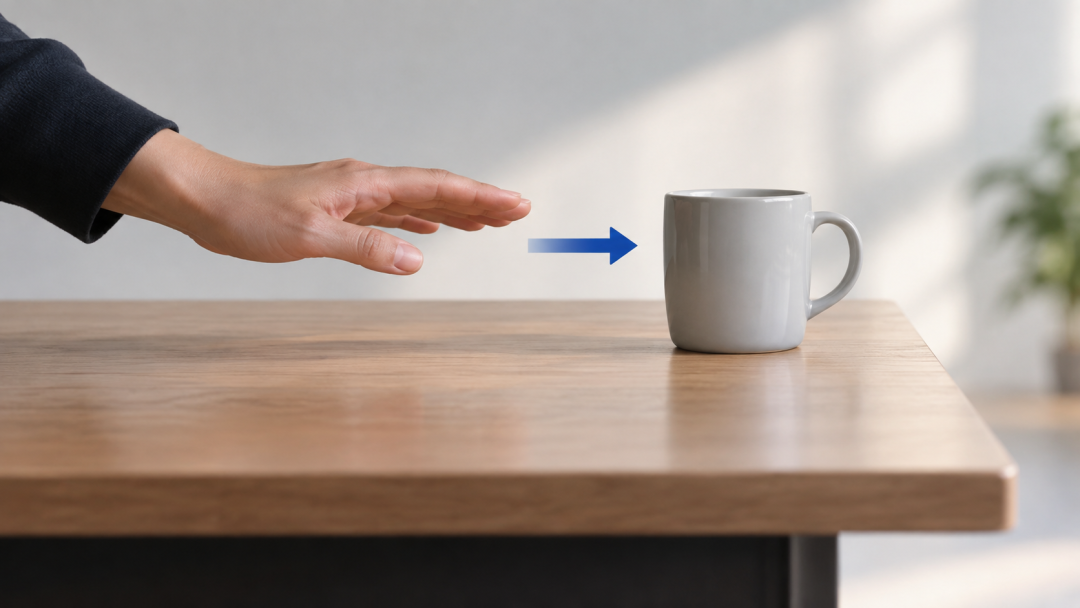
对于世界模型来说,问题也在这里。
现在不少模型已经很擅长直接从「当前画面」生成「未来画面」。但如果中间这些运动、接触、几何变化全部藏在模型内部,我们很难知道,它究竟理解了世界如何变化,还是仅仅根据训练数据,「猜」出了一个看起来合理的未来。
最近,Aether AI 正式发布了第一版因果世界模型 CausalWM(16B 参数)。它尝试把原本藏在模型内部的这段过程显式写出来,并引入了一种新的技术范式 ——Causal Chain-of-Thought,因果思维链。
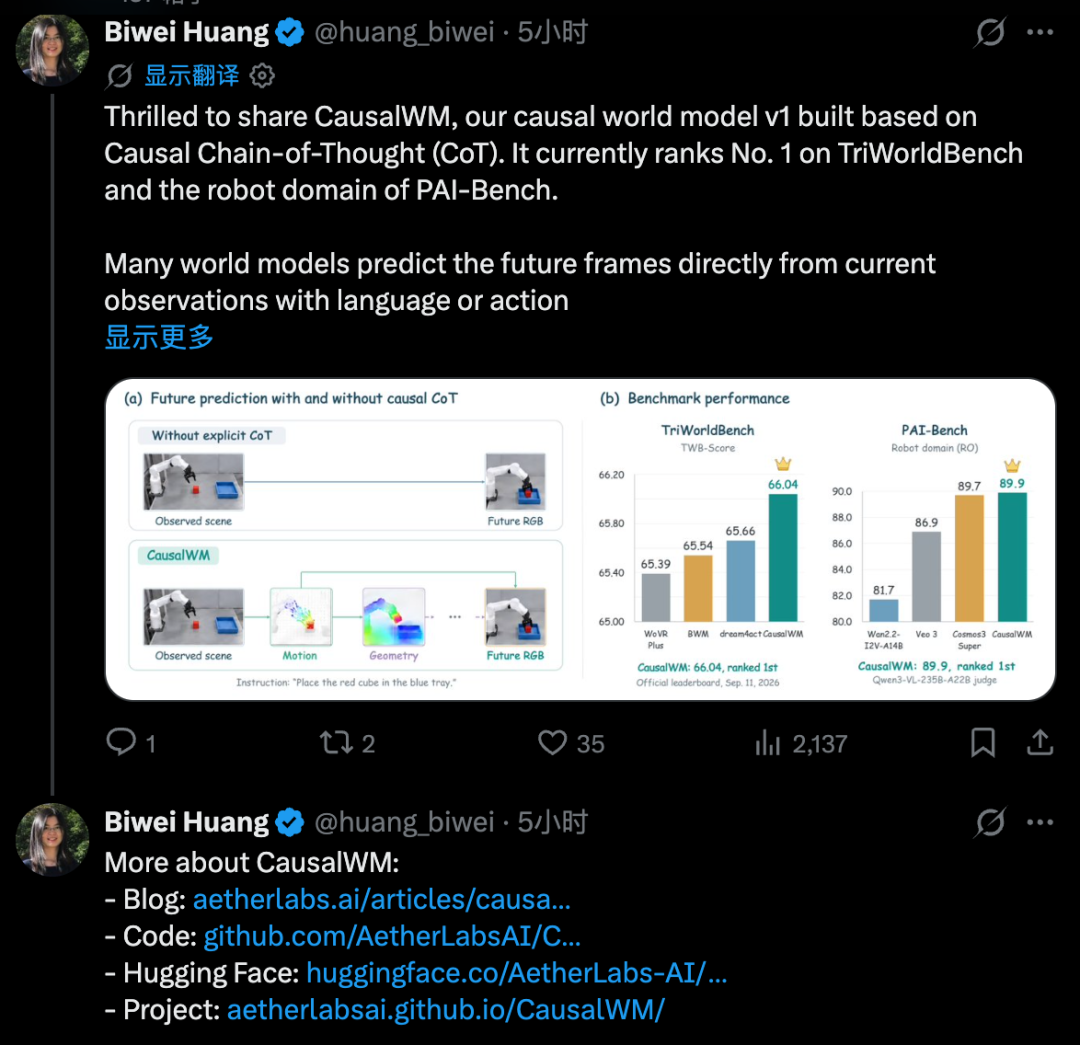
来源: Aether AI 创始人黄碧薇 X 官方账号
简单来说,CausalWM 不急着直接生成未来,而是先推演物体如何运动、三维几何关系怎样变化,再根据这些中间结果继续生成未来画面。
Aether AI 希望借此回答一个更难的问题:世界模型能不能不只预测「未来长什么样」,还进一步理解「未来是怎样一步一步发生的?」
这套方法目前也已经得到了一些阶段性的实验验证。
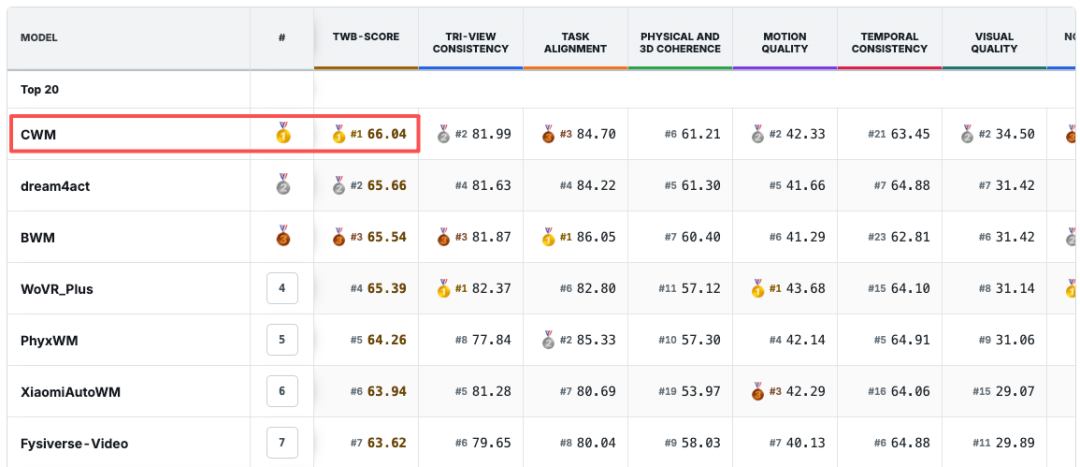
在最新更新的机器人世界模型基准 TriWorldBench 上,CausalWM 登顶 Leaderboard,取得 Top-1。这个榜单专门考察世界模型对机器人任务的预测能力,尤其是头部相机、左腕相机、右腕相机的三视角一致性。该榜单总共包含六个评测维度、19 项具体指标,只是「看起来合理」很难拿高分,需要理解机制才行。
这条思路与团队此前发布的 RSIAgent 一脉相承。RSIAgent 让智能体进入陌生软件,通过主动探索和反复验证,摸清操作与结果之间的关系,再把经验沉淀进 Memory。它没有更新模型参数,却推动 Kimi-K3、GLM-5.3 等开源模型在 OSWorld 2.0、Agents’ Last Exam 上超过 GPT-6 Astra 等闭源模型。RSIAgent 处理的是数字环境,CausalWM 将问题推进到了机器人所在的物理世界。
相比「又一个榜单第一」,更值得讨论的是:CausalWM 为什么要在世界模型里加入这样一条因果思维链,以及这条链究竟是怎样工作的?
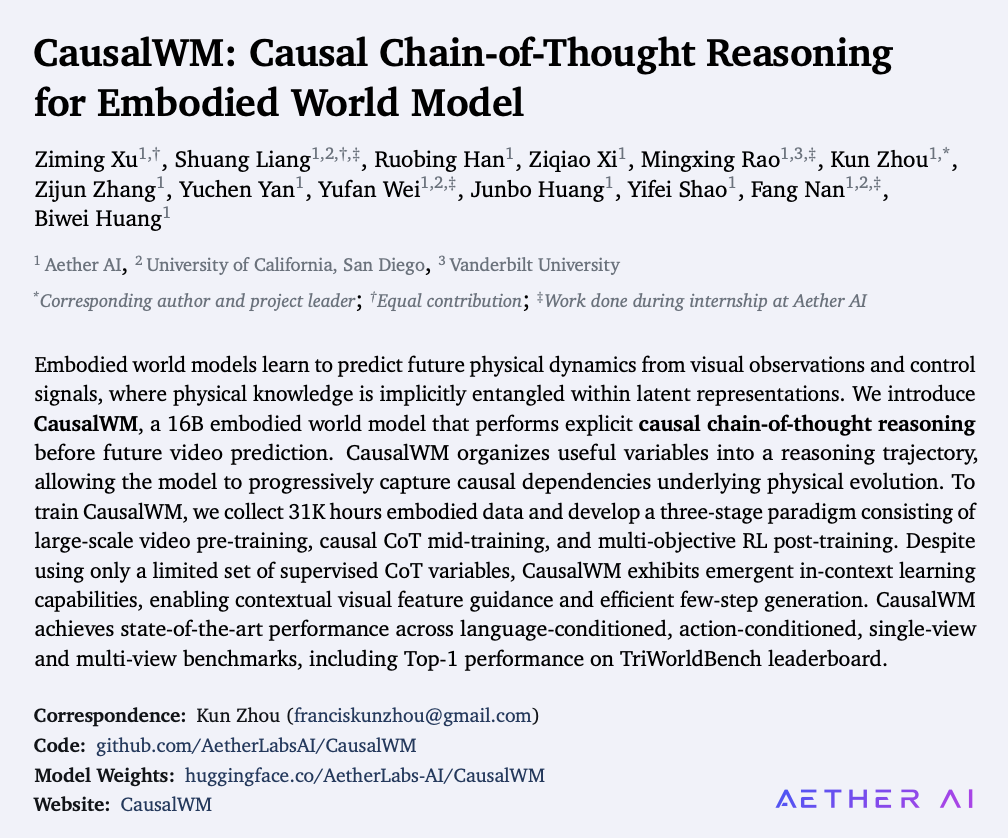
论文标题:CausalWM: Causal Chain-of-Thought Reasoning for Embodied World Model
代码链接:https://github.com/AetherLabsAI/CausalWM
模型权重:https://huggingface.co/AetherLabs-AI/CausalWM
项目主页:https://aetherlabsai.github.io/CausalWM/
论文链接:https://openreview.net/pdf?id=3pf4d0EEqm
世界模型也开始写「解题过程」
目前不少世界模型采用一条很直接的路径:输入当前画面和动作指令,生成未来视频。这种方法在数据规模足够大时很有效。模型见过大量「手推杯子」的视频,自然能猜出杯子接下来大概率会移动。
但运动、接触和空间变化都被压进了模型内部,我们很难判断它究竟理解了物理过程,还是从训练数据中找到某种 shortcut。
场景一复杂,问题也容易暴露出来。机器人连续操作多个物体,预测时间拉长,中间一次接触判断失误,后面的画面就可能越偏越远。
CausalWM 的思路,有点像让一个只写答案的学生补上解题过程。它并不直接从当前画面跳到未来画面,而是在生成未来视频前,先把其中一部分物理变化显式地预测出来。
团队选取了几类可以从视频中自动提取的物理变量:
Optical Flow,也就是光流,描述画面中的物体往哪里移动、移动了多少。
Depth,描述物体与相机之间的距离。
Pointmap,则进一步为画面中的像素补上三维空间位置,让模型获得更明确的三维几何关系。
但真正关键的,并不是 CausalWM 使用了 Flow、Depth 或 Pointmap。这些变量过去已经被大量用于视频预测和视觉理解,有时也会作为辅助监督信号出现。CausalWM 真正不同的地方,是把它们组织成一条有顺序的 reasoning chain。
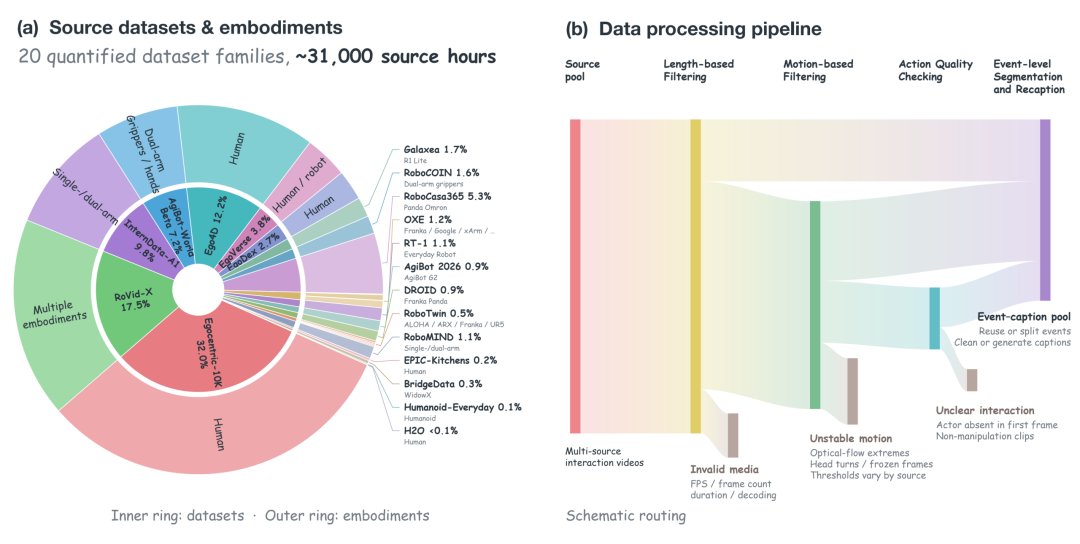
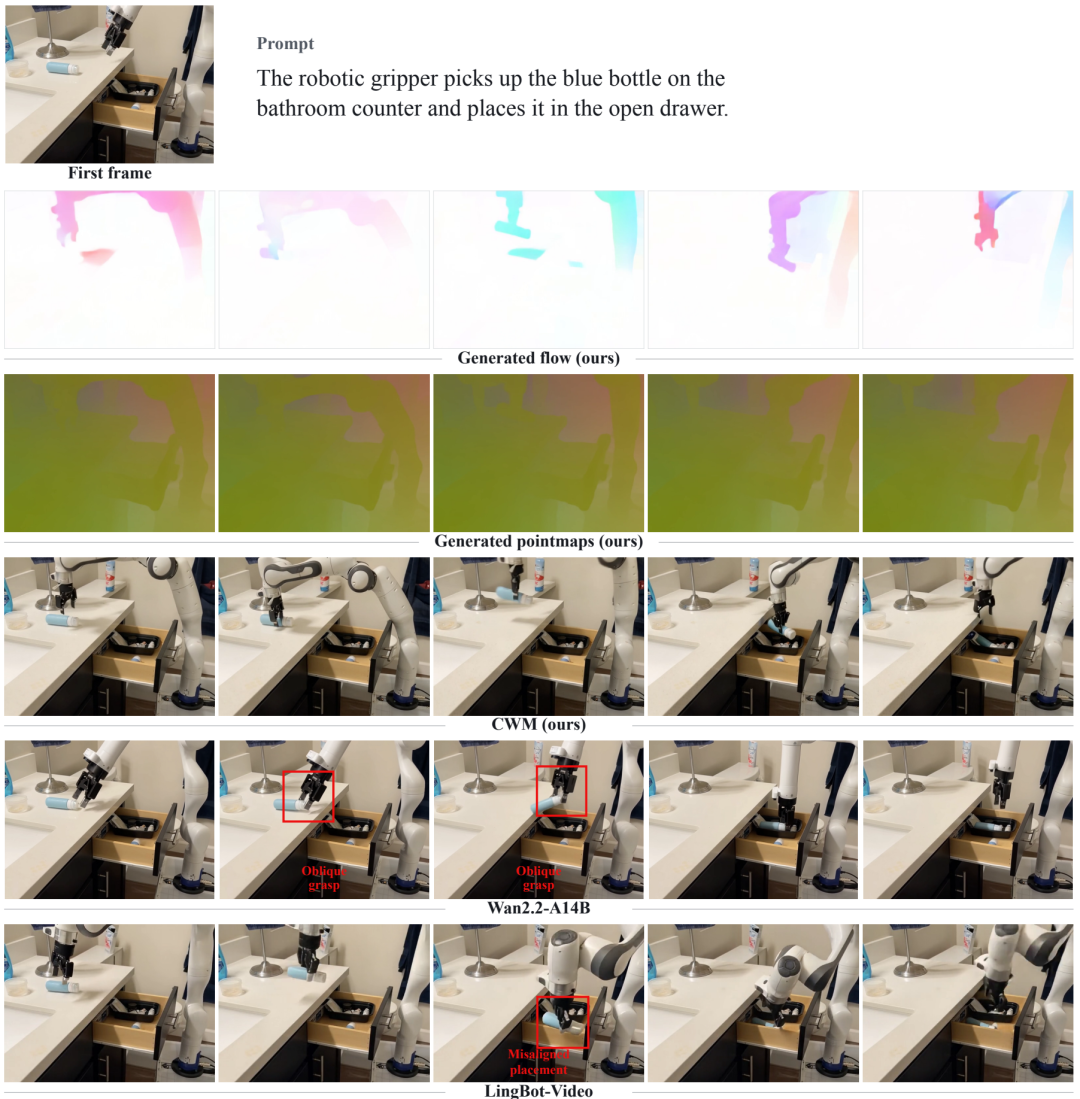
还是以推杯子为例。模型并非先回答:几帧之后,杯子会在哪里?而是先思考:画面中什么东西正在运动,它正在往哪里运动?这对应的是 Physical Motion。CausalWM 可以通过 Optical Flow 表达这一步变化。
接下来,模型继续推演:这样的运动,会让场景中的三维空间关系发生什么改变?杯子的位置发生了变化,机械臂与杯子的相对距离发生变化,整个场景的三维结构也跟着变化。这一步对应 Geometry,可以通过 Depth、Pointmap 等变量表达。
到这一步之后,模型才真正去生成:在这样的运动与几何变化之后,未来画面应该是什么样子?
于是,一条典型的推理链形成:
Observation → Physical Motion → Geometry → Future Observation
这里还有一个很重要的区别。传统方法即使预测 Flow、Depth 或 Pointmap,也可能只是把它们当作训练阶段的辅助目标。模型做完这道「辅助题」,未来视频仍然可以走另一条内部路径生成。
CausalWM 则不一样。模型预测出 Flow 后,会把这一步结果重新放进上下文,继续用来判断三维几何关系;随后得到的 Pointmap 又进一步进入上下文,参与未来画面的生成。因此每一步既是预测目标,也是下一步推理的条件。这也是为什么团队把它称作 Causal Chain-of-Thought。它利用现实世界本身就存在的运动与几何变化,搭出一条真正参与未来生成的 reasoning trajectory。
为了避免模型训练时「偷看答案」,CausalWM 还加入了 stage-ordered attention mask。简单理解,就是给不同推理阶段规定阅读权限:前面的步骤只能看到已经发生的信息,不能提前读取后面的 Pointmap 或未来画面。否则,模型虽然表面上完成了 Motion、Geometry 等中间预测,实际上可能已经从「最终答案」中反推出前面的变量,这条所谓的因果链也就失去了意义。
因此,无论训练还是实际推理,模型都必须按照同样的方向往下走:Motion → Geometry → Future。
3 万小时视频,
分三步把因果链训出来
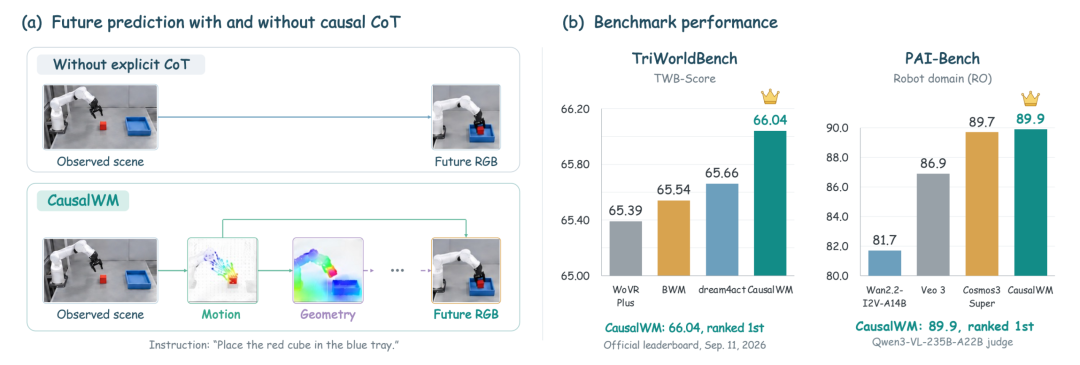
要让模型真正沿着这条链推演,光有架构设计还不够。Aether AI 为 CausalWM 构建了约 3 万小时的具身视频混合数据,覆盖机器人操作、第一视角视频、多视角机器人数据,以及其他物理交互场景。
整个训练过程分为三步:
Pixel-level Pre-training → Causal CoT Mid-training → Multi-objective RL Post-training
第一阶段:先建立足够强的世界生成能力
CausalWM 以 LTX-2.3-22B 为基座,在大规模视频上学习语言条件下的未来预测。给它一段当前画面和任务描述,模型首先要能生成连贯、可信的后续视频。没有这层基础,后面的物理推理也无从谈起。
现实数据还有一个麻烦:大量视频没有对应的机器人动作标注。即使有,不同机器人的关节数量、控制方式和动作空间也差别很大,很难放在一起直接训练。
团队为此引入 CD-LAM,从视频中提取统一的 latent action。它可以把画面中发生的变化压缩成一种潜在动作表示,让模型在缺少真实控制指令的情况下,仍能学习 “什么动作带来了什么变化”。来自不同机器人的视频,也可以通过这套统一表示共同用于 action-conditioned dynamics,也就是动作条件下的世界演化建模。
考虑到机器人通常同时拥有头部、手腕等多个摄像头,团队还在这一阶段训练了多视角版本。模型需要从不同位置观察同一次操作,并保持物体状态和机器人动作的一致。这为后续参加 TriWorldBench 的三视角评测打下了基础。
第二阶段,模型开始正式学习 Causal CoT
团队选取 Optical Flow、Depth 和 Pointmap 作为中间物理变量。它们分别描述画面中的运动、物体与相机的距离,以及更明确的三维空间关系。这几类信息都可以从原始视频中自动提取,因此不需要逐条人工标注,也更容易扩展到大规模数据。
训练过程中,模型按照预设的物理依赖关系逐步生成中间变量。典型顺序是:
Flow → Pointmap → Future RGB
模型先预测物体如何运动,再推演三维几何如何变化,最后生成未来画面。前一步的预测结果会重新放回上下文,继续指导下一步。这样一来,Flow 和 Pointmap 既是需要预测的目标,也是后续推理直接使用的条件。
为了防止模型在训练中提前看到后面的答案,CausalWM 使用了 stage-ordered attention mask。每个阶段只能读取当前步骤之前的信息,后面的 Pointmap 和未来视频无法向前泄露。模型在训练和实际推理时都遵循相同顺序,这条 CoT 才会真正参与未来视频的生成。
第三阶段:用最终结果反过来优化整条推理链
视频生成具有很强的开放性。同一个初始场景可能存在多个合理未来,很难像分类任务一样依靠唯一标准答案训练。单纯使用监督学习,也很难同时照顾物理一致性、时序质量和任务完成情况。
CausalWM 因此加入多目标强化学习。针对同一个上下文,模型会采样多个未来结果,再从物理一致性、视觉质量和任务完成度等维度获得奖励,通过 group-based optimization 比较和优化这些候选结果。
这一步优化的范围还包括中间的 Causal CoT。模型会根据最终视频的质量,探索哪些推理路径更有效:能够产生合理未来的中间过程得到强化,容易把运动和几何关系带偏的路径受到抑制。
经过这一阶段,Causal CoT 从一条固定的监督链,进一步变成可以探索和优化的物理推理过程。模型学习的不只有未来画面应该长什么样,还包括怎样经过一组更合理的中间变化走到那个未来。
当 Causal CoT 变成 In-context Learning 的控制接口
Causal CoT 还带来了一个额外能力。
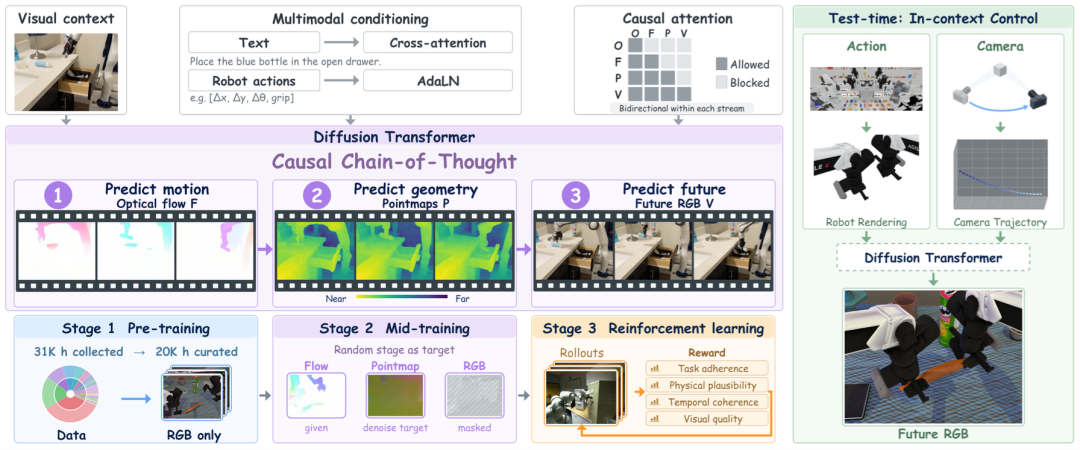
训练过程中,CausalWM 不断接收光流、深度和 Pointmap 等视觉变量,再利用它们生成下一阶段结果。久而久之,模型学会了一种更通用的操作:只要新的条件能够表示成视觉信息,就有机会被放进上下文,参与未来生成。
这给控制留下了入口。
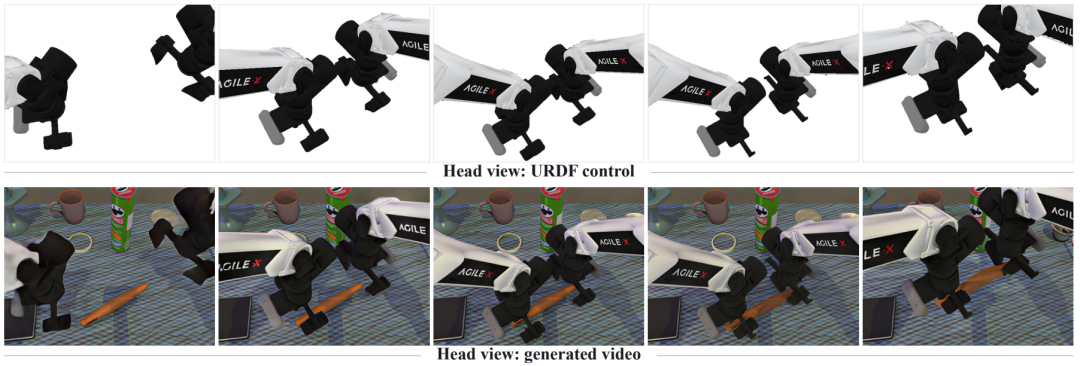
假设研究人员已经在仿真器中规划好机械臂的关节运动轨迹。利用机器人的 URDF 结构信息和正向运动学,这串关节数据可以被渲染成画面中的动作轨迹,再编码成视觉 token,送进 CausalWM。
经过少量微调,模型便能识别这种原本不在 Causal CoT 中的条件,并生成与指定轨迹一致的未来视频。人工绘制的物体路径、几何约束等视觉信号,也可以沿着同一个接口输入。
原本用来解释未来如何发生的中间变量,由此成了可以拨动的 “控制旋钮”。
这一点很接近因果问题的核心。普通预测问的是:按照已有画面,接下来大概率出现什么?加入轨迹,相当于主动改变一个条件,再观察未来怎样随之变化。模型开始处理 “如果让机械臂这样运动,杯子会怎样移动” 这类带有干预意味的问题。
当然,这距离严格意义上的反事实推理还有距离。但它已经让世界模型从观看未来,向操纵条件、比较结果迈出了一步。
Causal CoT 真的有效吗?
Causal CoT 真的能让世界模型更好地预测未来吗?
Aether AI 在多类具身世界模型 Benchmark 上对 CausalWM 进行了评测,覆盖语言条件、动作条件、单视角和多视角预测。其中包括在线 Benchmark TriWorldBench,以及离线 Benchmark PAI-Bench 等。结果显示,CausalWM 在多个设置下取得了领先结果。
其中,TriWorldBench 提供了一个比较直观的观察窗口。
和很多只评单个外部视角的视频 Benchmark 不同,它要求模型同时生成头部、左腕和右腕三个视角。这很接近机器人真实工作时的观察方式:头部相机看全局任务进展,腕部相机关注局部接触与抓取。
因此,三个画面不只要分别「看起来像」,还必须描述同一个物理世界:机器人什么时候运动、物体有没有被正确抓取、不同视角里的状态能不能对应起来。
在最新排名中,CausalWM 以 66.04 的 TWB-Score 排在第一。其中三视角一致性、任务对齐、运动质量、透视合理性和图像质量等多项指标均进入前列或取得领先。
它并没有包揽所有单项第一。最终总分领先,更像是在说明:在这套评测下,CausalWM 能较好地同时处理多视角一致性、任务理解、物理交互和视频生成质量。
TriWorldBench 之外,团队还在 PAI-Bench 等不同设置下进行了测试,并在最新排名中位列第一。
和 TriWorldBench 侧重机器人多视角一致性不同,PAI-Bench 拷问的是一个更底层的问题:模型预测的未来,符合物理规律吗?这个基准的全部案例都来自行车记录仪、工业相机等真实世界采集,横跨自动驾驶、机器人操作、工业场景、人类活动、物理常识等领域。评测时不只看画面质量,还引入「Domain Score」,让多模态大模型当裁判,对着生成视频逐条追问物理细节。因此,模型也不能只靠「画面生成得像」拿高分。
单看一个榜单的榜首,偶然因素总是存在。但如果同一套方法在多种任务设置下都能取得较好的结果,至少提供了一个方法层面的信号:
相比只让模型直接从 Observation 跳到 Future,把中间的 Motion 和 Geometry 显式建模出来,可能确实能帮助世界模型更稳定地预测物理世界的变化。
Aether AI 的 CausalWM:
从 “预测世界” 到 “理解世界”
过去几年,世界模型的主线很清晰:更多数据、更大模型、更长视频、更高分辨率。这条 Scaling 路线教会了模型回答一个问题 —— 未来长什么样。而 Aether AI 更关心的是另一个问题:未来为什么会这样发生,以及什么真正决定了未来。
这也是 Aether AI 持续推进因果智能(Causal Intelligence) 的核心出发点。对于世界模型而言,现有方法往往把运动、几何和物理知识隐式压缩进隐表示中。模型可能生成一个看起来合理的未来,却很难判断它是否真正识别了关键因果变量,还是依赖数据中的 shortcut correlation 直接 “猜” 出了结果。随着预测时间变长、物体交互变复杂,这种隐式建模的局限也会更加明显,误差会在看不到的地方层层累积。
CausalWM 是 Aether AI 在因果世界模型方向上的第一版尝试。 它试图把原本隐藏在模型内部的物理变化显式化:将光流、深度、三维几何等变量组织成有顺序的 Causal CoT,让模型沿着 Motion → Geometry → Future 的因果链逐步推演,再生成未来画面。换句话说,模型不再只是学习 “输入到结果” 的相关性,而开始显式建模哪些中间变化导致了哪些后续结果。
实验也验证了这条路线的潜力:CausalWM 登顶 TriWorldBench,并在 PAI-Bench 多项指标上超过 SOTA 模型,其中不乏参数规模更大的方法。相比单纯继续扩大模型规模,Aether AI 更想验证的是另一条路径:通过建模 causal variables、causal dependencies 和 causal transitions,提升世界模型对物理世界的理解能力。
更进一步,Causal CoT 也让 “因果推理” 和 “控制” 开始共享同一套接口。原本用于解释未来的中间变量,也可以反过来作为 intervention 通过 in-context learning 形式注入模型。例如,将 simulator 中规划的机械臂轨迹渲染成视觉信号后加入 context,模型就可以生成与该 intervention 一致的未来。这意味着,世界模型开始从单纯观察 “世界会发生什么”,进一步走向建模:当我们改变某个变量、施加某个行动之后,世界将如何变化。
当然,CausalWM 仍然只是这条路线的起点,距离更完整的因果发现和反事实推理仍有很长距离。但这也正是 Aether AI 希望持续推进的问题:从因果表示学习、因果推理到因果干涉,逐步实现更完整的因果智能。(注:图灵奖得主 Judea Pearl 把智能分为三层:关联、干预、反事实,按 Pearl 的因果之梯划分,现有主流模型大多停留在第一层 “关联”,触不到 “干预” 与 “反事实”)。
把视野放宽,CausalWM 只是这条长期路线的一个阶段性成果。RSIAgent 让智能体在数字环境里主动探索、验证操作与结果的关系,CausalWM 则把同一个问题搬进物理世界:一个处理软件里的因果,一个处理物理世界里的因果。
这也是 Aether AI “Towards Real-World Causal Intelligence” 所指向的方向 —— 让 AI 从预测相关性,进一步走向发现因果、理解因果、利用因果,并最终通过因果作用于世界。
该团队的下一份成果,值得期待!
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com