


最近几天,AI 圈讨论度很高的一个模型,不是 GPT、Claude 或 Gemini 的新版本,而是一个几乎不说话的 Jev。
9 月 15 日发布后,它很快被接入 Vercel AI Gateway。根据 Vercel 公布的数据,上线 Gateway 24 小时内,近 13% 的付费团队已经使用过它,这是平台历史上采用最快的一次模型发布。对于一款此前没有公开亮相的模型,这个开局相当抢眼。当然,尝鲜之后能留下多少用户,还需要时间检验。
开发者感兴趣的,是把 Jev 放进模型路由、Agent 是否继续执行、风险筛查、输出检查等环节。TypeSafe 对它的定义也很特别:第一款“System One Model”。给它一段 state 和几个问题,它直接返回选择、评分或真假判断,以及相应的概率,供软件调用。
这和过去几年人们最熟悉的模型发布,很不一样。大家已经习惯等待一个更会回答问题、更能解释自己、更擅长长篇推理的 AI,Jev 却干脆拿掉了文字生成。它负责判断,下一步做什么,由程序决定。
一个不太像大模型的模型
Jev 的使用方式很简单:先给模型一个 state,也就是需要判断的上下文;再给它一组 questions,提前规定每个问题的答案类型。
例如客服系统收到一条用户消息,程序可以同时问:
● 这是不是紧急问题?
● 用户是不是有购买意向?
● 应该分到哪个处理类别?
● 严重程度是多少?
我们可以用伪代码比较一下 Jev 和语言模型的区别。
JSON
jev("我被重复扣款了,请退款。", {
department: choice({
billing: "付款退款",
technical: "产品故障",
sales: "购买咨询"
}),
urgency: score(["可以等待", "今天处理", "立即处理"]),
refund_requested: probability("客户明确要求退款")
})
JavaScript
response = llm(`
分析买家消息:“我被重复扣款了,请退款。”
返回三个字段:
department:billing(付款退款)、technical(产品故障)、sales(购买咨询)
urgency:0(可以等待)、1(今天处理)、2(立即处理),允许小数
refund_requested:客户明确要求退款的概率,范围为 0~1
只返回 JSON,不要解释。
`)
result = JSON.parse(response)
通过 Vercel AI SDK 调用时,这些问题可以分别设为 Choice、Score 或 Boolean。Choice 选择一个选项,Score 按给定标准评分,Boolean 返回一个真假概率。模型处理完,程序就可以读取结果。
普通大模型当然也能完成这些判断,还可以被要求只输出 JSON。在常见的聊天式调用中,它仍然需要逐个 token 生成这份结果。Jev 把产品目标收窄到预先声明好的判断,不生成一段文字来交付答案。
TypeSafe 官方称,Jev 使用了新的模型架构、并行 sampler,以及 Reinforcement Learning for Calibrated Decisions(RLCD)训练方法。它会并行处理声明好的问题,输出空间也提前限定,因此不会出现 schema 之外的类型错误。System One 这个名字来自丹尼尔·卡尼曼《思考,快与慢》里的 System 1:快速、直觉式的判断。
不过,官方宣传中的“不会 hallucinate”,也许并不是你想的那样。
它不会凭空生成一个不存在的选项,也不会把本该是数字的结果写成一段文字。但这并不等于它不会判断错。比如你让它在 A、B、C 三个选项里选一个,它仍然可能选错,只是不会跑出 D。TypeSafe 在发布文章中也解释,其“零幻觉”数字来自对输出结构的保证。
模型的自由度被压缩了,判断本身依然可能出错。这两件事,需要分开看。
实测:快是真的快,但也没那么强
为了看看 Jev 到底能做到什么程度,我们做了一组很简单、但比较贴近实际业务的测试。
题目来自电商客服场景,我们搞到了一批数据,一共 50 条中文客服问题。每条问题都要求模型完成四项判断:紧急度、售前概率、处理类别和严重度。评分也很直接:四项全部符合人工标注的评分要求,才算这一题正确。
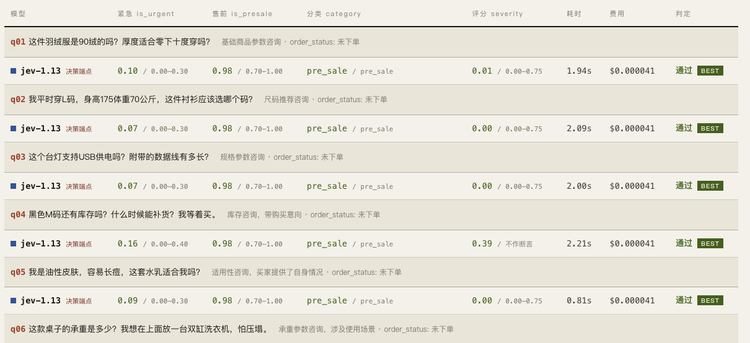
我们把模型分成三组。第一组是便宜的小模型,包括 DeepSeek V4 Flash、GPT-5 nano 和 Gemini 2.5 Flash Lite;第二组是国产模型,包括 GLM 5.3 Flash、DeepSeek V4 Pro、Qwen 3.8 Flash、Kimi K3 和 MiniMax M3;第三组则是 GPT-5.5、Claude Opus 5、Claude Sonnet 5 和 Gemini 3.1 Pro Preview。Jev 放在第一组里比较。
结果并没有出现什么“新模型吊打旧模型”的戏码。
Jev 的平均得分大约在 32~32.6 分之间,50 道题的完整准确率约为 64%~65.2%。它排在便宜小模型组第二,只比 DeepSeek V4 Flash 少 1.2 分。如果只看这组题,Jev 并没有表现出特别强的判断能力。
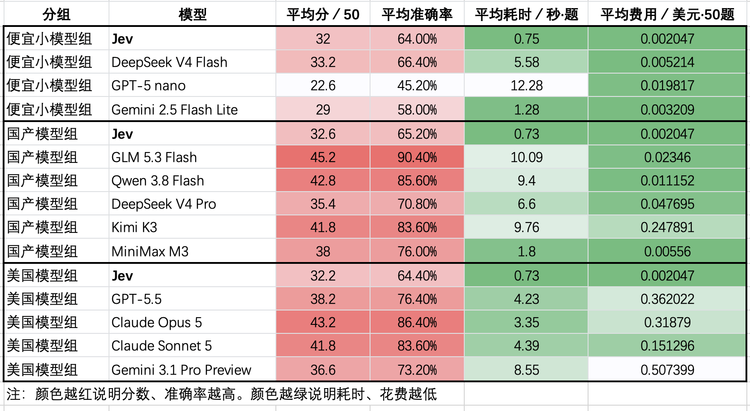
但速度和价格,是另一回事。Jev 平均每道题的完整响应时间约 0.73~0.75 秒,50 道题总成本约 0.002 美元,两项都是我们测试中的最低值。DeepSeek V4 Flash 虽然多拿了一点分,但平均每题需要 5.58 秒,成本约为 Jev 的 2.5 倍。
放到更强的模型组里,准确率的差距就更明显了。Jev 的分数排在最后。MiniMax M3 平均可以拿到约 38 分,比 Jev 多做对约 5.4 题,完整准确率高出约 10.8 个百分点。
但对应的成本差距,其实没有想象中那么大:50 道题,MiniMax M3 只多花了大约 0.0035 美元,平均每题响应时间约 1.80 秒。对于这组任务,多花这点钱换取更多正确答案,同样是一个值得考虑的选择。
因此,这组测试很难支持“Jev 是更聪明的模型”这个结论。它展示的是一组具体取舍:少等一会儿,少花一点钱,同时接受一定的准确率差距。是否划算,要看业务有多在意延迟,以及判断错一次会付出什么代价。这 50 条中文客服样本,也不足以代表它在所有任务上的表现。
测试里还有一个挺有意思的现象:Jev 有一些失分,卡在了阈值附近。
比如人工标注认为某条客服消息的严重度下限应该是 2.00,Jev 给出了 1.99;某条临期食品问题的人工紧急度是 0.75,Jev 的结果在 0.71~0.72 左右。数值差距很小,但如果业务规则写的是“达到 2.00 才进入人工处理”,1.99 和 2.00 就会被程序当成完全不同信号。我们重复测试了 15 次,还有 3 道题出现过通过和失分交替的情况。
这说明,模型返回一个精确到小数点后的数字,并不会自动让业务规则变得可靠。尤其在阈值附近,开发者仍然需要处理波动,决定什么时候复核。
TypeSafe 希望进一步解决的,是让概率本身成为软件可以依赖的信号。它把概率校准列为训练目标:如果一批判断都给出 80% 的概率,那么长期看,相应结果应当大约有 80% 成立。这是一个可以检验的目标,不能仅凭模型返回了概率就认定已经实现。
在产品中,Choice 和 Score 会附带概率分布,以及由分布计算的置信度,方便程序决定自动执行、补充信息,还是转交人工。这里的置信度与“严重度打了多少分”是不同的量,我们这组按题目判分的测试,也不能验证概率校准做得有多好。
Jev 想交付给软件的,包括答案,也包括处理不确定性的线索。这件事有用,但离“可以放心交给它”还有一段需要验证的距离。
明星团队带来的反差和新的启发
仅凭这份成绩单,显然还解释不了 Jev 的热度。便宜的小模型已经不少,Jev 也没有在我们的测试里拿下准确率第一。但它就是这么热。
这背后一个关键肯定是它的团队。
TypeSafe 的联合创始人兼 CEO Diogo Almeida,曾在 OpenAI 参与 InstructGPT 的研究。他是 2022 年《Training language models to follow instructions with human feedback》论文的作者之一。这项研究用人类反馈训练模型,让它更好地遵循人的意图,也是通向 ChatGPT 的重要工作。
在论文里有一个很能说明问题的结果:在研究采用的提示和人工评估中,经过训练的 13 亿参数 InstructGPT,比 1750 亿参数的 GPT-3 更受评估者偏爱。模型小了一百多倍,改变训练目标,仍然可以让它更符合使用者的需要。
如今,Almeida 却又开始质疑自己参与推动的成功路线。
Jev 发布文章的开头,他直接问:“模型在聊天上超越人类已经好几年了,自动化在哪里?”这问到了大模型热潮里一个迟迟没有充分兑现的承诺。
他的团队也有鲜明的工程背景。联合创始人兼 COO Sasha Sheng 曾在 Meta/FAIR 从事 News Feed、AI 产品体验和研究工作;CTO Erik Gafni 做过面向 DNA 测序的多模态 AI 创业项目,也是 Invitae 和 Freenome 的早期员工。根据官网介绍,团队还包括来自 Google Brain、Stripe、Airbnb、Plaid、Docker 等公司的成员。
这些履历当然让这次转向多了一层意味。一位亲手参与把语言模型变成好用助手的研究者,现在希望模型换一个服务对象:把软件本身的需要放在前面。
在 TypeSafe 的技术介绍里,团队甚至给出一个相当激进的预期:未来大规模 AI 自动化中,99% 的交互可能发生在机器之间,只有 1% 面向人。这是他们的押注,远非已经发生的现实。顺着这个判断往下想,今天模型习惯采用的交付方式,确实值得重新考虑。
一个 Agent 替用户办事,最终也许只需要向人展示一段结果,但在抵达结果之前,它要做很多小决定:这次请求能否交给便宜模型?检索结果是否相关?要调用哪个工具?任务该继续还是重试?另一个模型给出的答案是否值得相信?这些环节的接收者都是程序。它们需要一个能用于下一步的判断,通常用不上一段写得很漂亮的说明。
如果每一步都调用一个通用大模型,等待它组织回答,整个任务的成本和延迟就会不断累积。Jev 提供了一种更明确的分工:写作、代码生成和复杂推理仍然可以交给擅长这些工作的模型;大量边界清楚的小判断,可以尝试交给专门优化过的部件。模型开始服务于 AI 任务的执行过程,也不必每次都出现在用户眼前。
这种想法并不神秘。开发者 Sean Goedecke 已经用现成的 Qwen3-8B,配合单 token 选择和批处理,做出了类似的接口,还重做了 Doom 和 Wikiracing 演示。
让它如此火爆的地方,也在于眼下的 AI 圈,恰好需要一点这样的刺激。
模型发布仍然密集,进步也仍在发生,但发布故事已经越来越熟悉:更高的分数、更长的上下文、更强的推理,然后等待下一轮榜单。对很多持续关注 AI 的人来说,进步的体感开始变慢。
应用端也有类似的疲惫。聊天、编程、图片和视频生成之外,人们仍在等待更多能立刻说出名字、明显改变工作方式的新产品。把一个聊天框放进旧软件,已经很难带来第一次见到 ChatGPT 时的兴奋;让更多行业的一整套业务流程真正自动运行,又远比做出一个演示困难。模型还在更新,那些关于世界将如何被改变的承诺,却需要更长时间才能被感知。
Almeida 传达出来的不满,正好与这种情绪相遇。TypeSafe 在宣言里说,现有模型已经有足够的能力创造经济价值,困难在于人们仍然很难用它们搭建可靠的软件。
在Jev官网他们写到:“Build Prod, Not God”,做出能投入实际使用的产品,而不是去造神。Almeida 的Jev也许还不是能证明这句话的模型,但他确实是最适合把这个越来越明显的行业共同感受喊出来的人。这个意义上,Jev带来的刺激也许会继续发酵下去。