
飞象网讯(孙迎新/文)时间,终于站在我们这边。
就在去年全联接大会上,华为给出的昇腾960时间表还是2027年第四季度。一年之后,9月17日,在华为全联接大会2026上,华为副董事长、轮值董事长汪涛宣布:960DT比原计划提前三个季度,2027年第一季度就绪;960PR比原计划提前一个季度,将在2027年第三季度就绪。
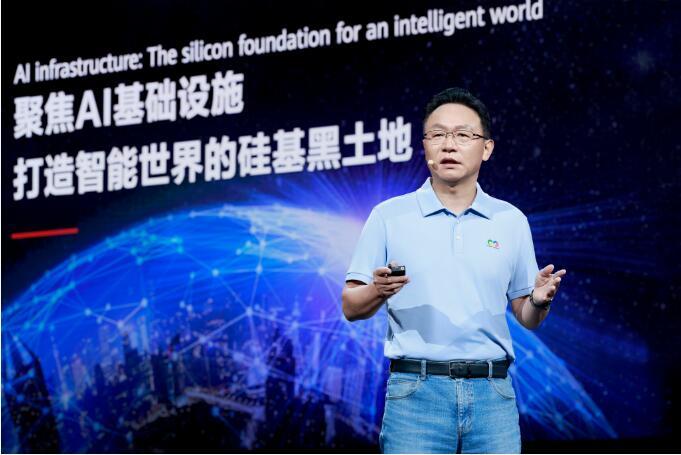
还有更紧要的:未来,昇腾系列芯片将持续坚持一年一代的演进节奏。
这个节奏,不是靠口号喊出来的,而是华为基于当前可获得的工艺,始终坚持创新的结果。如果只把它看成一次芯片迭代,那更是低估了华为这些年在AI算力上耕耘的努力,因为算力之下就是那片期盼已久的硅基黑土地。
超节点+集群:被逼出来的创新之路
华为并不是一开始就选择这条最难的路。
正如汪涛在演讲中所说:“我们走不同的创新路径,利用全新的系统创新架构。我们采用了超节点+集群,以多个规模算力构成高速的系统。”
而这样的系统架构创新,正是华为在没有退路的情况下,艰难地为算力底座寻找到的答案。这话也比任何技术参数都更能说明问题:即便是单颗芯片在先进制程上受到限制,华为也不会停下来等,而是可以换条路走,要用系统架构的创新来弥补单点上的差距。
这条路从一开始就是一条自主创新之路。过去几年,从昇腾芯片到服务器,再到超节点和集群,华为一次次在突破自身极限,不断扩大在AI计算基础设施中的覆盖范围。
我们看到,当今AI变革的速度和烈度,已经超过历史上任何一次技术革命;大模型参数在今天已经快速迈向10万亿规模,并且很快,到2030年将达到100万亿以上。面对狂野激增的计算需求,仅仅提高单颗芯片的计算能力,已经难以覆盖整个系统的需求。
华为也清晰地洞见将来,汪涛表示:“预计到2027年,10万卡集群成为训练十万亿级SOTA模型的标配。”
系统工程的账:超节点架构从功耗、利用率到可用性
回头看时,内存不能统一编址,曾经是一座高山。而翻越高山的路径,就是超节点。
超节点也并不是简单地把大量服务器卡连接起来。在今年的WAIC上,鹏城实验室与全球计算联盟,联合38家单位共同发布了《超节点定义与实践白皮书》,明确定义:超节点是一种在物理上由多个计算节点通过高效的互联协议紧密连接组成,具备跨物理节点的统一内存编址能力,逻辑上具备“一台计算机”特征的计算系统。
“很多人简单把所有服务器卡连在一起就叫超节点,其实这是一个误区。”在汪涛看来,如果只是通过RoCE连接在一起,本质上仍然属于集群,而超节点需要解决的,是节点内部更深层次的计算和互联协同问题。
我们知道,今天主流的MoE模型,训练过程中数万颗芯片需要数百万亿次的通信,来对齐每一层、每一个过程的中间结果。这个过程需要付出巨大的代价,经华为仿真,10万卡服务器集群训练过程中,芯片间的通信代价超过了所有训练时间的40%。而高昂通信代价的背后,是源于沿用了几十年的服务器架构,在决定通信的带宽与时延。
如今解决代价问题有了可行的方案,华为马尔可夫实验室的一项仿真则显示,在相同的10万卡规模下,由4096卡超节点组成的集群,相比由8卡服务器组成的集群,MFU(模型浮点算力利用率)可以提升2.75倍。
汪涛表示:“我们做过测算,每提升1个百分点,10T大模型它的训练可以缩短三天。”方法已经明确,提升MFU这个世界级难题,需要从系统工程视角进行优化。
他进一步指出,现在一个NPO所谓的7.2T,是把36个200G的Lane集成一个模块;一个小的Hi-ONE模块就可以代替9个800G光模块,昇腾960超节点用5500个Hi-ONE,替代原本需要的4万8千颗800G光模块;功耗降低超550千瓦,系统无故障运行时间提升一倍,系统可用度达到99.8%。
“只做好一个芯片是远远不够的,只做一个整机、做一台服务器也是不够的;最后它是一个复杂的、多学科的系统工程能力;给客户交付一个高可用度的计算系统,才是有价值的。”这就是汪涛为系统工程这笔账写下的真实注脚。
生态拐点:CANN根技术成熟与开发者飞轮效应
如果说过去几年,华为是被逼着寻找一条能够继续向前走的路,那么今天,这条路正在进入一个全新阶段。
一路走来,昇腾960芯片研发提前落地、Hi-ONE NPO率先引入超节点、昇腾生态正在跨越拐点,每一次的突破与进步都表明,华为已不再只是在单点上补齐能力,而是在逐步把这套系统做大,进而迈向规模化的拐点。
这条路也已经越来越被业界认可。汪涛在演讲中指出:昇腾910C超节点已部署超过1000套,昇腾950超节点已经规模商用;超节点已成为产、学、研共识,成为AI基础设施建设的必然选择。
从超节点作为一个概念被提出,到装机量过千套,华为用了不到两年。但这还没有结束,过去几年围绕单颗芯片差距的讨论,正在被另一组变量替代,这就是谁能把上万张卡连成一个更加稳定的超级平台。
当昇腾生态跨越拐点,目之所及是一片欣欣向荣。CANN作为昇腾生态的根基,自2018年发布首个版本以来,经过8年的技术积累,架构与能力已逐步走向成熟完善。数据显示,目前CANN外部开发者占比达到61%,社区月活开发者突破5200名,已有40个原生模型预训练,90多个主流第三方社区进行深度共建。
繁荣背后是一个新的格局,昇腾已正式成为继NVIDIA、AMD、Intel之后,在PyTorch官网可直接安装的算力平台,也是首个来自中国的算力平台。我们知道,PyTorch是目前全球主流的开源机器学习框架之一,被广泛用于大模型训练和推理开发。
“构建开源开放的算力生态是华为公司的核心战略。我们坚持构建开源开放的算力生态,支持主流大模型基于昇腾原生训练、积极拥抱‘百模千态’;一个计算系统工程不仅仅是硬件还有软件生态,涉及算子、AI框架、领域加速库以及复杂的工具体系。”汪涛阐述的算力生态,此刻已经更加具象。
“每家企业坚持自己擅长的赛道,客串是没有长期竞争力的。”面对行业里日益激烈的算力角逐,汪涛强调,华为聚焦AI算力基础设施的角色,坚持硬件变现;我们更愿意看到的是,模型公司做好模型,合作伙伴则围绕产品和服务形成自己的能力。
从昇腾芯片到超节点,从超节点到集群,再到互联、存储和软件生态,华为正在把AI计算的边界不断向系统层面延伸,也持续在这片硅基黑土地上耕耘劳作,静待花开。