


近日,网易有道开源的子曰Live系列两款实时交互模型——真流式语音识别模型Confucius4-R2T2(Real Real-Time Transcription)与流式翻译模型Confucius4-T3PO(simulTaneous Translation via pareTo Policy Optimization),先后登顶Hugging Face各自细分领域Trending榜,在全球开发者社区形成“双登顶”。
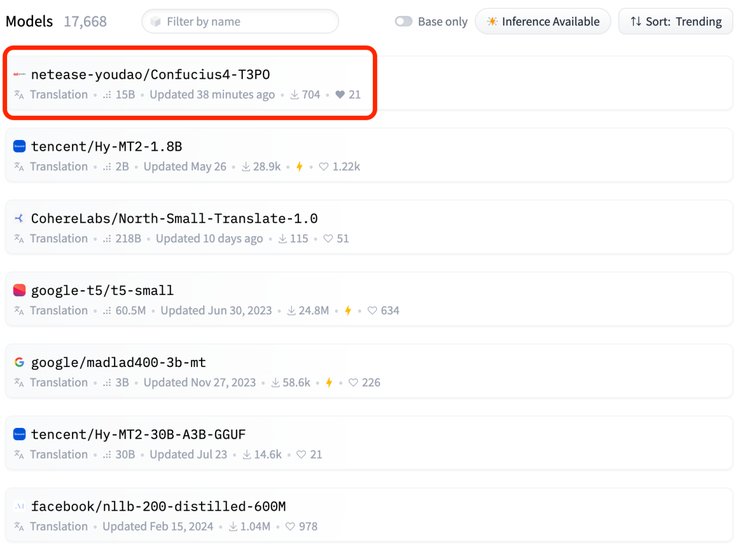
图注:T3PO登顶Hugging Face Translation Trending榜第一 图片来源:Hugging Face截图
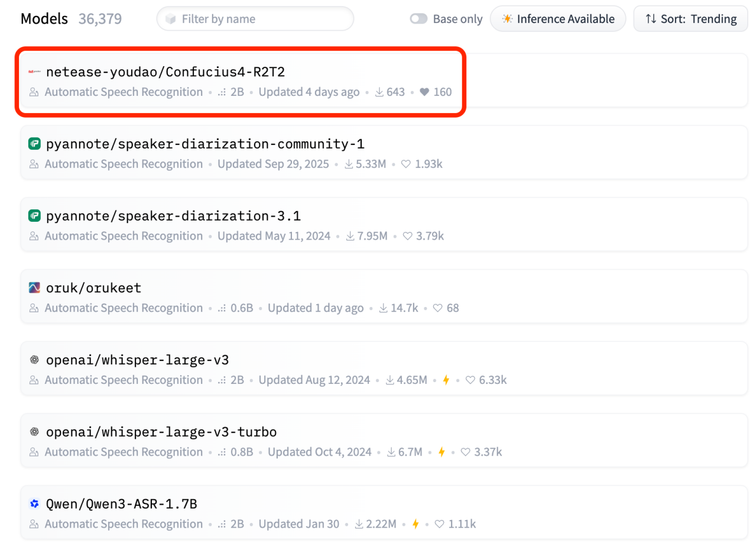
图注:R2T2登顶Hugging Face ASR Trending榜第一 图片来源:Hugging Face截图
其中,R2T2登上Automatic Speech Recognition(ASR)Trending榜首,T3PO则登上Translation Trending榜首。榜单中不乏全球AI行业中最领先的科技公司发布的模型,例如OpenAI和谷歌旗下的多个模型。
两款模型分别解决实时语音交互中的“听得快、听得稳”和“译得快、译得准”问题,并能够组合形成一套面向实时AI语音Agent和同声传译的基础技术链路。
相比榜单本身,更值得关注的是模型开源后迅速出现的社区适配。
R2T2发布后,Hugging Face开源团队主动基于模型搭建ZeroGPU在线Demo,并向网易有道提供免费的ZeroGPU资源支持,希望降低全球开发者体验模型的门槛。
https://huggingface.co/spaces/netease-youdao/confucius4-r2t2-demo
第三方开发者随后将R2T2移植至纯C++本地音频推理框架audio.cpp。9月19日,相关代码正式合入主仓库。此次适配并非简单调用官方接口,而是重新实现了R2T2的Longest Stable Prefix流式状态机,并加入GGUF、本地实时麦克风识别、Streaming API等能力,使其能够更方便地进入Mac、本地AI应用和Voice Agent工具链。
海外量化社区同样迅速跟进。开发者已经推出R2T2的多个GGUF量化版本,从Q2到Q8覆盖不同部署需求,并支持通过llama.cpp、Ollama等工具进行本地调用。
https://huggingface.co/mradermacher/Confucius4-R2T2-GGUF
T3PO也出现了类似的社区响应。模型发布后不久,便完成了从Q2_K到Q8_0等多个GGUF量化版本,使这款140亿参数级实时翻译模型进一步具备本地部署条件。
https://huggingface.co/mradermacher/Confucius4-T3PO-GGUF
模型能够快速受到开发者社区追捧的核心原因,主要是在构架上针对AI语音Agent的需求进行了专门的设计和优化,对未来语音智能体应用的开发,实时字幕,实时同传等场景会有非常好的适配能力。
例如在语音同传场景下(例如短剧、直播、会议、AI客服等),R2T2和T3PO能够提供实时快速上屏的双语稳定文字展示效果,不用等到用户说完整句话才展示,提升了交流的效率和体验。
在AI语音Agent应用开发中,传统流式ASR即使输出速度很快,如果前文识别结果仍在不断变化,下游LLM也很难提前介入处理;而稳定的增量文本能够让Agent在用户尚未说完时,就开始理解上下文并执行后续任务,从而显著提升语音Agent的实时性和开发效率。
两款模型受到关注,与其实时交互技术路线密切相关。
R2T2支持80毫秒至2秒灵活可配置的流式输入,并通过Longest Stable Prefix机制判断哪些语音内容已经足够稳定。一旦确认,文字便遵循Append-only原则永久提交,不再因为后续音频而反复改写。官方测试显示,R2T2在保持接近离线ASR准确率的同时,平均识别延迟(平均说完每个字到识别出这个字的时间)约为200至600毫秒。
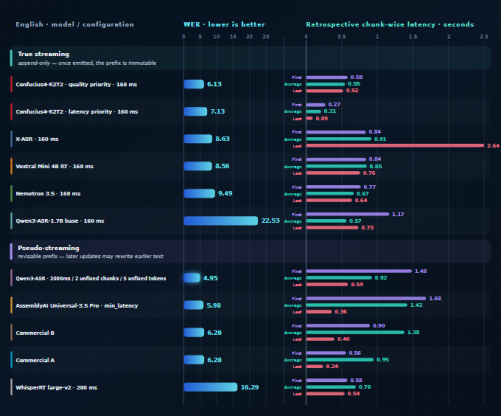
图注:英文测试集质量和延迟结果对比 来源:https://github.com/netease-youdao/Confucius4-R2T2
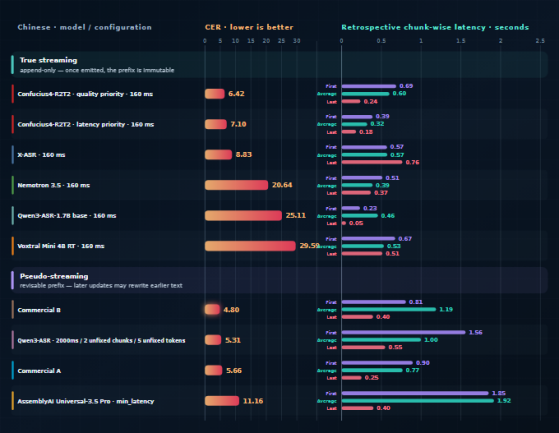
图注:中文测试集质量和延迟结果对比 来源:https://github.com/netease-youdao/Confucius4-R2T2
T3PO则进一步解决实时翻译中的另一组矛盾——速度与质量。模型通过帕累托策略优化推进了实时翻译的延迟-质量的前沿,能够在非常低延迟的情况下提供接近offline的翻译质量。
当R2T2与T3PO组合后,一条实时同传链路由此形成:
语音持续进入R2T2,生成稳定、可立即消费的文本;T3PO接收这些文本,并自主判断何时开始翻译。
这使AI语音交互有机会从传统的“说完—识别—翻译”,转向“边说—边听—边理解—边翻译”。
R2T2与T3PO正在从两款开源模型进一步进入全球开发者的实时语音工具链。
2023年,网易有道推出国内首个教育大模型——“子曰”。之后,网易有道迭代模型能力,针对多模态推理,翻译和实时语音交互持续发力。现在,“子曰”已经打造成了一个完整的模型矩阵,建立了包含多模态推理、翻译以及语音和实时交互的AI模型能力。