田晏林 发自 凹非寺
量子位 | 公众号 QbitAI
5天。
不用搭景,不用等演员,导演陆川和团队,直接用AI把一场发生在400年前的明代灾难现场,搓出来了!
宫廷、火药库,还有史料中烟云如黑灵芝的大爆炸。按照传统影视工业的做法,这样的场景复原往往需要数月时间和千万级投入。
但这次,他们只用了5天!
来,话不多说,先看短片。
怎么样?够猛吧?
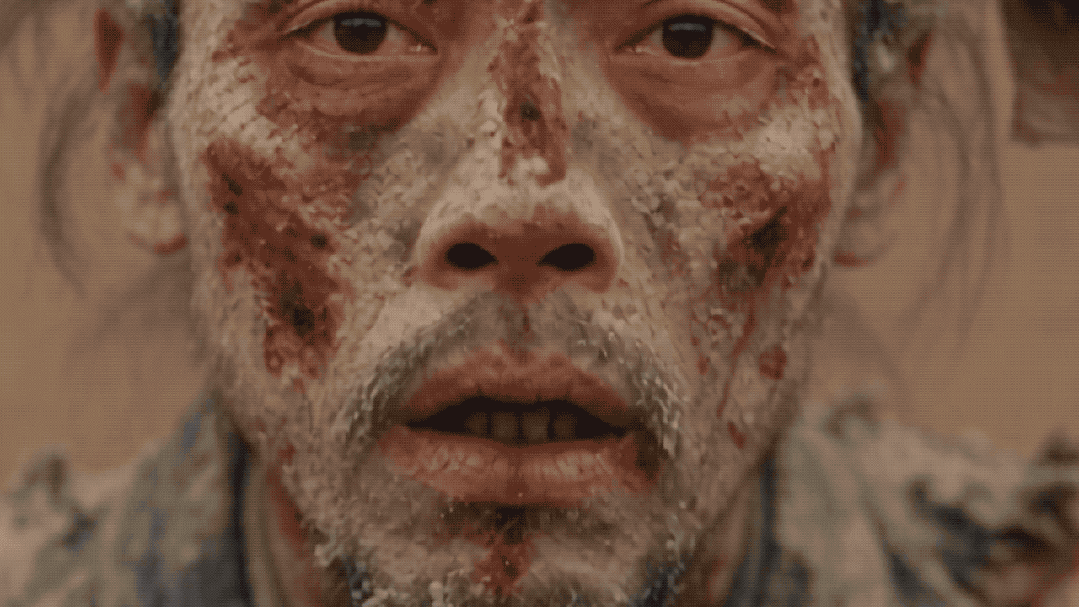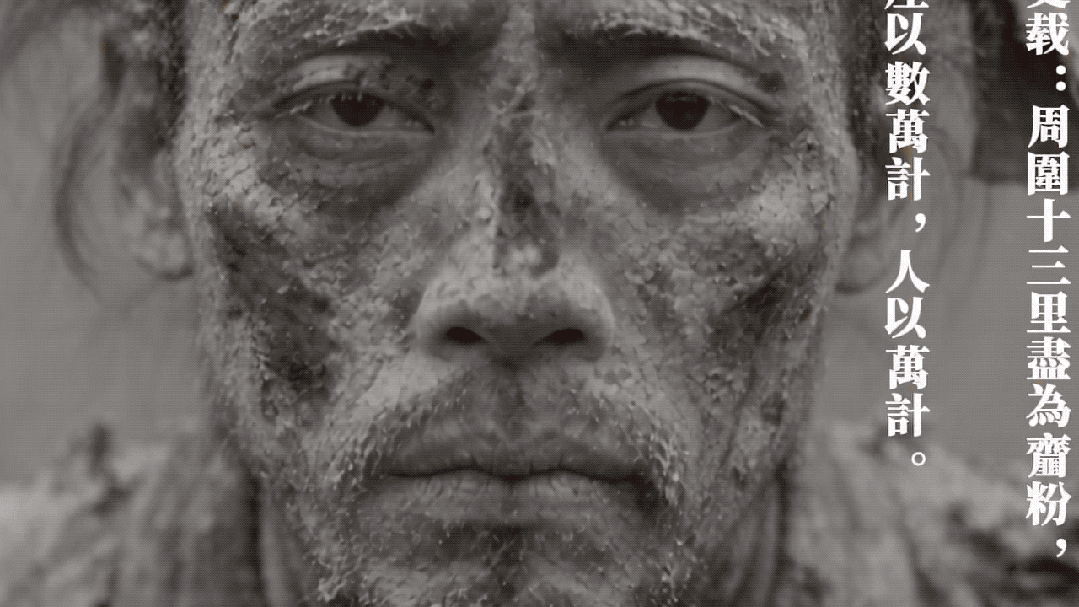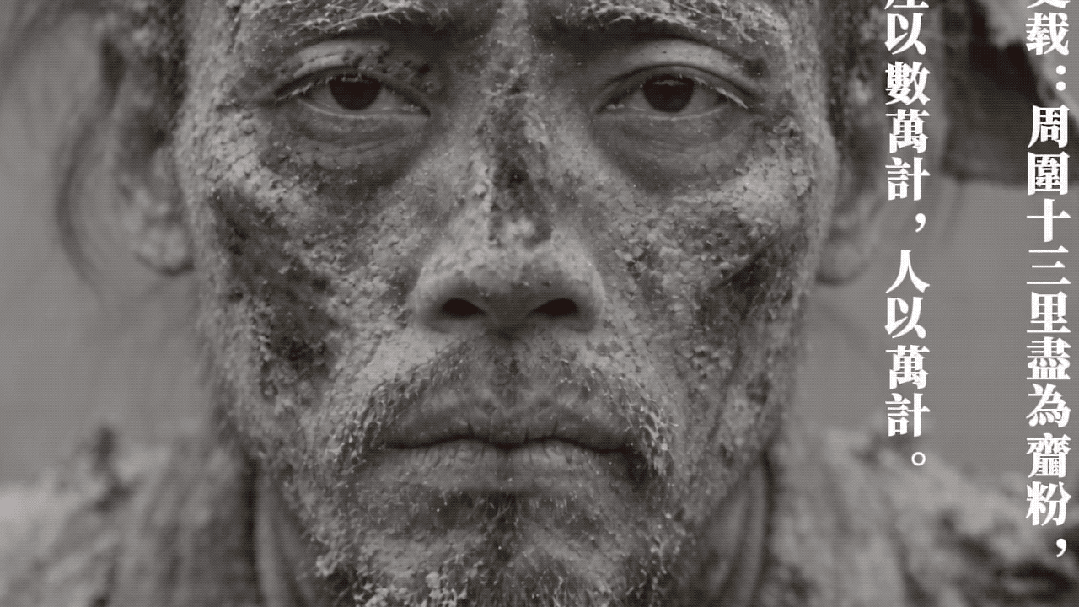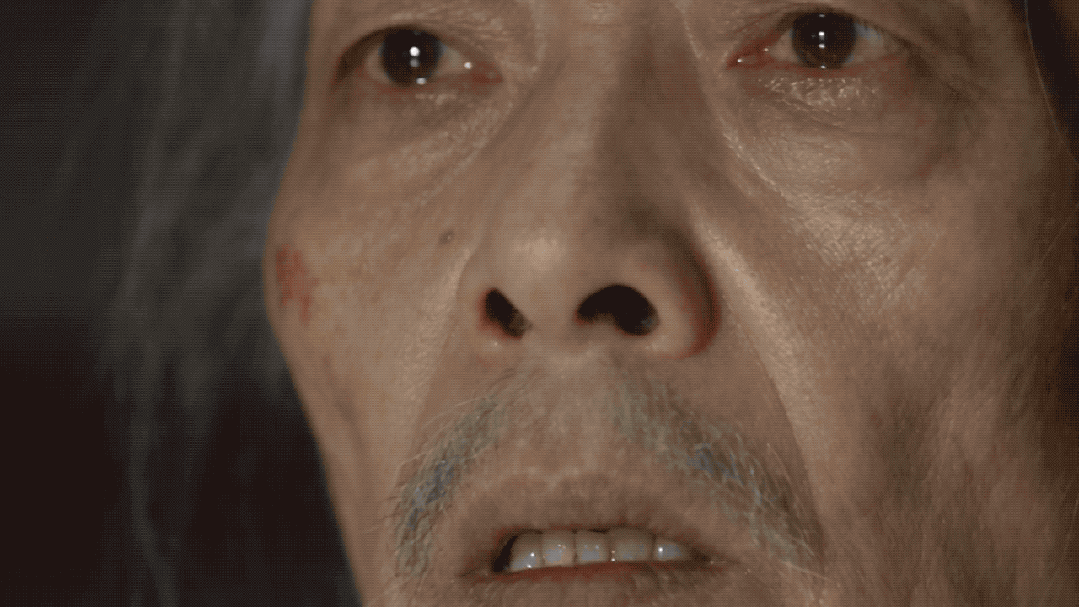
人物的脸、皮肤、神态已经相当逼真,几个明代人物也不再是过去那种一眼AI的塑料感。
再看爆炸。烟尘、碎片、火光一起往外冲,这种最容易穿帮的复杂场面,也都稳稳接住了。
要按传统影视工业的路子来,过去光是一场爆炸戏,就要耗费19天。
这次,陆川团队把史料里的文字一点点翻译成现代视觉概念,前后大约做了四轮提示词优化,再参考真实爆炸影像去校准。
最后,阿里视频生成模型对烟尘、碎片这些复杂画面的还原,准确度已经达到团队预期的95%以上。
现在的AI已经进化到不只是给导演吐几段素材而已了。
从史料搜集、画面制作到主题讨论,它开始进入完整创作链路;单在视频生成环节,阿里模型的贡献度就超过了一半。
9月22日,在云栖大会上,阿里云又来了一波大的,直接把模型家底都端了上来。
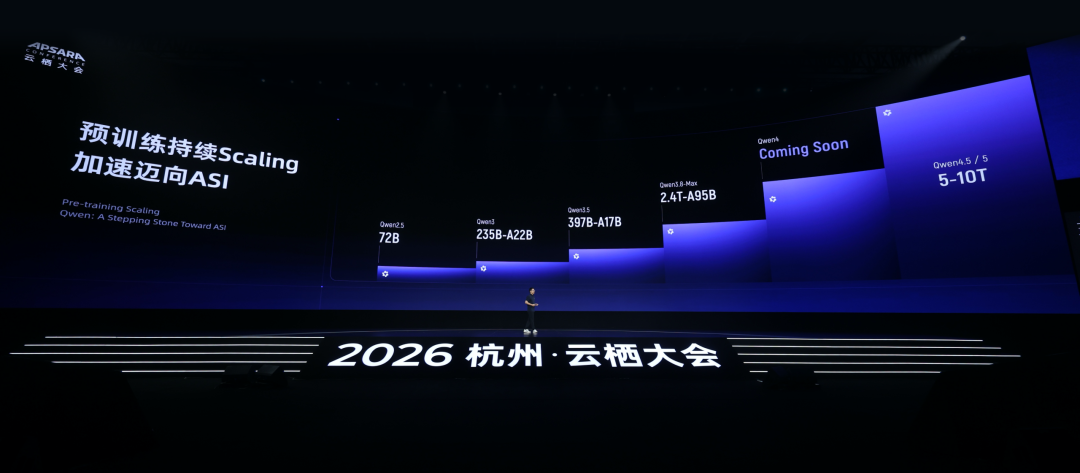
先看千问基座模型,架构、自我进化、全模态、参数规模,几乎每一层都在往前推:
Qwen3.8-Max开始自己训练自己,Qwen3.8-Flash提前放出下一代架构,Qwen3.8-Omni为大模型开辟全新的思考分区,Qwen4已经开练,Qwen4.5、Qwen5也在路上。
而且,参数规模更是直接瞄准5万亿~10万亿。
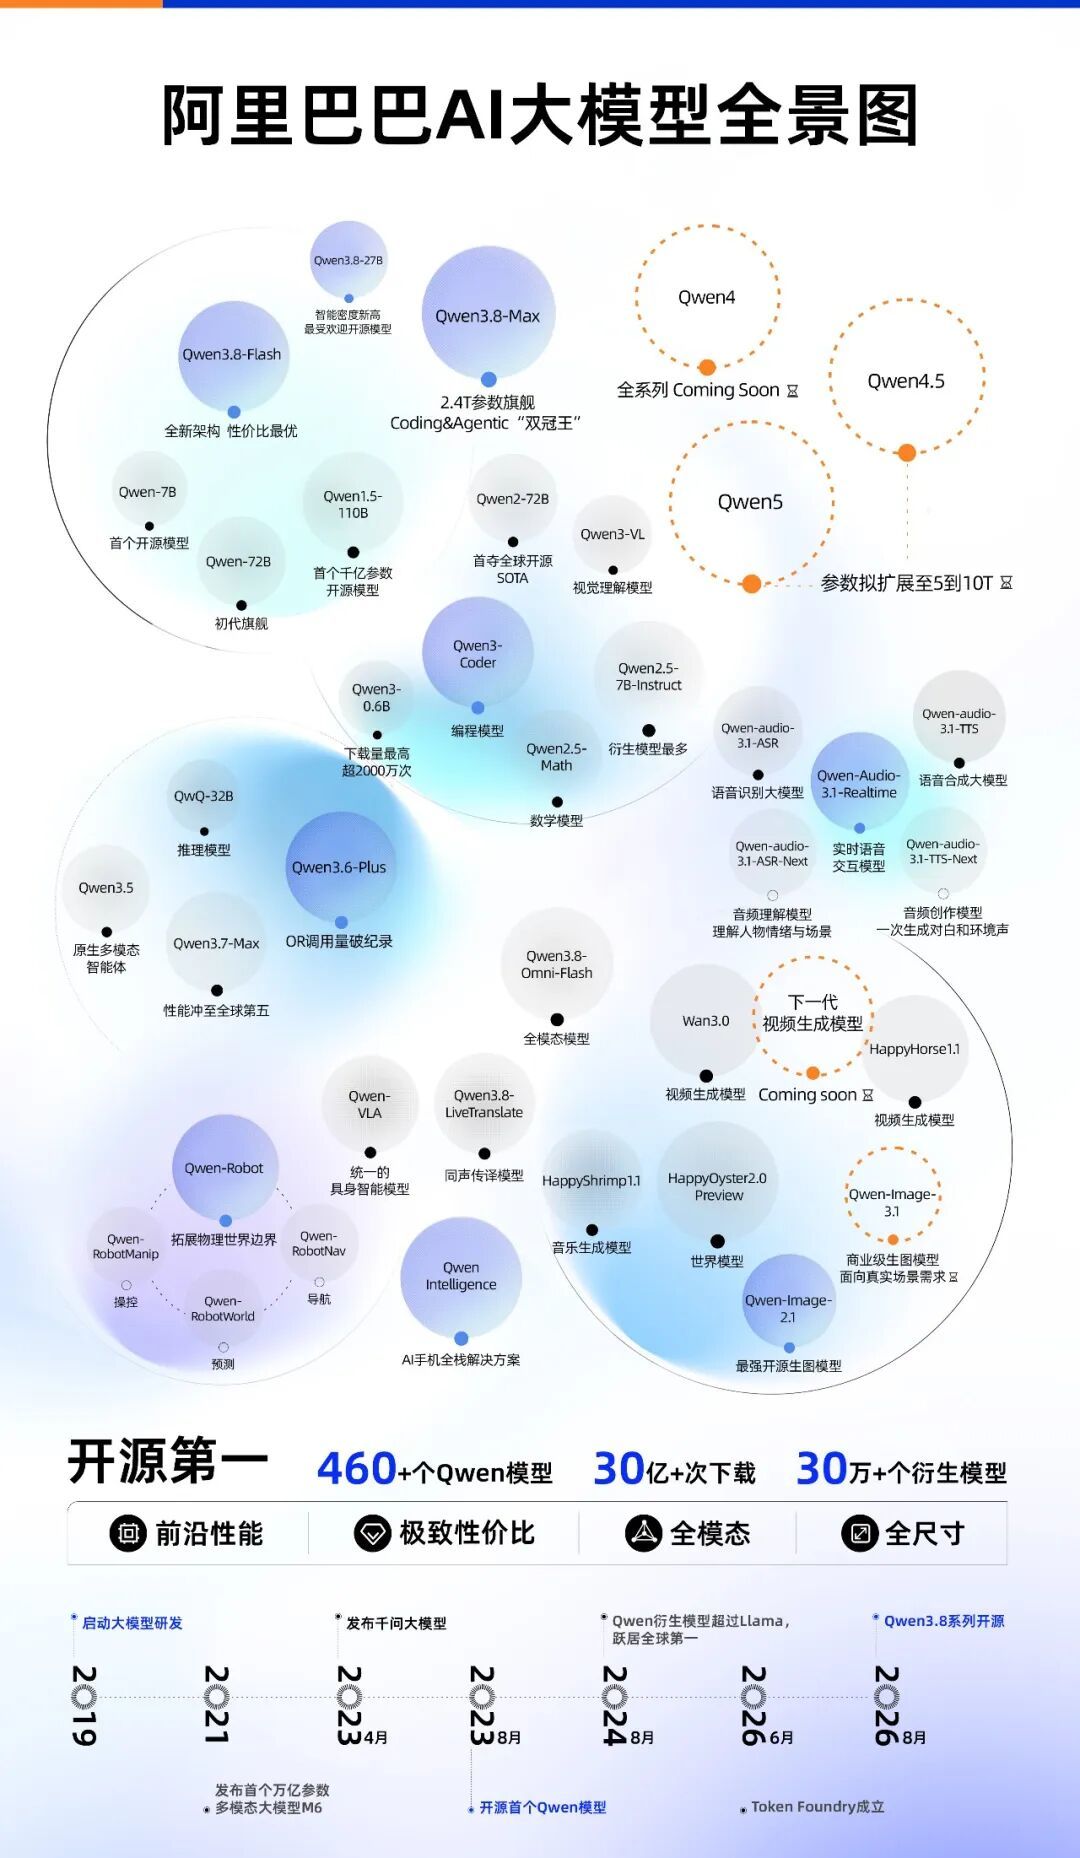
另外,图像生成模型Qwen-Image-3.1、音乐生成模型Happy Shrimp 1.1、世界模型HappyOyster 2.0 Preview、语音模型家族Qwen-Audio-3.1、同声传译模型Qwen3.8-LiveTranslate也集体亮相。
下一代视频生成模型则预告将于11月发布。
单拎哪个模型出来,都能讲半天。但结合陆川的短片,放在一起看,味道就不一样了。
阿里这一轮全模态升级,已经不太像是在补单项能力。它更在意的,是这些模型能不能更快进入场景,变成真正的生产力。
阿里的全模态拼图,基本铺齐了
把这次云栖大会的模型更新全部摊开,一张相当完整的全模态地图已经摆在眼前。
文字和通用智能这边,有Qwen3.8,以及已经投入训练的Qwen4。
往外看,图像生成与编辑有Qwen-Image-3.1;视频生成有Wan、Happy Horse系列,以及计划11月发布的下一代视频模型;声音这边是Qwen-Audio-3.1,音乐则交给Happy Shrimp 1.1。
再往真实世界延伸,HappyOyster 2.0 Preview开始处理世界模型和交互环境;Qwen3.8-Omni-Flash把文字、图片、音频、视频放进统一理解框架;Qwen Intelligence继续把Agent能力推向手机终端。
这一串名字看下来,很容易有种新品发布会开到停不下来的感觉。
可把它们塞进一项具体任务里,关系就清楚多了。
拍一条广告,脚本、商品图、人物、口播、音乐,本来就混在一起;做一部电影也一样。
导演给模型的可能是一段文字、一张参考图、一首音乐,最后交付的是一套完整的视听内容。
现实任务天然就是混合模态的。
文字、图像、视频、声音、空间信息往往同时出现,模型最终要处理的,也很少是一种单独的信息。
现实任务不分模态,模型也很难再一项一项地做。
云栖大会现场,阿里巴巴ATH事业群副总裁、淘天集团首席科学家郑波提到:
文本、图像、视频、声音、空间的能力正在加速协同,AI也从生成一张图、一段视频、一首音乐,继续走向理解人的意图,创造完整沉浸式视听体验。
阿里方面判断:如果语言模型是机器的大脑,多模态模型正在成为机器感知世界、创造内容并与物理世界互动的中枢。
这时候再回头看阿里这一整套模型布局,关系就更清楚了。
Qwen负责语言、知识和推理;Image、Wan、Happy Horse、Audio、Happy Shrimp把能力往视觉、影像、声音和音乐延伸;HappyOyster再往三维空间和交互环境里走。
Omni继续处理不同模态之间的统一理解,Agent则把这些能力接进实际任务。
当这些能力开始被放进同一条任务链里,评价标准也跟着变了。
一张图生成得多漂亮,一段视频有多炸裂,依然重要。到了生产环境里,还会多出一长串更现实的考题。
能不能稳定交付,能不能连续工作,能不能理解同一个任务?
从Demo走进生产线,多模态开始接受真考验
这些问题,只有进了真实工作流才会彻底暴露出来。
第一层:内容生产
这是最成熟的一层,也是视频模型最先撞上的考题。
Wan3.0已经支持单次30秒生成,还能接受文档、表格、网页等结构化输入。
据阿里披露,它曾经在Artificial Analysis的文生视频和视频编辑两项榜单上位列第一。
但到了商业场景,榜单只能算入场券。
比如广告,一条片子里的商品外观、Logo、人物和口播只要有一个漂掉,前面生成得再炫也很难直接交付。
这套更苛刻的指标,同样落在了图像、语音、音乐等其他模态上。
「能不能稳定生产」,已经成为多模态进入生产环境后的核心考题。
不过,Wan3.0已经拿到正向反馈了。据使用者介绍,Wan3.0已接近真实广告拍摄水平。
第二层:进入专业创作
陆川的《历史·现场》就是一个很典型的样本。
5天重建一场400年前的历史现场很惊艳,但这次尝试更有意思的地方,其实是它把AI带到了创作者真正难啃的位置。
通用模型很容易生成大家熟悉的古装剧质感,真正的历史现场反而需要陌生感,需要更严谨的史料,也需要模型理解导演到底想表达什么。
对此,阿里巴巴视频生成模型技术负责人表示,未来将与更多导演、行业专家及历史学者合作,为模型引入更全面、更严谨的专业信息。
到了这里,模型面对的已经不只是画面质量,还要开始理解专业知识和创作意图。
音乐创作遇到的则是另一套难题。
9月22日下午,在2026云栖大会的视听分论坛上,太合音乐集团总裁余灏坦言,AI给音乐行业带来的焦虑并不新鲜。
电子合成器、MIDI(乐器数字接口)、DAW(数字音频工作站)都曾经引发过类似担忧,但最后都变成了新的生产工具。
而现在,AI又把音乐创作成本往下压了一大截,普通用户和专业艺人都开始把它当生产力工具。
但音乐一旦进入产业,问题马上变得比「能不能生成一首歌」复杂得多。
训练素材怎么获得,版权怎么算,AI翻唱该不该授权,收益怎么分,这些都绕不过去。
太合和阿里Happy Shrimp的合作,也开始往音乐人共创、产业生态、版权机制和AI音乐新消费场景延伸。
余灏特别提到,无授权AI翻唱的成本太低,大量版本泛滥,会直接侵蚀原版版权方和艺人的价值。
这时候,AI音乐已经从一个创作工具,进入到了产业规则这一层。
小旭音乐创始人卢小旭在论坛上的分享,更像是一张「多模态生产流程图」。
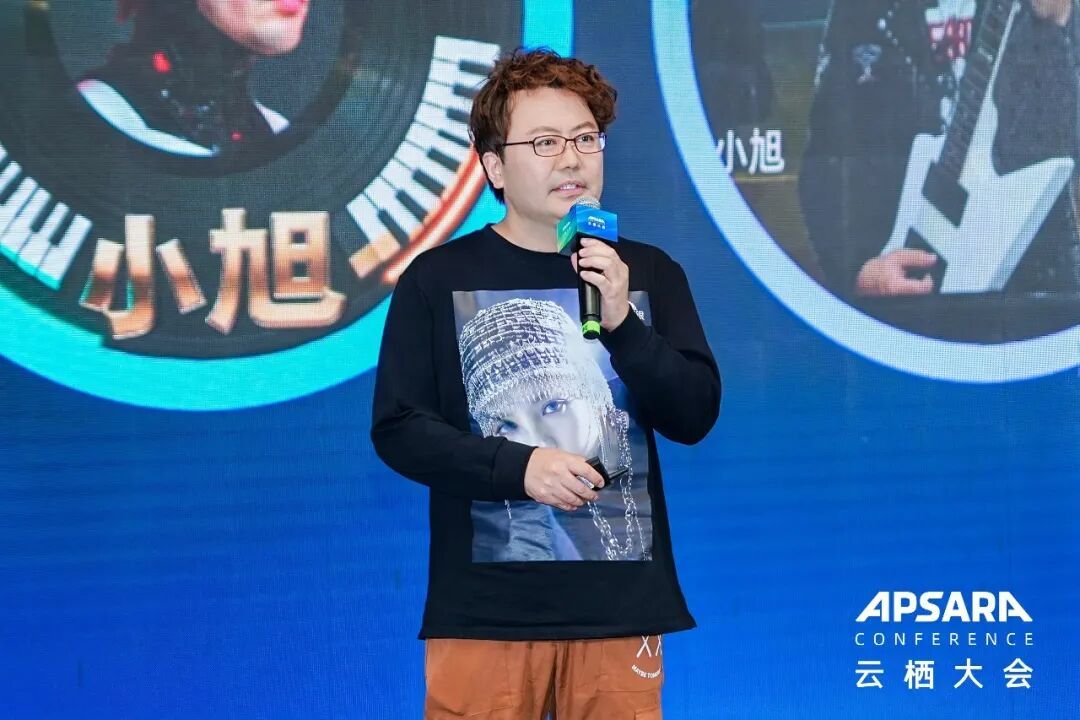
他的工作室做AI歌手,单靠一个模型根本跑不下来。
先做人设和视觉锚点,再用音乐模型做歌曲、人声和编曲,接着把音乐交给视频模型做MV和对口型视频,后面还要接大模型做评论抓取、分类和运营反馈。
整个流程本身,就是一个多模型协同工作流。
不过,这套生意还远没到闭眼复制的阶段。
卢小旭提到,他们平均4个项目才能跑出1个成功AI歌手账号。
但小团队的生产效率,在阿里多模态模型的加持下,已经被明显拉高。
据他透露,其团队6个人就能孵化十多个AI歌手IP,一些账号4个月涨粉20万,全网累计播放量突破2亿。
这几个案例放在一起看,会发现专业创作对模型提出的要求完全不同于普通生成。
电影要理解导演意图,音乐要处理版权和产业规则,AI歌手还得把音乐、视觉、人设、运营串成一整套工作流。
进入专业创作之后,多模态拼的已经不只是生成质量,还要能吃进专业知识,理解创作目标,并接进完整生产流程。
第三层:进入终端和物理世界
再往外走,多模态开始离开内容产业。
目前,千问端到端全双工实时语音交互大模型Qwen-Audio-3.1-Realtime,已经进入千问办公、Qoder(阿里智能体编程工作台)、千问AI眼镜、随身助理和桌面机器人等,能够边听、边想、边说。
Qwen Intelligence继续把Agent能力塞进手机,希望完成跨应用复杂任务。
HappyOyster 2.0 Preview则把战线拉到了物理世界。它要解决的是另一类问题:环境能不能长期保持一致,物体运动能不能符合物理规律,用户操作后能不能及时得到反馈。
这张多模态布局图已经越来越清楚:先给人生成内容,再帮人完成工作,接着让机器真正理解并作用于世界。
但问题在于,这么多单项能力越来越强,AI怎么才能在一件复杂任务里,一直记得自己到底在干什么?
多模态的下一关,是连续理解和完成任务
这个问题,在创作者那里已经出现了。
演员王珞丹在视听分论坛现场分享了她的AI创作体验。
 △