


当地时间9月22日,高通技术公司在美国夏威夷召开2026年度骁龙峰会,正式发布了基于2nm制程工艺第六代骁龙8至尊版(Snapdragon 8 Elite Gen 6)与第六代骁龙8超级至尊版(Snapdragon 8 Elite Extreme Gen 6),清晰地勾勒出了高通在“智能体AI”时代的完整技术蓝图。
高通技术公司高级副总裁兼手机业务总经理Chris Patrick表示:“今天我们迎来了重要里程碑,发布两款而非一款全新旗舰移动平台,带来即时、个性化且具备自适应能力的智能体AI体验。随着智能体AI时代持续演进,我们的多旗舰策略有助于扩展移动体验的边界,同时将最新的AI创新技术引入更广泛的旗舰终端中。通过打造两款创新的平台,我们为OEM厂商提供更丰富的选择,并共同塑造下一代智能、个性化移动体验的能力上限。”
一、智能体AI时代,移动计算架构迎来重构
当前,AI 正从“响应式助手”演变为能自主拆解任务、调用工具、持续决策的“智能体AI”(Agent AI)”。这一转变从根本上改变了移动终端的计算方式:智能体不再是“提问—回答”的单次交互,而是持续运行的“感知—记忆—推理—行动”循环,系统需同时处理多个智能体与线程,在本地与云端间动态调度,并在功耗散热约束下保持灵敏响应。
由此对于移动端的SoC设计带来三大新挑战:
一是更低的响应延迟。 智能体连续调用工具、检索信息、执行操作时,每个环节的延迟都会叠加。CPU 单线程性能直接决定每次决策与调度的速度。
二是更多的并行计算需求。端侧智能体可以同时进行语音识别、上下文检索、模型推理与应用调用,终端需要更强、更多的 CPU 核心来并行推进任务,以及不同计算引擎间的高效协同。
三是更高效的数据流动与调度。AI计算不再固定于单一计算单元(比如NPU)进行加速处理,而是需要所有计算单元协同处理:CPU 负责任务编排,GPU 负责图形与部分 AI 计算,NPU 承担高能效推理,同时还需要强大的内存系统来持续、高效地供给数据。
因此,决定移动端智能体AI体验的不再是单个 CPU、GPU 或 NPU 的峰值算力,而是这些计算资源能否被高效地协同和利用。移动芯片的竞争,正从“单项性能竞争”转向“系统级计算效率竞争”。
高通CEO安蒙(Cristiano Amon)表示:“AI变化如此之快。我们看到了混合专家模型、编排器、全新模型的发展。我们看到MCP协议正在规模化,使智能体能够连接互联网上的不同服务。我们看到智能体在没有开发技能的情况下发展。所以所有这些技术结合在一起,使智能手机向AI智能手机的过渡成为可能。这不再是将来才会发生的事情,它正在发生,这就是我今天的工作——向你们展示这个过渡的开始。我们正在从应用和助手转向智能体。我们现在正处于智能体时代的开端,第六代骁龙8至尊版平台系列正是为之而生的平台。”
二、双旗舰战略:一次史无前例的产品布局
高通首次在骁龙旗舰移动产品线上同时推出两款骁龙8至尊版平台。全新的“双旗舰”的战略,旨在为客户提供更大灵活性,同时将骁龙旗舰体验带给生态系统中的更多终端。
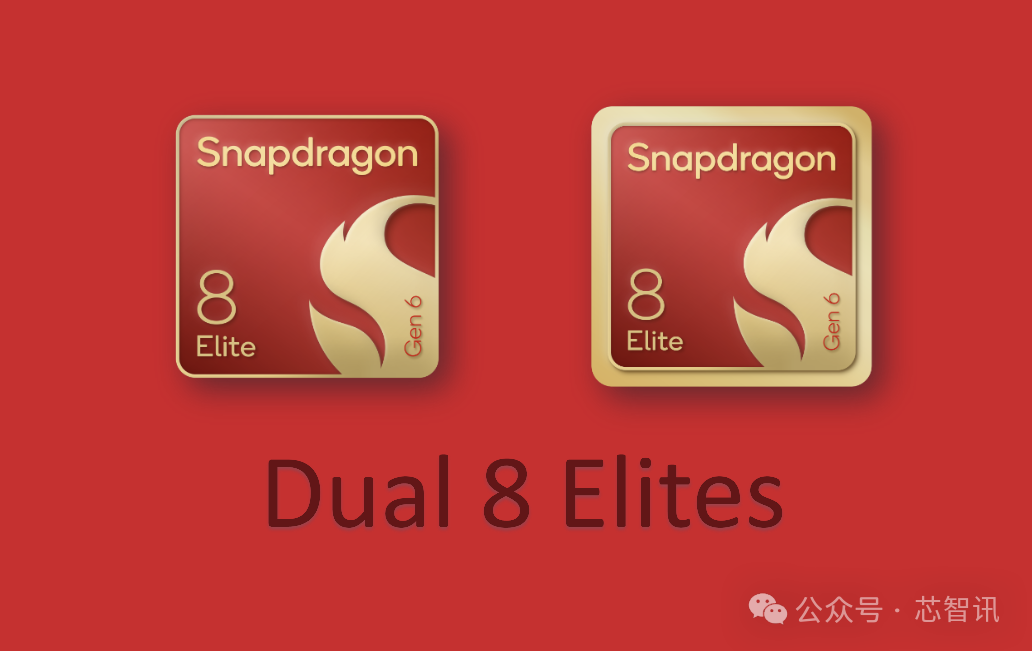
其中,第六代骁龙8至尊版定位为面向更广泛设备的旗舰体验平台,在顶级性能与出色智能之间实现平衡,满足消费者对旗舰体验的普遍需求。
第六代骁龙8超级至尊版则代表骁龙创新的巅峰,专为最先进的AI工作负载和定义智能体时代的体验而打造。它主要面向顶级旗舰,覆盖AI、消费者体验、游戏、创作者、视频、相机能力等所有技术维度,并采用尖端的2nm制程和先进封装技术以获得更好的持续性能和整体计算体验。
简单来说,两者虽同属旗舰,却是两个不同平台,面向不同层级的目标需求设计,封装规格也存在差异。特别是超级至尊版凭借更先进的封装技术,在持续性能与整体计算体验上更进一步。
三、Oryon CPU:5GHz超级内核
第六代骁龙8超级至尊版和第六代骁龙8至尊版均是面向最先进的AI工作负载与智能体时代的体验需求而打造。该平台基于2nm制程,采用最新一代高通Oryon CPU,拥有“2个超级内核+6个性能内核”的八核配置。其中,超级内核最高频率达到5GHz,使其成为全球首个CPU主频突破5GHz的移动平台;性能核主频也达到4GHz的高水平。
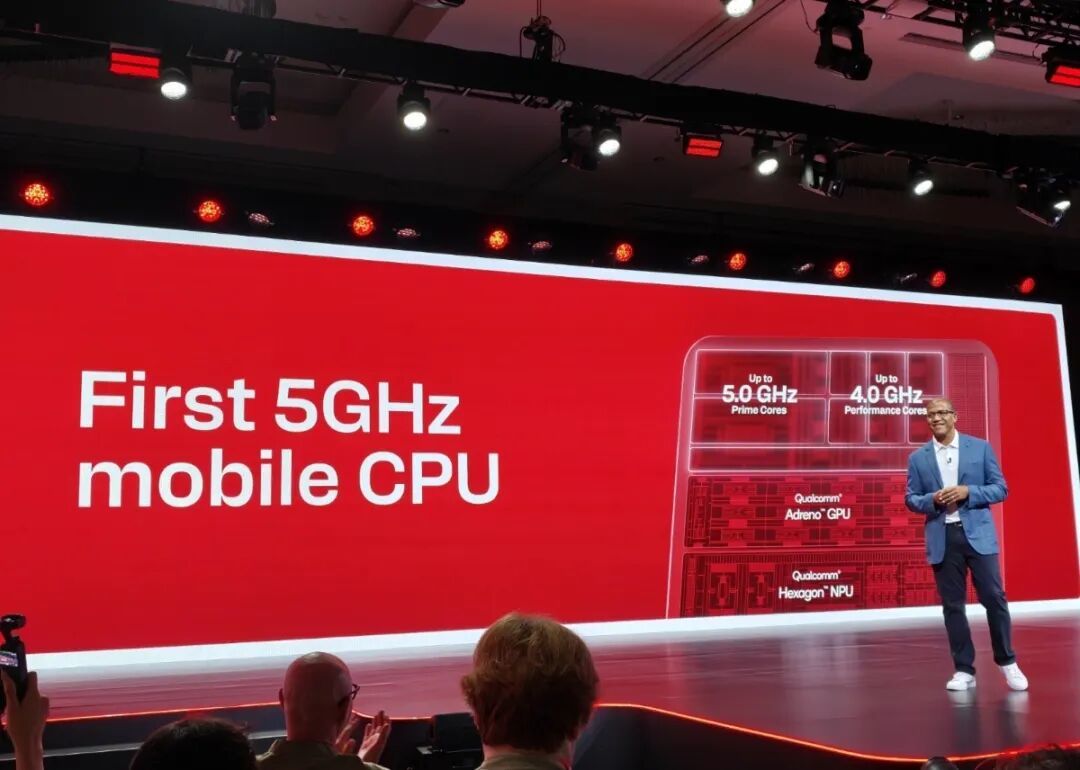
对于智能体AI而言,CPU性能至关重要。与“用户提问—模型回答”的单轮交互不同,智能体需要持续感知环境、规划任务、调用工具并根据结果进入下一轮判断。这一过程中,线程会在不同核心之间频繁迁移,工具调用往往横跨多个计算单元——CPU负责规划与调度,NPU执行推理,GPU处理视觉任务,内存持续搬运上下文。如果CPU调度不够快、核心间通信不够高效,整个智能体工作流就会在等待中空转。
换言之,智能体AI对CPU的要求不只是“算得快”,更是“调度得准、切换得快、协作得顺”。5GHz超级内核与4GHz性能核的组合,正是为这种持续在线、多任务并行的智能体负载提供的性能底座。
不过,高通也强调,时钟频率并非卓越CPU性能的唯一关键,速度还需与出色的IPC相结合,使性能优势在实际使用场景中充分体现。
四、全新缓存架构FlexCache
更值得关注的是,第六代骁龙8超级至尊版采用了全新的FlexCache缓存架构。它延续了高通可扩展架构的核心设计理念,扩展了内存层级架构的构建方式,允许在保持低延时的前提下,动态地分配缓存池。
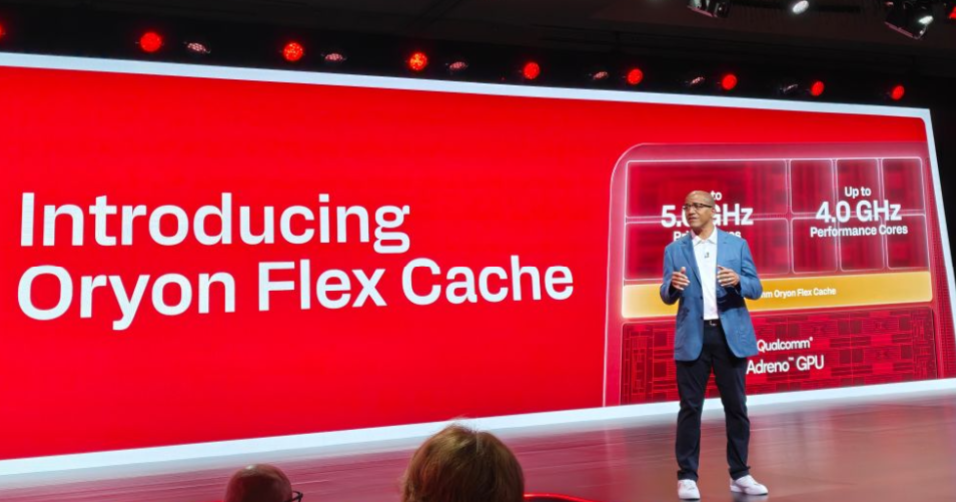
比如,超级内核在运行高负载任务时,可以根据工作负载需求调用整个缓存池,从而将更高的工作负载保留在缓存中,减少对系统内存的访问。这种动态缓存方式在游戏、视频编辑、多任务处理等高要求单线程工作负载中可带来出色性能表现。
对于智能体AI应用,FlexCache允许智能体AI运行高负载任务而不降低响应速度——工作负载可能在超级内核和性能内核之间移动,而数据驻留在一个大缓存池中,可以快速访问、随时可用,使体验更快、更无缝、更流畅。
五、传感中枢:双Micro NPU与Personal Scribe
当智能体AI能够理解你、记住上下文,并可随时间学习时,它会变得强大得多。为此,高通为第六代骁龙8超级至尊版带来了全新传感中枢,其搭载两个Micro NPU,性能提升高达85%,能效提升20%,并可支持高达2亿参数的模型本地运行。
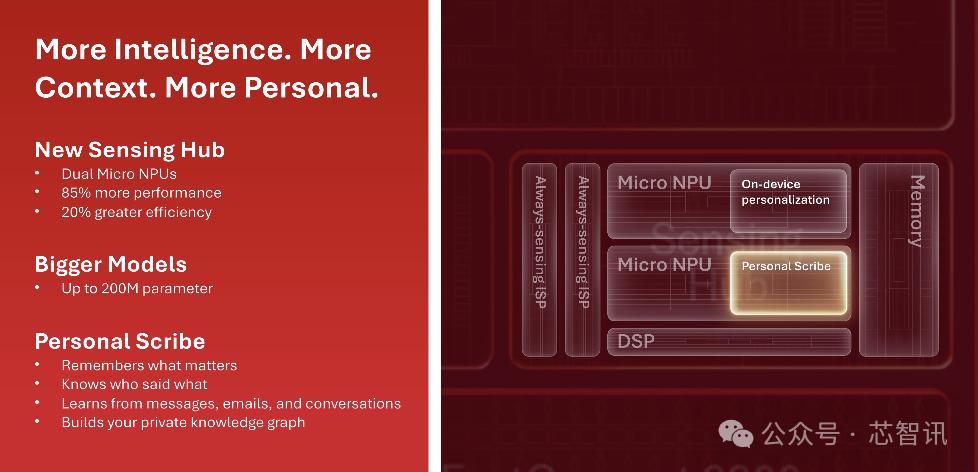
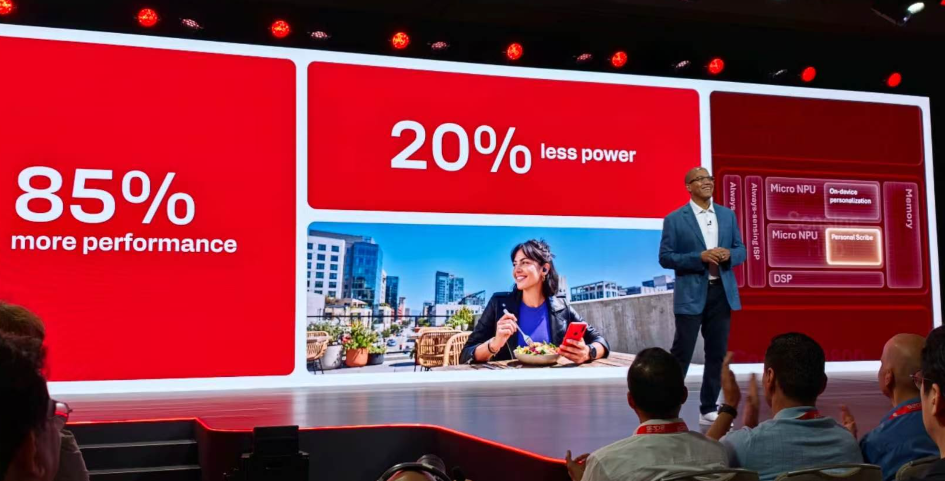
同时,高通改进了Personal Scribe功能。它帮助创建持续的个人上下文层,从用户选择保留的信息、对话内容以及重要事项中学习。这一体验在骁龙峰会上,从合作伙伴处也看到了落地。
在整体芯片架构中,传感中枢负责处理环境语音。当SoC其他模块处于空闲状态时,传感中枢可始终感知环境语音,实现“环境语音感知从不间断”的体验。
六、Hexagon NPU:Element Accelerator与内存扩展
作为第六代骁龙8超级至尊版应对AI计算的最关键的核心,全新的Hexagon NPU带来两项突出的新特性。
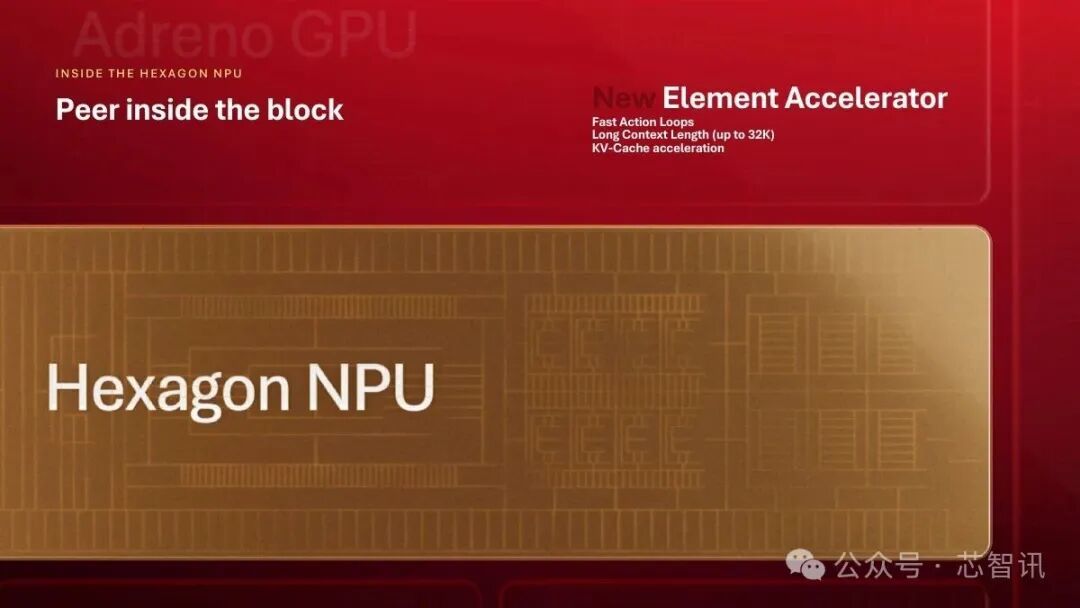
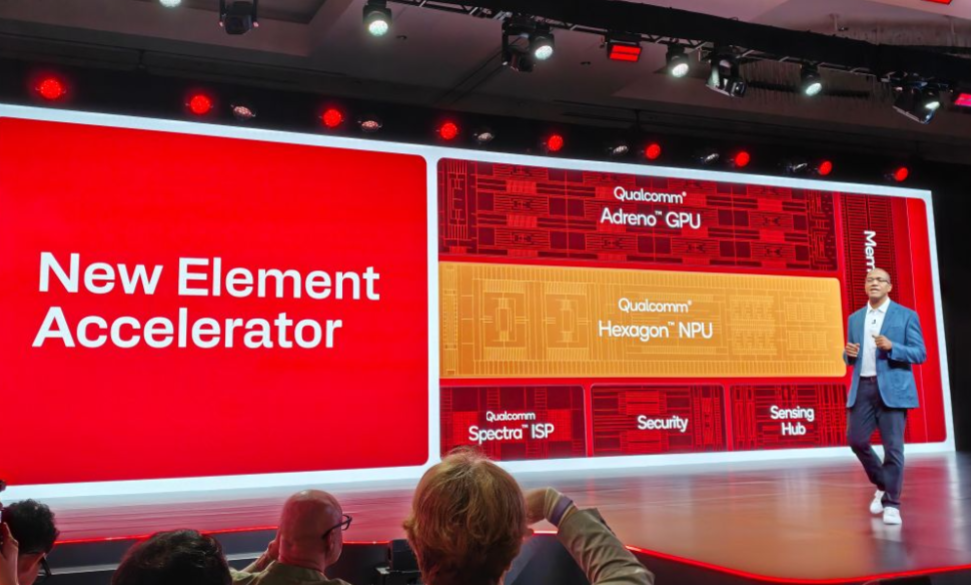
首先,它新增了一个专为支持现代智能体AI的Transformer运算设计的全新Element Accelerator(元素加速器)。通过结合向量计算单元(Vector) 和标量计算单元(Scalar) ,可进一步加速大模型中最关键的Transformer运算,帮助智能体更快响应、更高效推理,并在不牺牲整体能效的前提下提供更丰富体验。
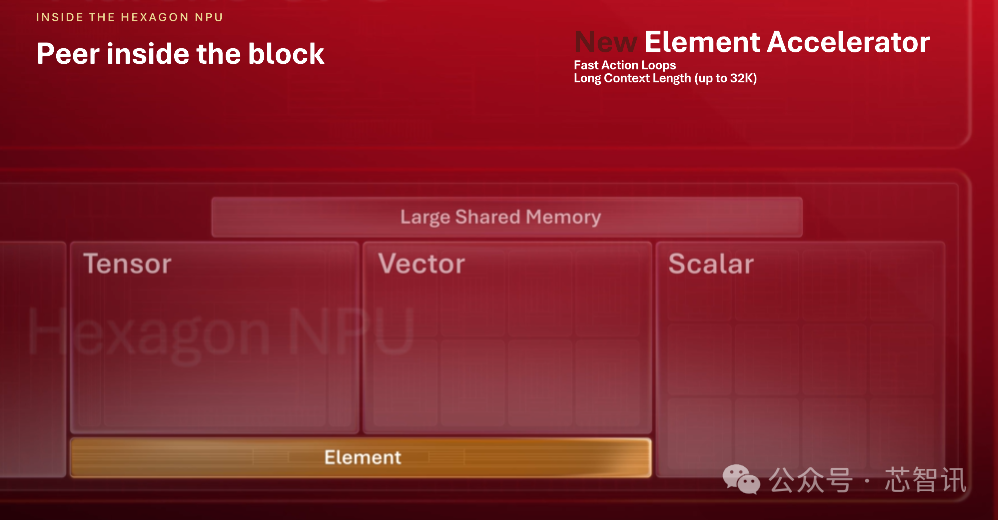
并且,全新Element Accelerator还支持最长32K的上下文长度,并包含KV-Cache加速。
支持最长32K的上下文长度,这意味着设备端可以一次性处理更长的对话历史、更复杂的文档或多轮任务规划,而无需频繁截断或遗忘早期信息。对于需要保持长期记忆的智能体应用至关重要。
KV-Cache是大模型推理过程中用于缓存已计算键值对的关键机制,加入了专门的KV-Cache硬件加速器,将直接提升生成速度和内存效率。
其次,全新的Hexagon NPU还将大型共享内存显著扩展了50%,可以把更长的上下文和KV-Cache数据保留在NPU内部。这意味着可以减少访问外部DDR,减少内存读取,降低时延,并为其他工作负载释放宝贵的内存带宽。
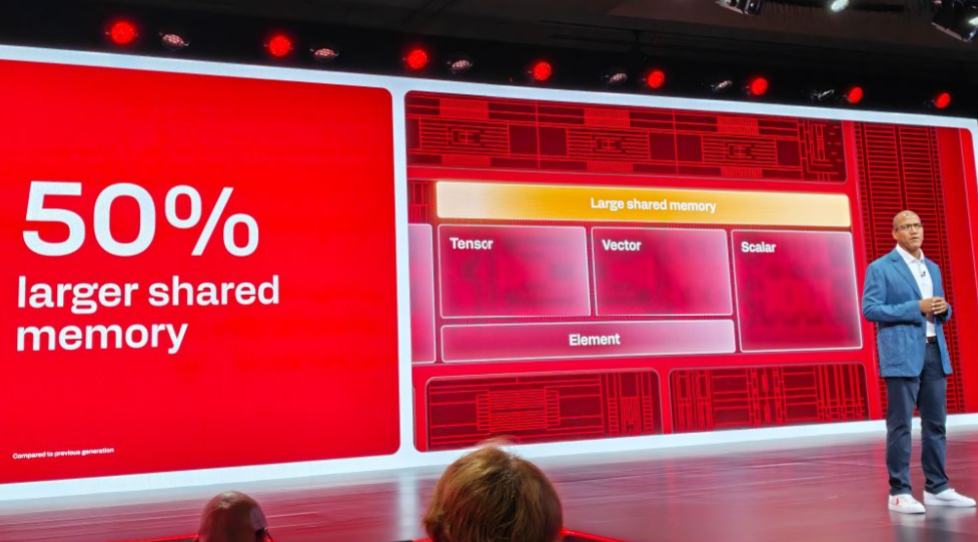
因此,全新的Hexagon NPU可以更专注于推理,可以更快、更高效地输出结果。即使端侧模型处理更长的上下文窗口、更复杂推理、更多工具调用和并发任务,智能体AI体验也将实现更及时响应。
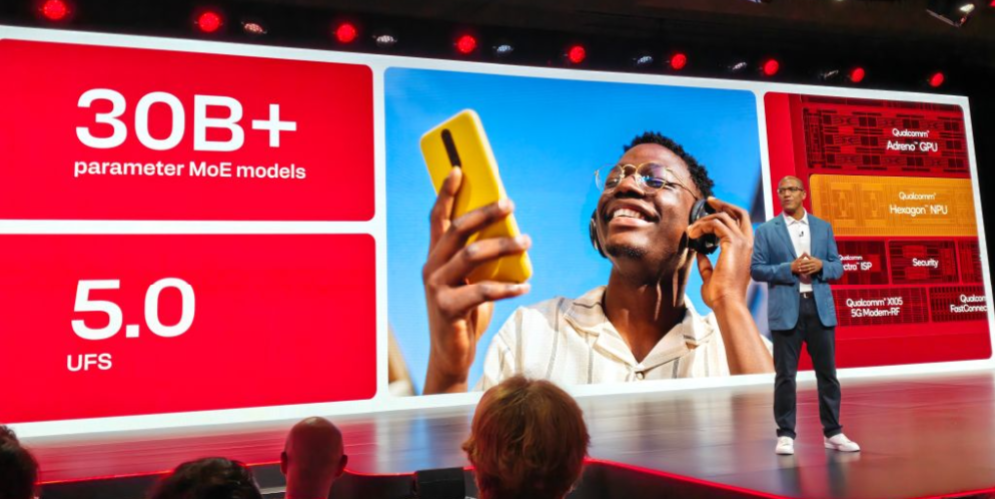
Chris Patrick表示,“Hexagon NPU结合UFS 5.0和高通智能闪存管理系统,我们现在可以在设备上运行300亿参数的模型,这在以前需要巨大的内存占用。这是边缘AI的重大进步,将接近云规模的智能带到移动设备上。”
七、Adreno GPU:三切片架构、Adreno Matrix Cores与Neural Fusion
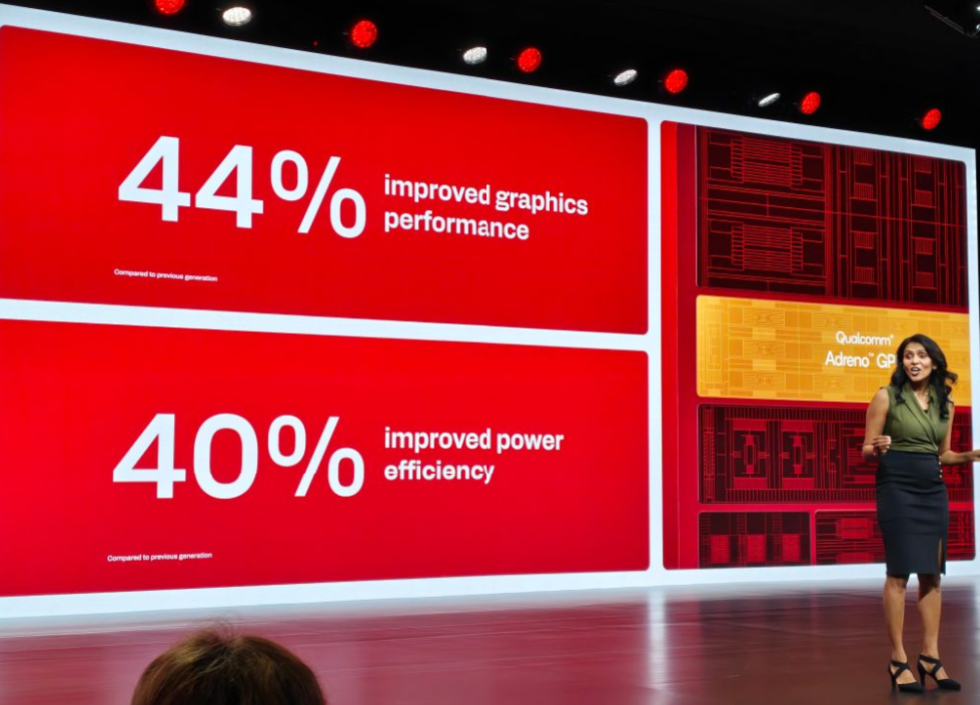
第六代骁龙超级至尊版这一代的Adreno GPU实现了整个GPU架构的重大突破,在图形性能和能效两方面带来迄今为止最大的代际跃升。高通称,Adreno GPU在性能上提升了44%,能效提升了40%。
具体来说,全新的Adreno GPU采用三切片架构,带来了能效的提升,并且每个切片的时钟频率提升了250MHz,达到了1.45GHz,这也推动了GPU渲染能力的大幅提升。
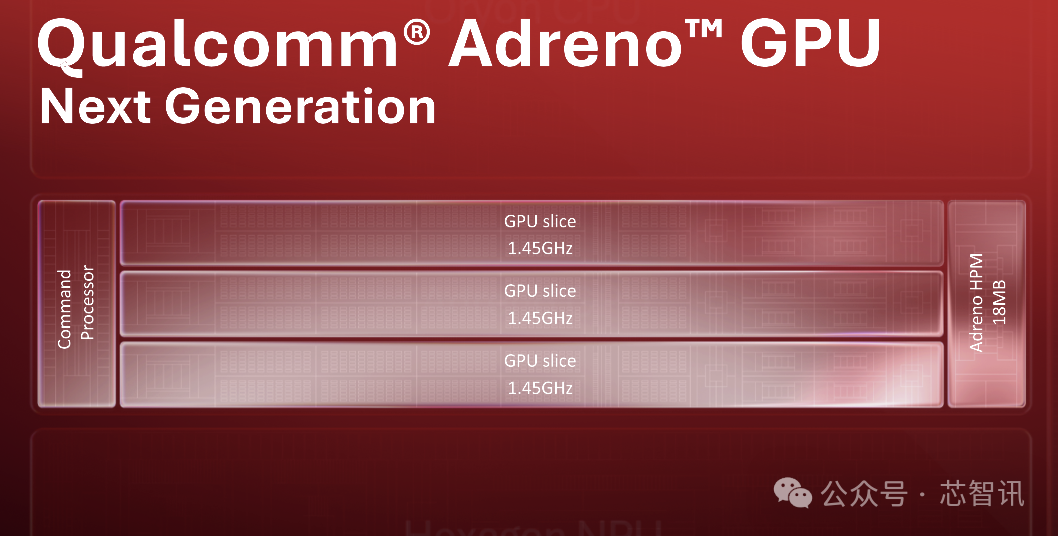
与此同时,全新的Adreno GPU还搭配了高达18MB的高性能内存(HPM),这是GPU专用片上内存,使得GPU减少了对于外部DDR的读取。
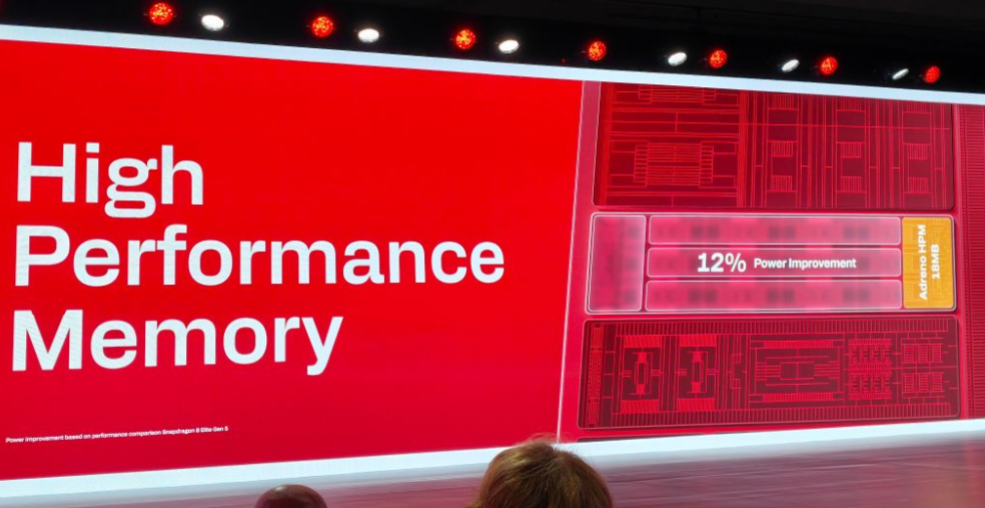
高通指出,HPM可看作可配置图形工作空间,可以存储渲染目标、深度和颜色缓冲区、之前渲染阶段的纹理以及其他中间数据。这使开发者可以把内存用在性能收益最大的地方。更少与外部DDR内存的数据传输,意味着更低时延、更高效率和更长游戏时间。高通表示,这可以带来12%的功耗改善。
更具里程碑意义的是,高通为Adreno GPU首次引入了Matrix Cores——这是GPU专用的AI核心,用于在GPU的图形管线内直接运行先进AI模型。神经网络计算不再需要离开图形管线才能完成。
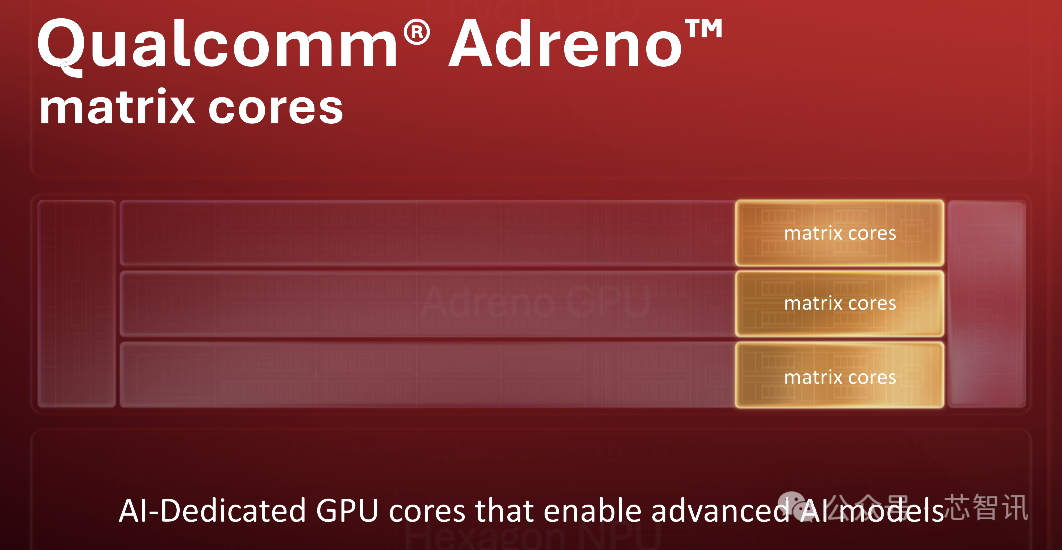
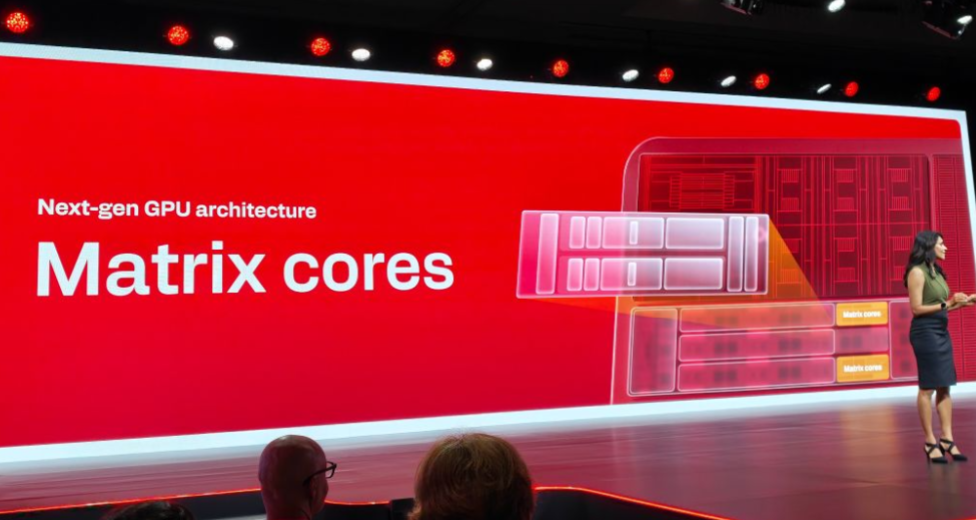
至此,高通将Matrix加速单元带入到了每个主要计算模块(NPU、CPU和GPU)。不过,需要指出的是,Matrix Cores是第六代骁龙8超级至尊版独有的,这也是其与第六代骁龙8至尊版最大的区别。
此外,第六代骁龙8超级至尊版还搭载了 Adreno Neural Fusion,这是高通专为该平台推出的一项 AI 驱动的图形渲染技术。它的核心目标是,让移动游戏摆脱“画质、帧率、续航三选二”的长期困境,实现三者兼得。即借助AI实现智能的图形渲染,从而带来更沉浸的游戏体验、更丰富的视觉效果和更持续的游戏时长。
Adreno Neural Fusion与Matrix Cores结合可谓是相得益彰,实现了AI渲染与图形处理之间更紧密的集成,能够带来增强的、极致游戏体验,支持各类游戏AI特性,比如帧生成、超级分辨率,以及支持在图形管线内部直接进行神经引擎运算。这些原本需要交由外部NPU执行的任务,现在可以直接在GPU图形管线内完成运行,这也意味着在更低功耗、更低延迟下,可实现更丰富、更持久稳定的图形增强体验。开发者甚至还可以利用Matrix Cores运行其他通用AI工作负载。
Adreno Neural Fusion还是首个在主流游戏引擎上落地的移动AI超级分辨率技术。Unity、Unreal Engine以及Messiah的文档和插件支持现已提供,这意味着游戏开发者对于该技术的集成和部署比以往更轻松。
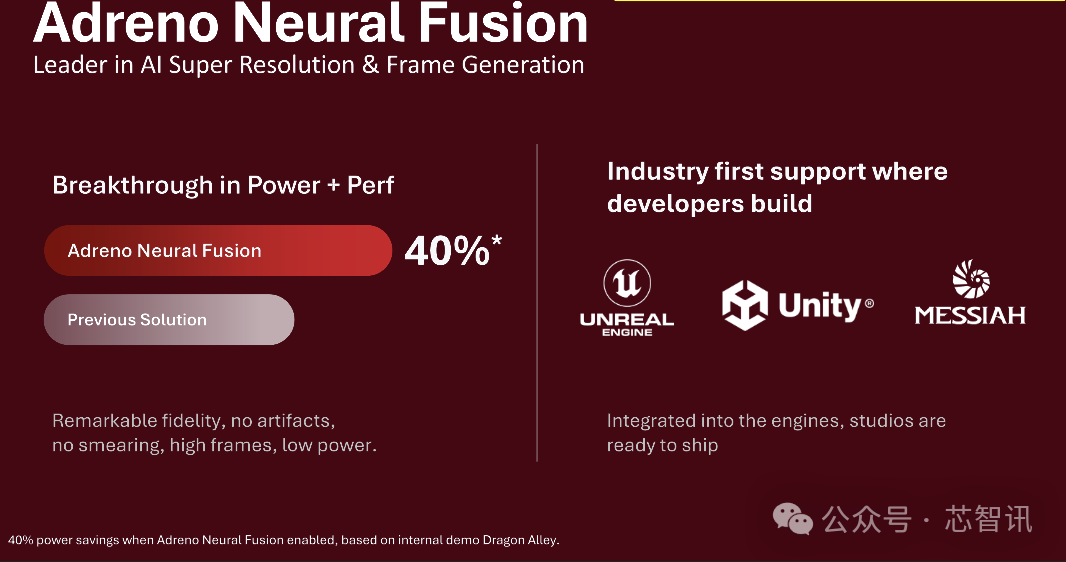
高通称,在内部“Dragon Alley”演示中,启用Neural Fusion后实现了40%的功耗节省。
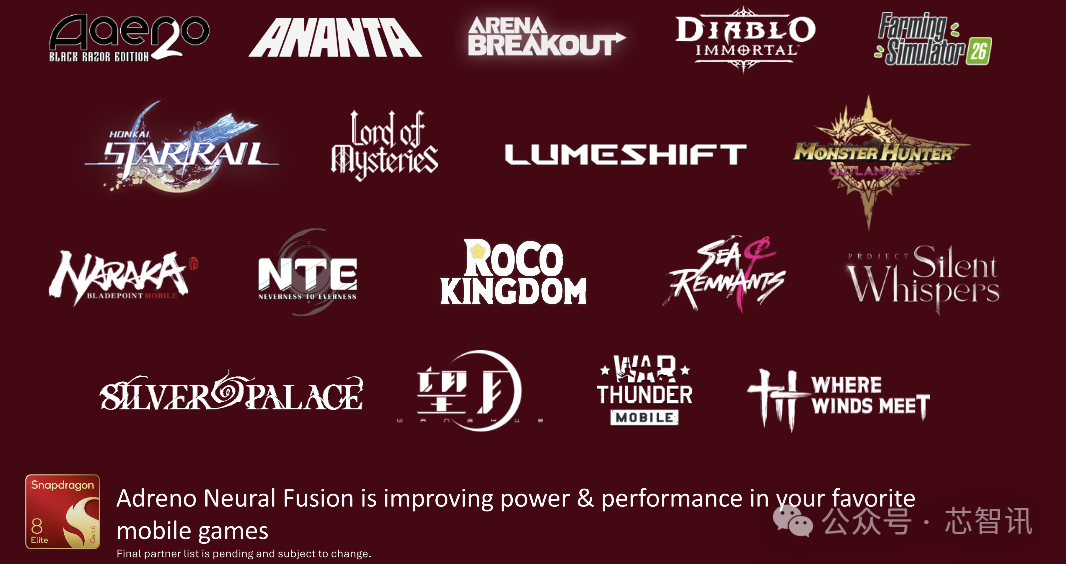
此外,高通还将与18款手机游戏合作支持Adreno Neural Fusion。对玩家而言,使用高通第六代骁龙8超级至尊版可以在游戏中体验更好的画质、更高帧率和更长游戏时间。
八、Spectra ISP:4倍视频吞吐量与16位AI像素
第六代骁龙8至尊版系列还带来了三个Spectra ISP。这一代的ISP,不再只是相机的图像信号处理管线,它与NPU实现了紧密的耦合,因此可以在图像拍摄时就进行AI处理,而不再是拍摄后再进行AI处理。
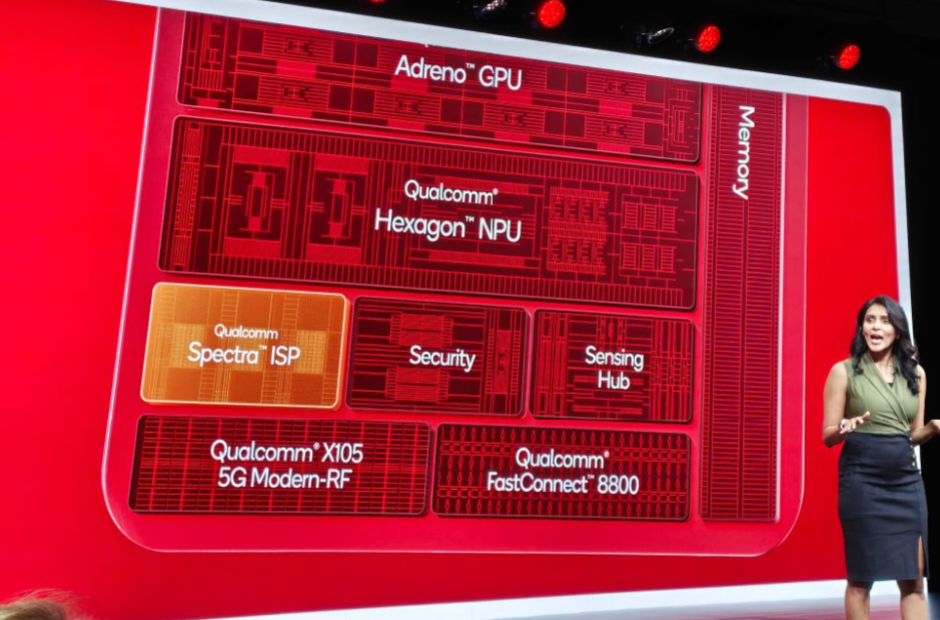
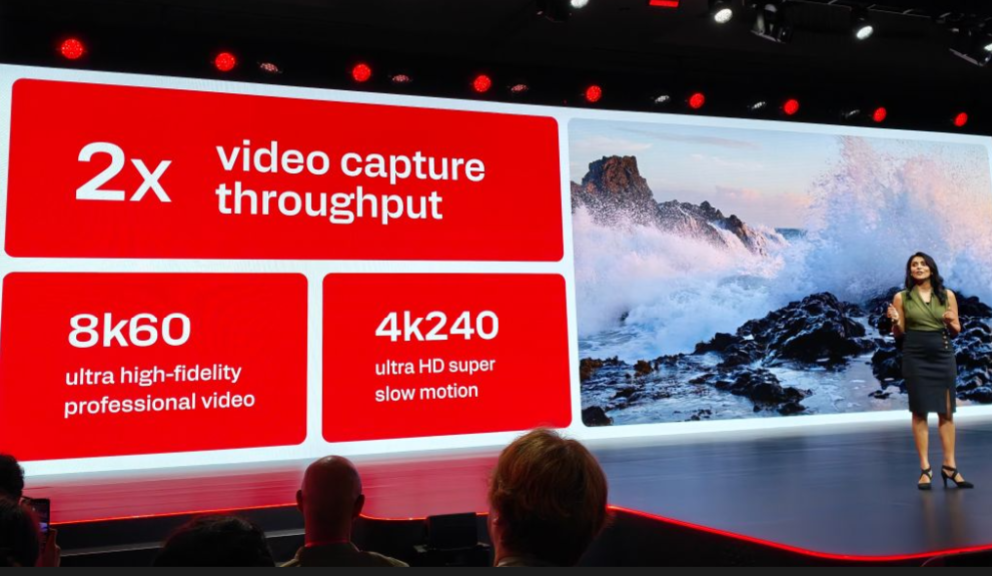
这将带来两点改变:专业级视频的原始吞吐量大幅提升4倍,以及对场景中每个像素更深入理解。这意味着首次在移动设备上可以拍摄8K 60fps视频。此外,超级慢动作视频分辨率也进一步提升,现在支持4K 240fps拍摄。
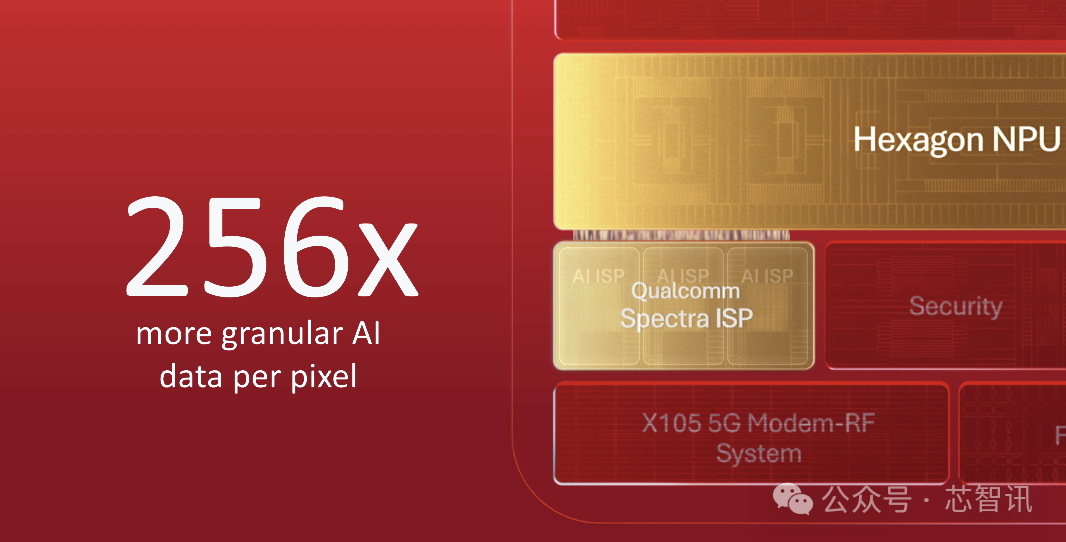
高通还升级了Spectra ISP与Hexagon NPU的连接,使NPU可以为每个像素分配16位AI数据,这比前代多了256倍的信息量。借助这一点,Spectra ISP现在可以理解场景中的每个细节。
高通解释称,ISP与AI团队合作实现了“智能像素控制”(Intelligent Pixel Control),每个像素现在有更多信息,可以跨帧追踪人物,获得更多分割内容,所有AI相机相关用例都会更高效。
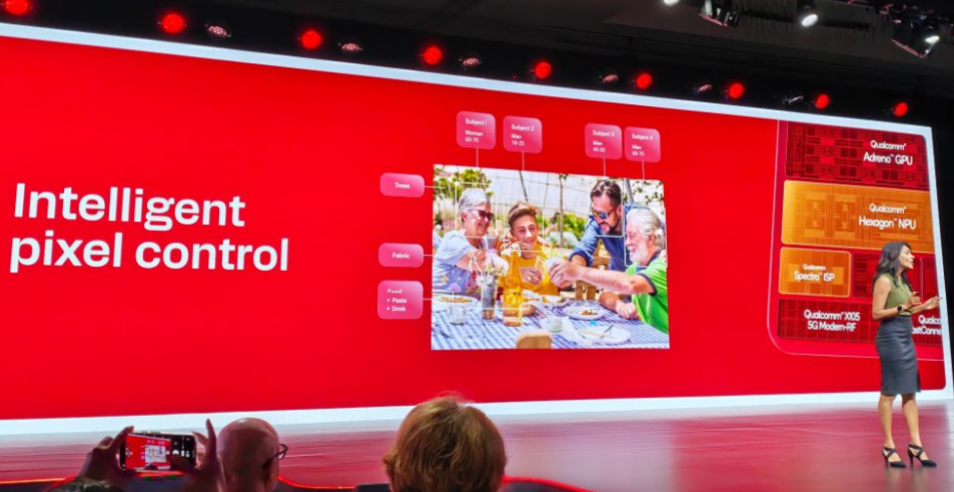
高通表示,AI赋能的影像功能与高级专业视频编解码器(APV)和智能像素控制技术相结合,实现更深入的场景理解,带来增强的图像质量和观感更自然的照片和视频。
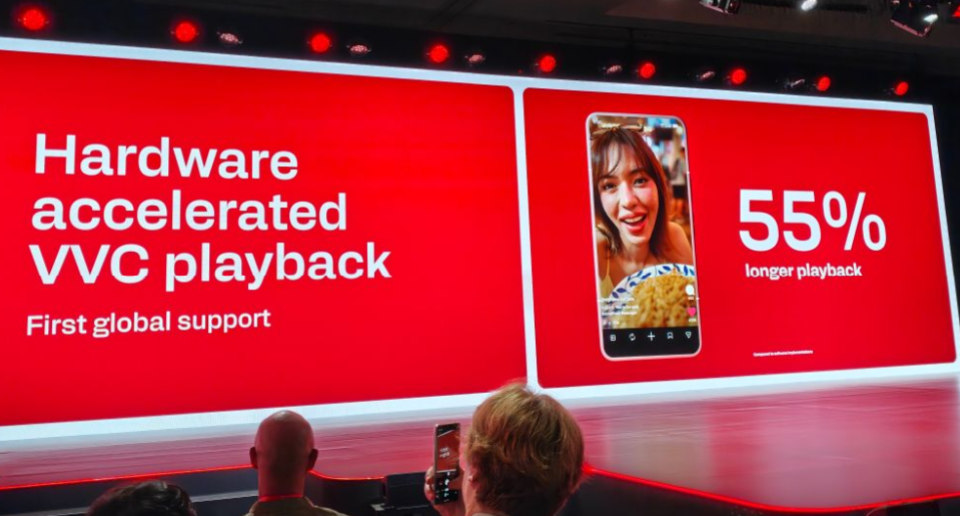
此外,第六代骁龙8超级至尊版还是全球首个支持硬件加速的VVC编解码器的全球移动平台,可提供更高效的流媒体传输,在播放期间电池续航最长可延长55%。
九、全新封装架构
第六代骁龙8至尊版系列为了在能够提供持久的强劲性能的同时,进一步更好地控制整体的功耗,因此也将系统级思维延伸物理封装平台,开发出了一种创新的热设计方法,称为偏移封装(Offset Package on Package)。
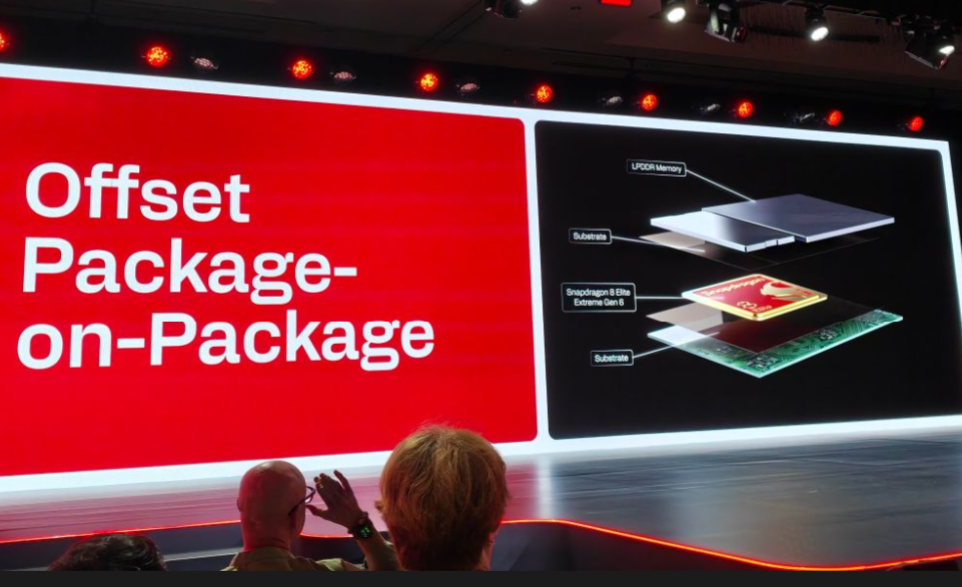
据介绍,偏移封装是通过重新构建内存和SoC在封装内的排列方式,高通创造了一条更高效的路径,从而能够将热量从处理器中更好地导出,并实现更集成的设计。
高通产品经理Lenga解释称:“在智能手机中,每一平方毫米的空间都很重要。偏移封装有助于最大化封装余量,同时也为我们的OEM合作伙伴提供了更大的灵活性来优化他们的设计,并解锁新的形态。最终的结果是,在高要求工作负载下,峰值性能延长了两倍以上。从封装到架构,平台的每一层都经过了精心设计。这就是骁龙的力量。”
十、高通X105 5G调制解调器及射频系统
第六代骁龙8超级至尊版集成了高通在今年MWC上发布的最新一代的调制解调器及射频系统,它是全球首款面向 3GPP Release 19 就绪的调制解调器,核心定位是为“智能体AI”时代打造连接基座,同时也为通往 6G 奠定了基础。
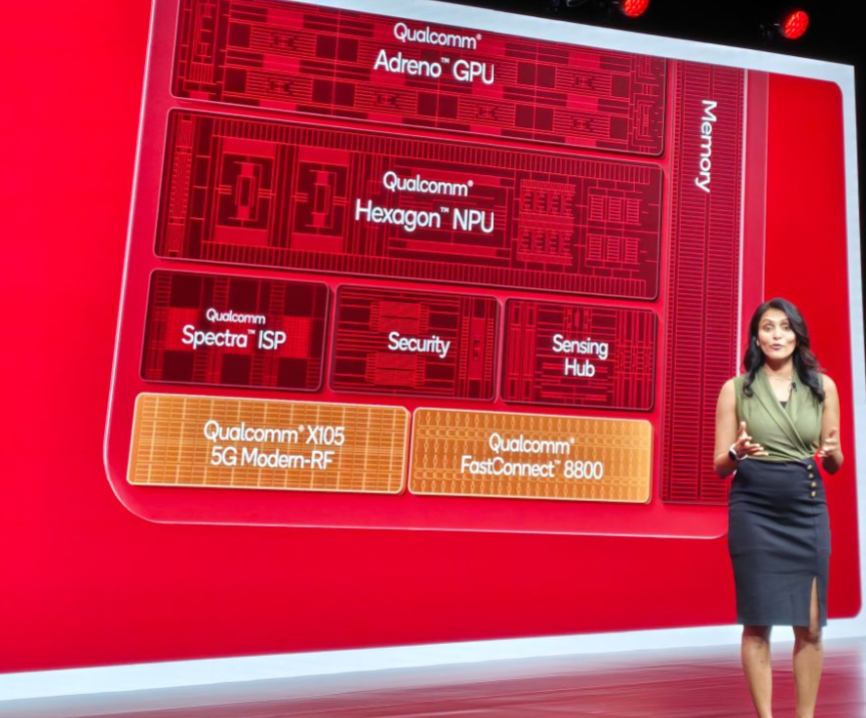
相比前代调制解调器,高通X105 在上下行速率上实现了显著跃升。其下行峰值速率高达 14.8 Gbps,在 Sub-6GHz 频段下也能达到 13.2 Gbps;上行峰值速率则为 4.2 Gbps。
此外,高通X105 还采用了全球首款 6nm 工艺的射频收发器,使得整体功耗相较前代降低高达 30%,同时占板面积也减少了 15%,为终端设备释放了更多内部空间。
作为面向“智能体AI”的5G调制解调器及射频系统,高通X105 还集成了第五代 5G AI 处理器,其核心变革在于引入了智能体AI能力。这意味着高通X105不再只是被动响应网络指令,它能够主动感知、识别并优化数据流量类型。
例如,当识别到用户在进行移动游戏、视频通话或浏览社交媒体时,AI 会动态调整连接参数,优先保障关键应用的体验。在高铁、地铁等信号快速变化的场景中,AI 可以预判小区切换与信号衰落趋势,平滑完成网络切换,有效降低卡顿和掉线概率。
高通X105 还是首个支持 NR-NTN(新空口非地面网络) 的骁龙平台,能够通过卫星实现视频通话、视频流传输、数据、语音和消息功能,不再局限于 SOS 紧急短信。
此外,它还支持 NB-IoT 作为最后手段,在电梯、地下室等完全无信号的环境下也能保持基础的消息连接。
在定位方面,高通X105 配备了全球首个四频(L1、L2、L5、L6)GNSS 引擎,支持多星座联合定位。这不仅提升了在城市峡谷等复杂环境下的定位精度,还将定位服务的功耗降低了 25%。
十一、高通FastConnect 8800
第六代骁龙8超级至尊版还集成了高通 FastConnect 8800移动连接系统,这也是高通面向“智能体AI”时代首个AI原生移动连接系统。
具体来说,高通 FastConnect 8800移动连接系统是全球首个采用4×4 Wi-Fi 8 射频配置的移动解决方案,并且还是唯一一款在 6nm 单芯片内集成了 Wi-Fi 8、蓝牙 7.0、UWB 802.15.4ab和 Thread 四项技术的的移动连接系统。
其中,Wi-Fi 8 可实现超过10 Gbps的突破性速率。这带来了相较前代Wi-Fi 7产品高达两倍的性能提升,以及高达三倍的千兆无线覆盖范围。通过蓝牙高数据吞吐量(HDT)技术,蓝牙速率也从2 Mbps大幅提升至7.5 Mbps。
该系统还具备近距离感知AI功能,利用UWB、蓝牙信道探测、Wi-Fi测距和其他感知技术,实现低至厘米级精度的精准追踪。
十二、全新骁龙8至尊版双旗舰的具体区别
虽然在骁龙峰会首日上午场的活动中,高通并未详细介绍第六代骁龙8超级至尊版和骁龙8至尊版的详细区别,但是在会后采访环节,Chris Patrick及其团队对芯智讯就此提出的问题给出了正面回应。
Chris Patrick表示,第六代骁龙8超级至尊版和骁龙8至尊版都是2nm制程,CPU部分是完全相同的,GPU架构也基本相同,但是只有第六代骁龙8超级至尊版的GPU上有加入Matrix Core,第六代骁龙8至尊版是没有;
另外,在高速缓存容量上,第六代骁龙8超级至尊版更大;
在影像方面,只有第六代骁龙8超级至尊版拥有APV编解码器,支持8K 60帧影像录制,而第六代骁龙8至尊版只有VPC解码器,只支持8K 30帧。同时,第六代骁龙8超级至尊版还拥有硬件加速的VVC编解码器,第六代骁龙8至尊版则没有;
在AI方面,第六代骁龙8超级至尊版有更多标量和矢量线程可用,第六代骁龙8至尊版大概要少30%;
在DDR支持方面,第六代骁龙8超级至尊版支持LPDDR6,第六代骁龙8至尊版只支持LPDDR5;
最后,在封装方面,第六代骁龙8超级至尊版采用了偏移封装(Offset Package on Package),而第六代骁龙8至尊版则是常规的与DRAM上下堆叠的POP封装。
先说一下,这是两种不同的方案,对吧?两者都是2纳米,两者都有相同的CPU复合体,两者都有相同的基本GPU架构和架构设计,但有多处差异。正如你所说,两种不同的封装,对吧?一个是为顶级优化的封装,一个是传统的封装。在GPU方面类似,但AMD可以扩展。
十三、小米18 Pro系列将首发
作为高通的重要合作伙伴,小米集团高级副总裁、国际业务部总裁曾学忠也现身骁龙峰会现场,宣布小米18 Pro系列将首发第六代骁龙8至尊版系列。其中,小米18 Pro将搭载第六代骁龙8至尊版,小米18 Pro Max将搭载第六代骁龙8超级至尊版。
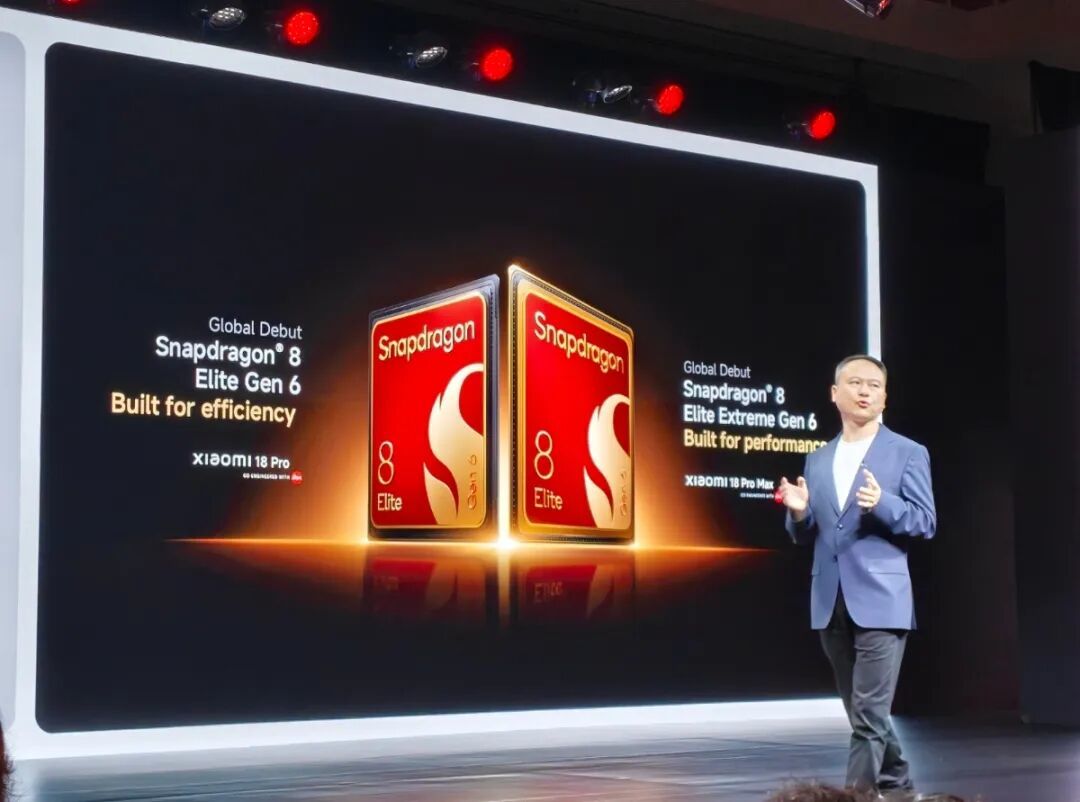
此外,vivo、红魔、REDMI、OPPO、一加、Motorola、iQOO、荣耀等全球领先OEM 厂商和智能手机品牌,将率先在其旗舰产品中采用第六代骁龙8超级至尊版和第六代骁龙8至尊版移动平台。
在会后采访当中,针对如何应对小米等客户自研手机SoC、智能驾舱SoC,以及Arm CSS for Mobile和联发科旗舰SoC所带来的竞争问题,高通表示,“我们拥有的关键价值之一,是我们自研的定制CPU架构,在过去几代产品中大家已经看到了搭载我们自研CPU的产品所带来的出色的性能和能效体验,满足了客户的需求。随着工作负载的演进,我们有能力满足那些不断演进的工作负载需求,这要归功于我们的一步一个脚印的持续研发投入,以及我们在内部积累的巨大专业知识。”
此外,高通还指出,其也有与客户合作,共同推出针对客户所需的特定工作负载优化的定制芯片版本。比如说针对游戏的优化,这主要取决于GPU处理器的实力,但也取决于CPU和CPU的整体能力。所以,骁龙一直持续在游戏能效和游戏帧率方面引领行业。高通是针对最终目标进行优化,不是通用工作负载,而是真正针对这个行业中重要的工作负载进行优化。
Chris Patrick也强调,高通与小米合作关系非常牢固,双方的合作跨越了多个产品类别。历史上,某家公司同时拥有自研SoC,也采用外部SoC并不罕见。我们把它看做是一个他们平台的补充。我们对与小米的合作关系继续持乐观态度。”
小结:
高通第六代骁龙8至尊版系列是高通面向“智能体AI”时代的全新旗舰移动平台,为了顺应这一要求,其遵循了两大关键设计方向:
第一大设计方向,是将AI计算由原来的主要由“NPU”负责,转向了将AI融入了CPU、GPU、NPU、ISP、传感中枢等几乎所有的计算模块。无论是将两颗Prime核心主频提升至5GHz,在GPU中加速矩阵计算核心,还是在NPU中加入专为Transformer运算设计的Element Accelerator(元素加速器),还是将NPU与ISP进行连通,还是传感中枢持续的环境语音感知,都是为了提升移动端的整体AI体验,助力移动端智能体AI的落地。
第二大设计方向是,让数据与计算尽可能靠近使用它们的处理资源,减少对较慢的外部内存的依赖,从而提升智能体AI的运行速率、降低延时。无论是Oryon CPU的FlexCache、Adreno的HPM,还是Hexagon NPU的共享内存扩展,都是遵循这一思路。
显然,在智能体AI时代,移动端SoC性能的竞争,已经从过去的各个计算模块的性能比拼,转向了面向智能AI所需的整体AI性能、更低延迟、更持久力的竞争。高通全新第六代骁龙8至尊版系列所构建正是一个完整的智能体AI技术栈。
“我们花了十年时间完善智能手机,但在下一个十年,我们将重新发明它。……智能体时代的中心是移动,驱动它的平台将是骁龙。”Chris Patrick在发布会最后非常自信地说道。
作者:浪客剑