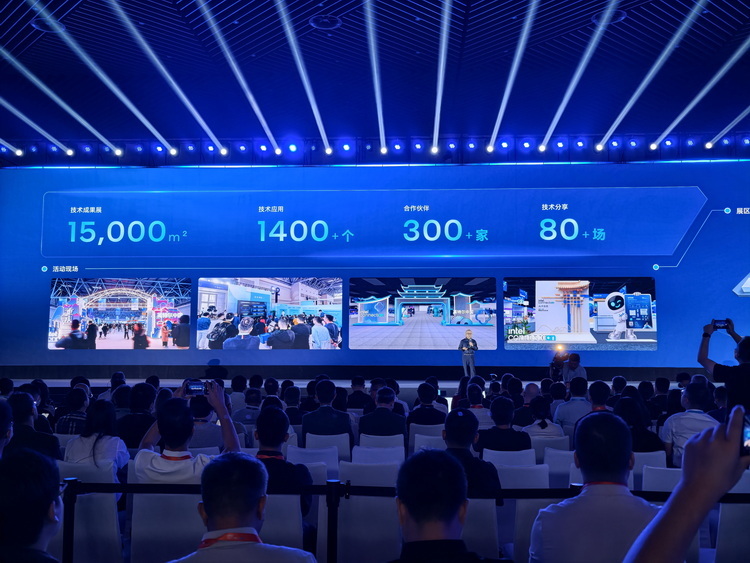
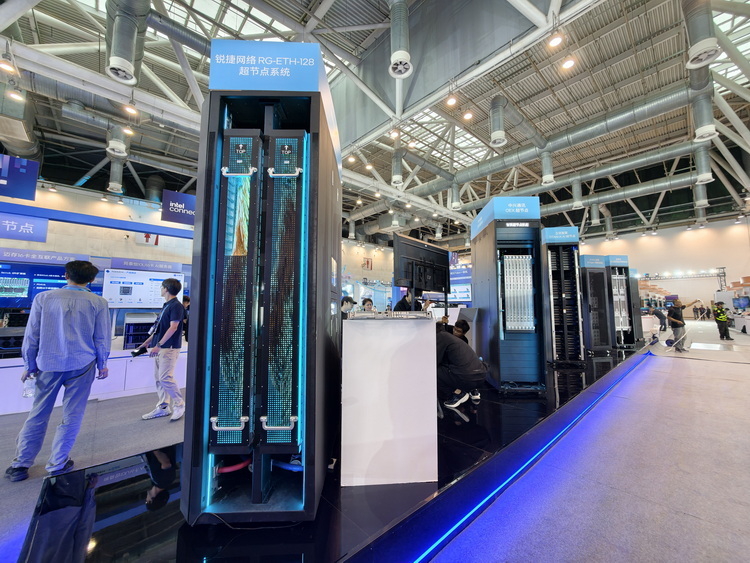
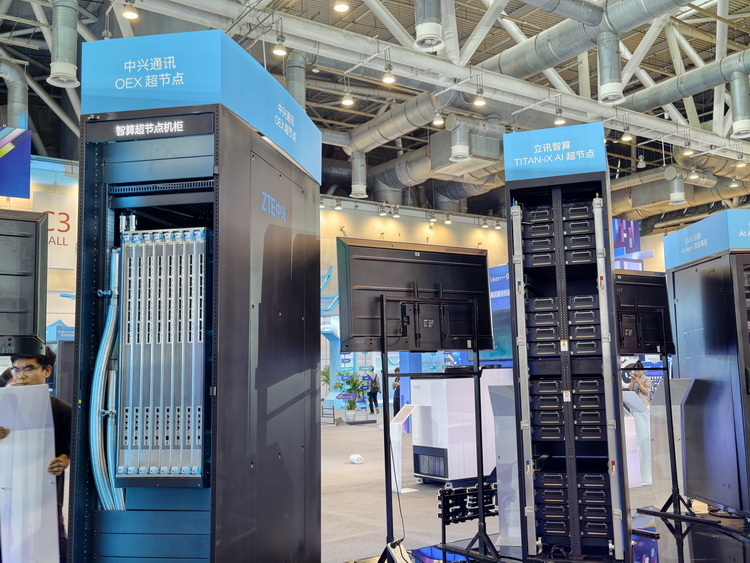
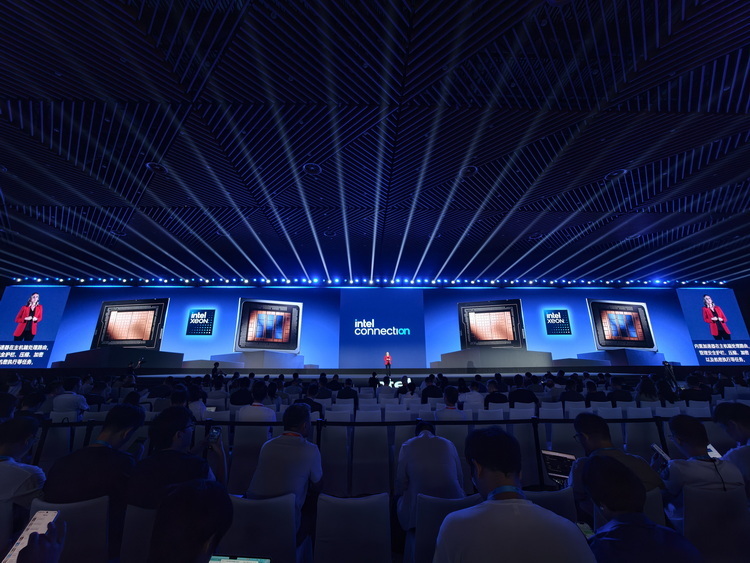
9月22日,苏州。2026英特尔技术创新与产业生态大会开幕,主题叫"同芯·智远"。11场主题演讲,80多场技术课堂,1.5万平方米的展区塞了1400件演示,300多家伙伴搭了台子。
英特尔这次想讲明白一件事:智能体时代来了,算力的排位要重排。过去一年所有人的眼睛都盯着GPU,它想把CPU拉回中心。
以CPU为核心,英特尔为智能体AI打造全新智算中心
英特尔数据中心集团副总裁、中国区总经理陈葆立上台,先报了一串数。到2026年底,超过80%的企业应用会至少嵌一个AI智能体。IDC把预测推到2031年,中国企业场景里的活跃智能体会有3.5亿个。最扎眼的是最后这条:中国大模型每天的Token调用量,已经涨到2024年初的5000倍。
钱跟着需求走。2026年全球AI优化型IaaS支出预计涨96%,美银证券的判断更狠,到2029年中国AI数据中心的固定资产投资要超过2.2万亿元。
供给端的变化更猛。关于2030年CPU市场规模的预估,半年里就从今年2月的590亿美元跳到了8月的2100亿美元,差不多翻了3.6倍。数据中心里AI负载的占比也在变,预计从2025年的40%升到2030年的80%,等于说未来加进数据中心的芯片,一大半是为AI买的。
陈葆立的解释很实在。智能体跑起来,底下是一层层的软件工程。上下文工程让模型记住背景,Harness给模型配上工具和"手",Loop engineering让它像学生一样反复验算答案。这些活儿不炫,但大多适合CPU干。所以他说得很直白:过去这一年智能体起来,直接带来了对CPU的巨大需求。
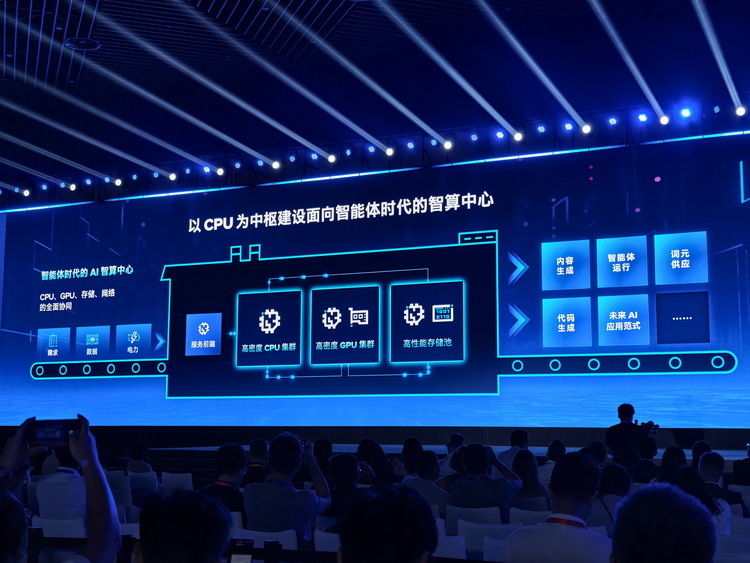
架构上,英特尔把未来的数据中心分成三类。一类是CPU服务器或者集群,管智能体的执行和工作编排;一类是配了AI加速卡的智算中心;还有一类是高性能存储集群,专门扛长对话和文档。三样都要CPU做数据调度。当"Token工厂"变成"AI工厂",比的不是谁能产更多Token,而是整个系统怎么用更少的资源帮客户多办事。
落到产品。今年6月发的至强6+,用Intel 18A制程,288个核,单颗最多能稳稳跑近1000个智能体。现场给了两组实测:在客户选的一组负载下,至强6+单智能体平均性能比竞品高15%;满足200毫秒启动时延的前提下,单颗最多能并发建350个沙箱,是某同类产品的1.46倍。
一颗芯片再猛,也顶不住海量沙箱同时起来。所以英特尔拉着伙伴发了个开放Agent整机柜平台规范,把计算、内存、供电、散热一起算进设计,让更多厂商能照着这套标准做自己的整机柜。
在智算服务器里,至强更多时候是站在前面的那颗机头CPU,管数据预处理和传输。Intel 18A-P这代,每瓦性能提了9%,同性能下功耗降18%。从第三代酷睿Ultra、酷睿处理器到锐炫Pro B70/B65,英特尔把算力从客户端一路铺到边缘。
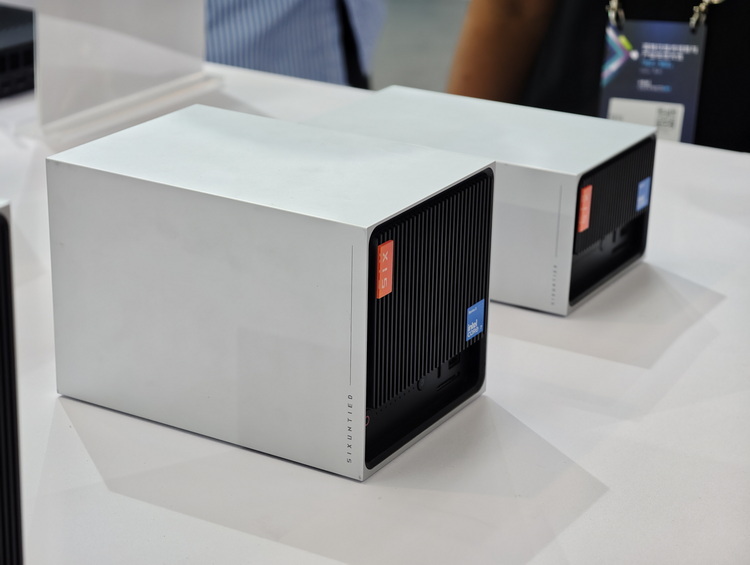
部署形态也冒出新东西。集装箱式的AI算力仓,还有把算力直接推到企业一线的词元一体机。
从AI PC入口到智能体原生系统,英特尔怎么攒生态
端侧是这次大会的另一半重点。
英特尔副总裁、端侧计算和物理AI事业部中国区总经理高嵩,用两个定律开场:规模定律和密度定律。密度定律说,大概每三个月,同样大小的模型,智能密度翻一倍。他举的例子很直接:一个90亿参数的新模型,智能程度已经能赶上甚至超过几个月前1200亿参数的大模型。
底座是CPU、GPU、NPU拼起来的XPU混合架构。CPU管高频的计划、决策、逻辑推理;GPU做AI并行计算;NPU用极低的功耗接音频、视觉这类全天候任务。
有两件事值得单独拎出来说。
一件在应用层。"英特尔AI PC智能体伙伴"正式进了WorkBuddy,分成智效办公、智享生活、智创内容、智优电脑四个板块,用户在一个入口就能调端侧的AI技能。另一件在系统层。英特尔联合阿里云千问,预览了Qwen Book智能体原生桌面操作系统的深度适配,用多种形态的AI PC硬件和千问的全栈方案融在一起,做智能体原生设备。
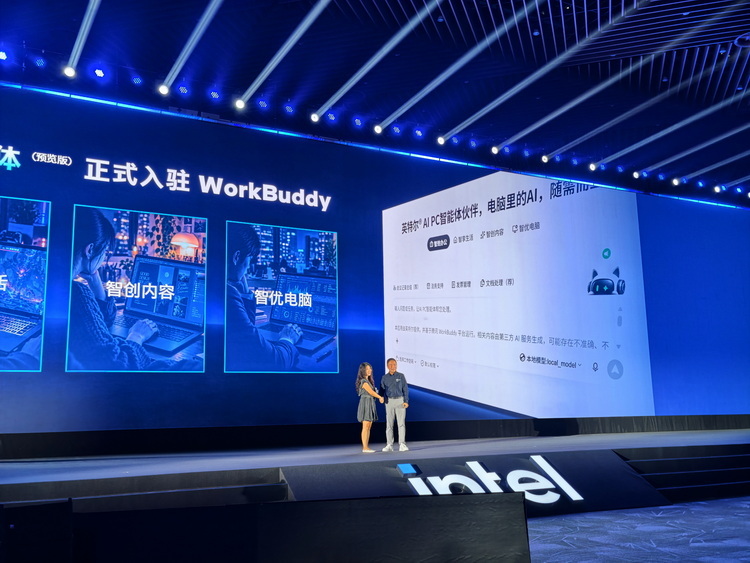
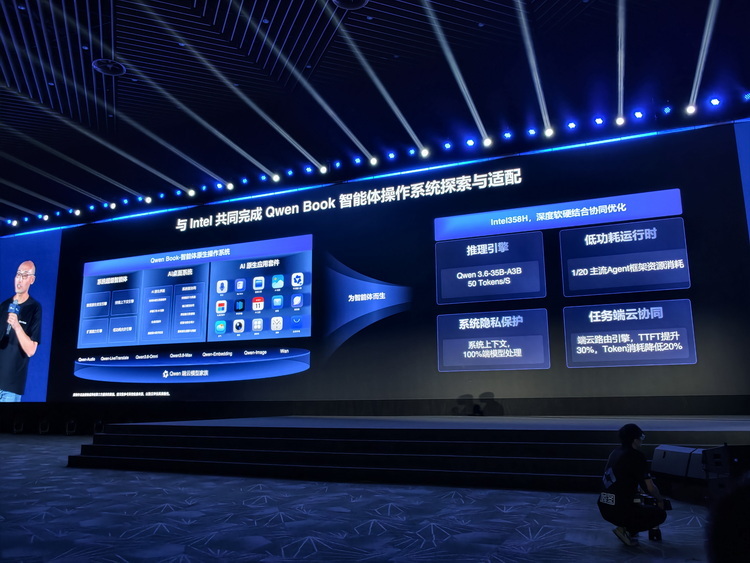
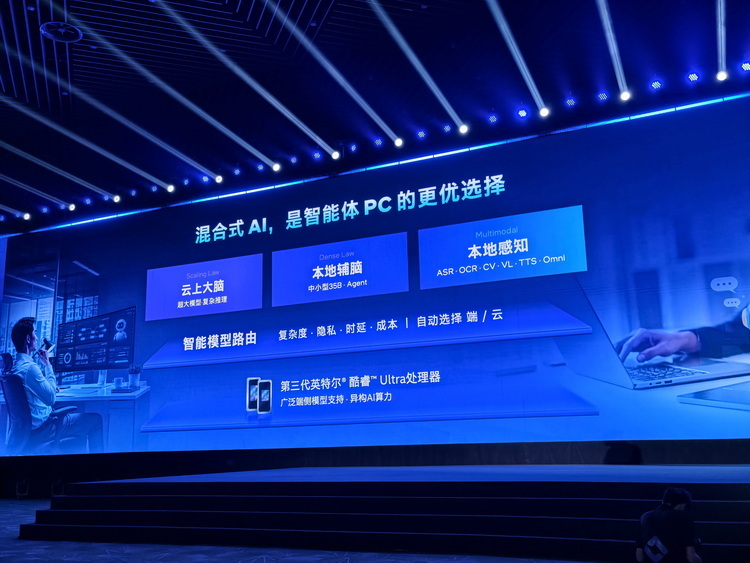
这两步比堆参数有意思。以前英特尔在PC上卖芯片,软件伙伴各自去适配;现在它把技能入口和操作系统层一起往前推,等于在端侧既占了入口,又插进了系统。第三代酷睿Ultra能在本地跑350亿参数级的模型,加上模型路由决定什么时候用端、什么时候上云,混合式AI的架子就搭起来了。
搭生态的不止这几家。英特尔这头和70多家独立软件开发商推AI PC体验,跟中国的模型厂商做了17项首日适配。云上,国内服务商已经推出200多种至强6和至强6+的云实例,光阿里云就占了117种,其中50多种已经跑在智能体场景里。边缘侧,100多家机器人伙伴在往前推。
物理AI也没落下。英特尔联合科通工业、神州数码发了具身智能开发套件,用第三代酷睿Ultra,把实时控制的平均抖动压到1.6微秒,开发者开箱就能跑通"感知—规划—执行"。
热点科技洞察
说真的,这场会最让我在意的,不是哪颗芯片又快了多少,而是英特尔摆出来的姿势。
智能体AI正从demo往产业里走,市面上聊得最热的是GPU。英特尔偏在这个节点把"CPU回C位"当主线,更像是对"AI等于GPU"这股惯性的一次正面较劲。单看x86体系,至强6+的数站得住脚:近1000个智能体、350个沙箱并发、1.46倍,说的都是同一件事,智能体把CPU从配角逼成了高频刚需。
它真正在做的,是把自己的位置从芯片商往标准制定者和生态组织者上挪。整机柜规范、具身智能套件、模型首日适配,这一串动作都朝这个方向。AI PC智能体伙伴进WorkBuddy、联合千问做Qwen Book,是同一套逻辑在端侧延伸:它不想只待在硬件层,想往用户真正碰得到的入口和系统里钻。
不过得泼点冷水。大会上的那些数字,来源无非两类:一类是IDC、美银这类机构的预测,一类是英特尔和特定伙伴在自己负载下的实测。预测和定向实测都算不上宽口径,往外推的时候得打个折。
至强6+的强项,说白了就是智能体调度、沙箱并发、数据预处理这几样它本来擅长的活。这些东西放进一整套系统里到底能放大多少,没真部署跑过,谁也说不准。国内GPU方案一茬接一茬,至强当机头CPU的主流位能不能守稳,也不是一两年能下结论的事。更根本的一点,智能体要规模落地,瓶颈正往应用侧跑:怎么把一次对话变成能稳定跑下去的工作流,芯片解决不了。
所以这场会的分量,不在某页PPT上的参数,而在它把300多家伙伴、1400件演示、1.5万平方米摊开来给你看。在这个赛道上,英特尔赌的从来不是单点性能,而是"想做AI的人,绕不开这个生态"。这话它说了很多年,但今年,它把筹码摆得比往年都实。