


机器之心编辑部
就在今天早上,AI 圈与数学圈真炸锅了,很多研究者与网友真・瘫坐在了椅子上,被智能爆炸所震撼。
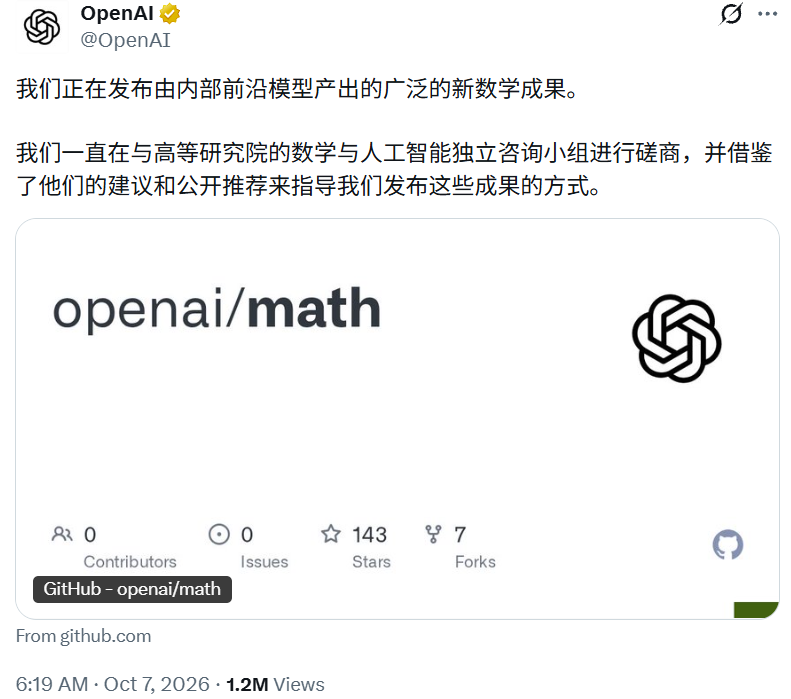
很难以想象,这个 Github 仓库里放着不是一个两个重量级的数学成果,而是足足 722 个!
这是一份数学论文清单:722 篇手稿,归入 372 个成果族,全部由一个尚未发布的内部前沿模型产出。
清单上的名字,足以让任何读过研究生数学课程的人停下来多看几眼:准黎曼猜想、四维挂谷猜想、唯一游戏猜想、自由群因子同构问题、有理数域上的希尔伯特第十问题、CM 阿贝尔簇的霍奇猜想、马勒猜想…… 这些问题里,有的悬置了半个世纪以上,有的曾是菲尔兹奖级别工作的延伸方向。
Sam Altman 表示我们正在进入一个大发现的新时代。
一次爆炸式发布
按照 OpenAI 的说法,这批成果来自对内部模型的数学能力评估。
由于模型在既有数学评测上的表现已经饱和,团队把评估扩展到了开放研究问题上,其中部分成果建立在模型此前产出的结果之上。整个评估过程中,模型被投喂了约 4000 个研究问题;把输出按相关性归并为成果族、再按「足够重要」的门槛筛选之后,留下了现在这 372 族、722 篇手稿。
一个「成果族」通常包含一个主结果,以及配套论证、推论或替代证明。按 OpenAI 自己的学科标注,这 372 族覆盖 17 个方向,数量最多的是理论计算机科学(40 族)、组合数学(37 族)、代数与复几何(36 族)和数论(31 族),其后是概率与统计力学、微分几何、数学物理、算子代数等;数理逻辑最少,也有 6 族。
算力方面,OpenAI 称:绝大多数结果走的是同一套固定流程,平均每个结果消耗约相当于 3 小时 ChatGPT Pro 思考的算力。
另一个值得留意的细节是,手稿的文件夹以日期结尾,几乎全部集中在 9 月 23 日至 10 月 5 日之间,其中 9 月 23 日和 24 日两天就各有近 200 篇。换句话说,这份清单的主体,似乎是在不到两周的时间里批量输出的。
与论文一起放出的,还有三类「证明工件」:Lean 形式化证明、10 份模型推理过程的精简摘要,以及计算量与尝试问题数的统计。按我们对仓库目录的统计,372 族中有 235 族附带了 Lean 形式化说明页,约占六成三。
但 OpenAI 同样坦白,并非所有手稿都完成了形式化,未形式化的结果「可能存在问题」,团队会尽快修正并持续补充。
目前,该项目的 Star 量正在疯狂上涨中,仅仅三个小时,已经突破了 2k。
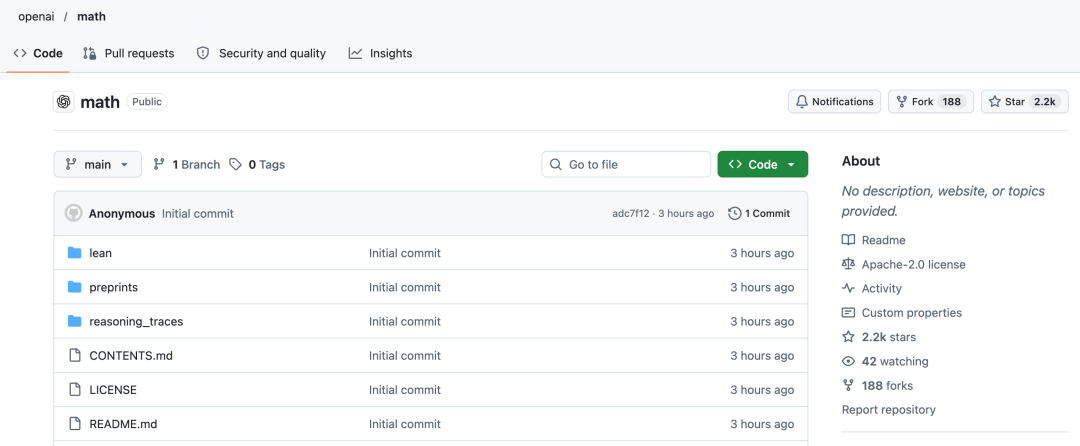
仓库地址:https://github.com/openai/math
黎曼和挂谷
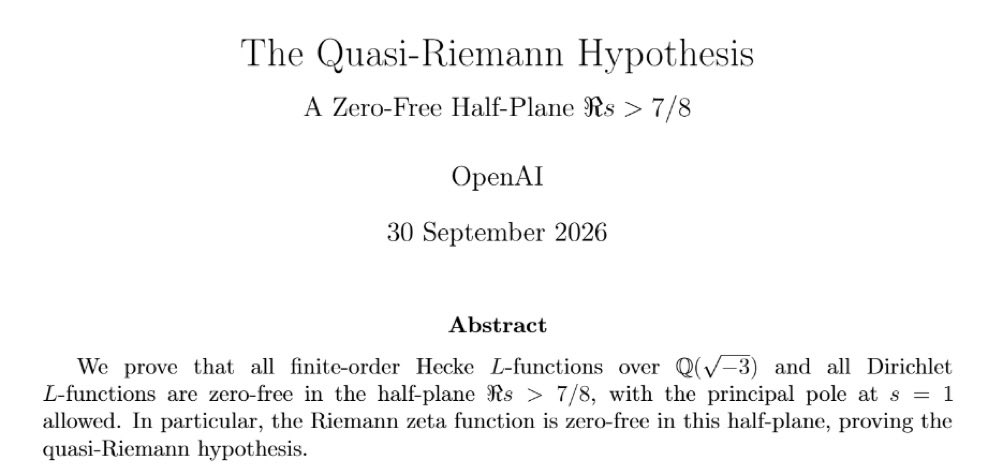
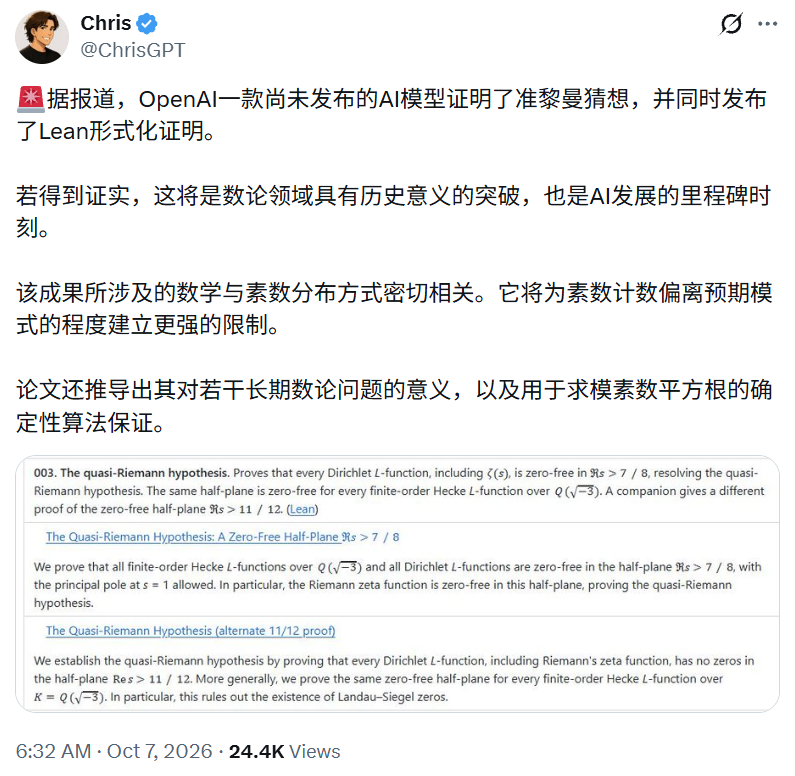
在 722 篇手稿中,最先在社交媒体上刷屏的是编号 003:准黎曼猜想。
黎曼猜想断言,黎曼 zeta 函数的所有非平凡零点都落在实部为 1/2 的直线上。这个目标太远,数论学家退而求其次,提出了「准黎曼猜想」:哪怕证明存在某个小于 1 的常数 θ,使得实部大于 θ 的整个半平面里都没有零点,也是巨大进展。
一百多年来,人们能证明的零点自由区域都会随着虚部增大而越来越贴近实部为 1 的那条线,始终没能「撑」出一条固定宽度的竖直带。OpenAI 这次给出的结论是 θ = 7/8,对 zeta 函数和所有狄利克雷 L 函数一致成立,并且已经给出 Lean 形式化。配套论文还给出了 Landau–Siegel 零点的一个一致排除结果。
另一个引发热议的是编号 074:挂谷问题。
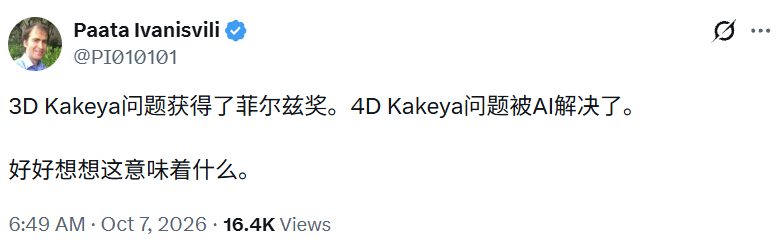
就在今年 7 月 23 日,王虹凭借与 Joshua Zahl 在 2025 年完成的三维挂谷集合猜想证明获得菲尔兹奖,成为史上第三位获此殊荣的女性数学家;彼时《量子杂志》盘点的「下一步」里,四维挂谷猜想仍赫然在列。
OpenAI 清单里的这一族同时声称解决了三维挂谷「极大函数」猜想和四维的豪斯多夫维数猜想。
重量级的成果远不止这两项。
理论计算机科学方向,编号 102 声称证明了 Subhash Khot 于 2002 年提出的唯一游戏猜想,并据此一口气给出 Max-Cut、顶点覆盖等经典问题的最优近似难度门槛;
代数几何方向,编号 032 声称对所有复 CM 阿贝尔簇证明了有理霍奇猜想;
数论方向,编号 002 与 006 合起来,给出了每条有理椭圆曲线的一个密度为一的二次扭曲族上完整的 BSD 公式;编号 004 则对有理数域上的希尔伯特第十问题给出了否定解答。
这三项都牵涉千禧年大奖难题或二十世纪的标志性问题。
算子代数方向,编号 287 声称解决了自由群因子同构问题,结论是不同秩的自由群因子彼此同构,附带 Lean 形式化。
此外,清单中还有证明 π 的无理性测度恰为 2、卡塔兰常数为无理数、马勒猜想在所有维数成立、平面不能用五种颜色完成单位距离染色等结果,也有对 Kaplansky 零因子猜想、Hadwiger 猜想的反例构造。
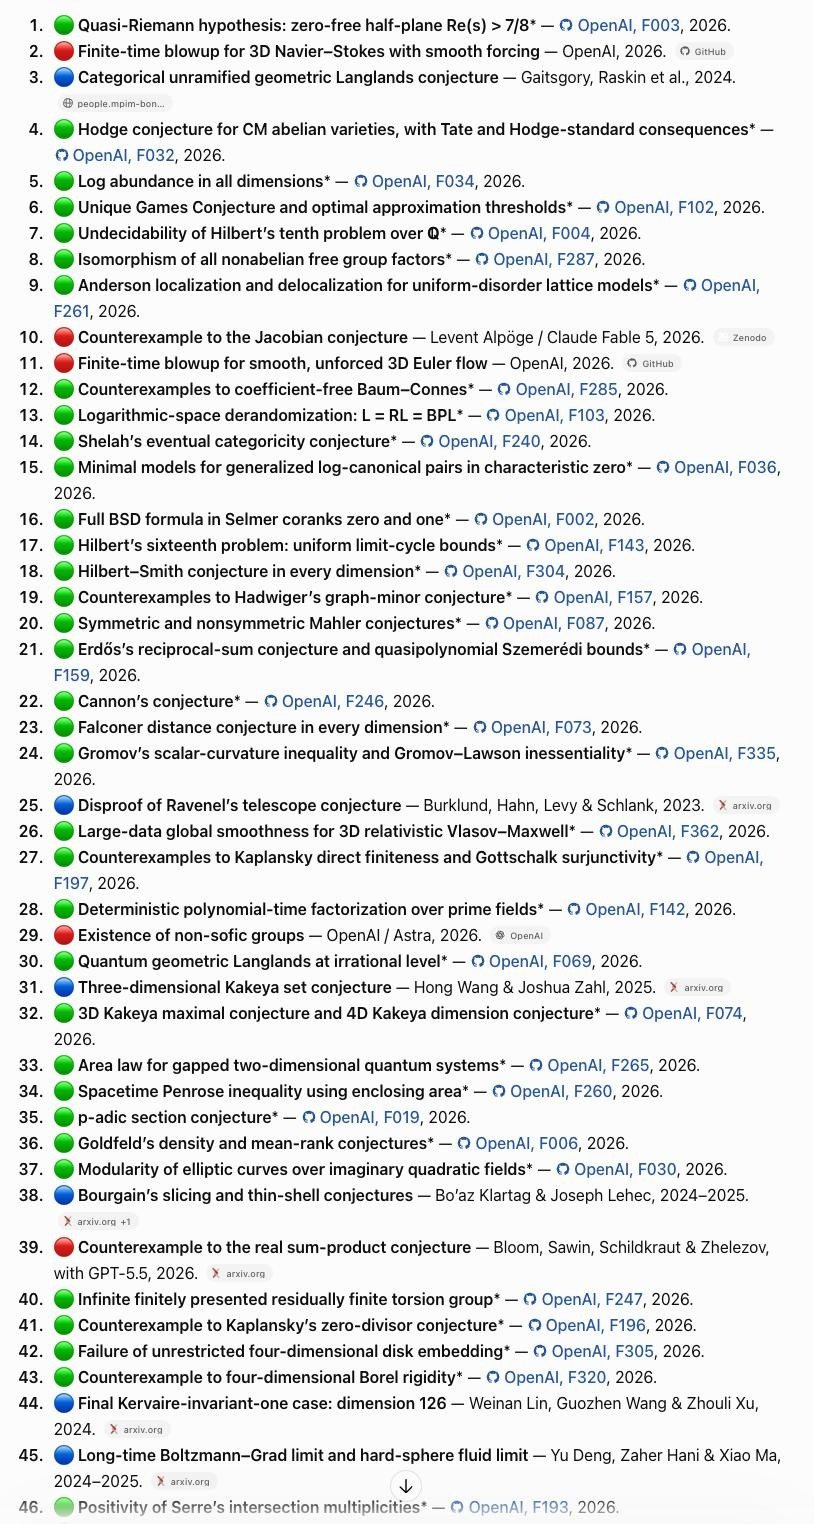
作为补充,下面是前 OpenAI 研究者 Will Depue 用 GPT 6 Pro 和 Fable 5.1 对过去三年的所有发现进行排名。其中蓝色表示人类发现、红色表示 AI 发现(10 月 6 日之前)、绿色表示来自 OpenAI/math repo 的 AI 发现。震撼的是,其中 81% 是今天才发布的。
一个神秘内部模型
整场发布里,模型本身始终缺席。OpenAI 没有公布它的名字,只在博客中称之为「内部前沿模型」,并表示正在推进其「负责任的发布」。
9 月 8 日,OpenAI 发布了 Navier-Stokes 公告。公告称,一个「显著强于 GPT-6 Astra」、8 月 28 日开始训练且训练仍在进行中的内部模型,用约 1 万个并行智能体、88 小时的工作,证明了三维不可压缩流体在光滑外力作用下可以从静止状态出发、在有限时间内产生奇点,并用 GPT-6 Astra 额外花了 17 小时完成 Lean 形式化。
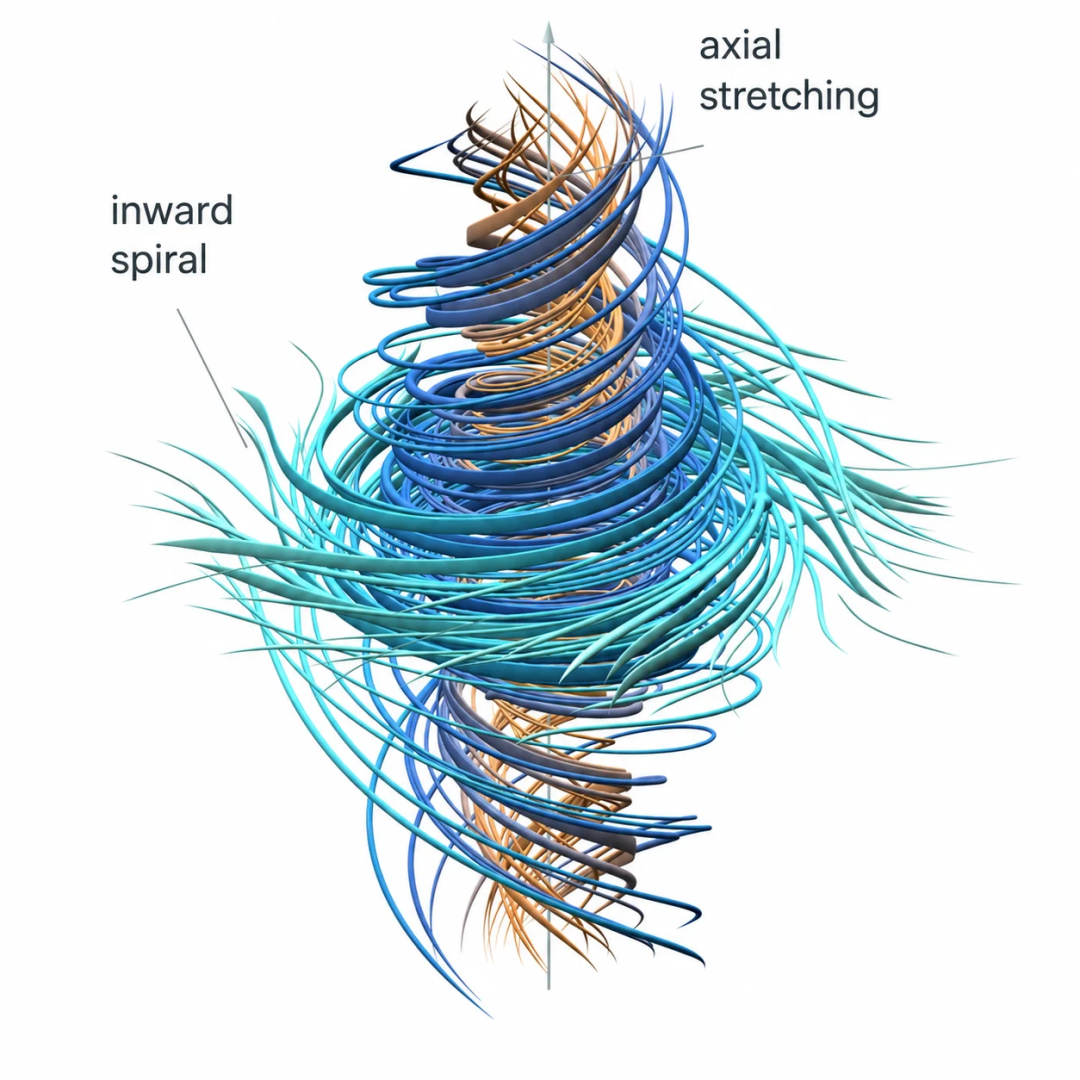
相关链接:https://openai.com/zh-Hans-CN/index/navier-stokes-solution/
发布前夕,OpenAI 发言人就已证实,这个新内部模型已经解决了「数学大多数领域里」超过 100 个长期悬而未决的问题。
数学家的群情激奋
过去两个多月,AI 实验室与数学家之间的摩擦压力一路攀升。
8 月 1 日,OpenAI 公布下一代模型 Astra 在数学与理论计算机科学上的十项进展 。仅几天后便有数学家指出,其中证伪 Connes 刚性猜想的反例里,有一个群不满足所需条件。8 月 11 日,Anthropic 也披露其未发布模型在黎曼猜想相关方向取得进展。
据《连线》报道,在 8 月,OpenAI 私下召集了约 40 位数学家,讨论如果 AI 在数学上超越人类该怎么办。
与会者称,OpenAI 当时暗示其模型已经解决了数以百计的长期难题,并就如何发布征求意见;有与会者称公司还承诺不会一次性全部放出,但 OpenAI 发言人表示「不知道」有过这样的承诺。
西北大学数学家回忆,与会者的情绪是兴奋与恐惧交织,大家当场提出,不要再像 8 月十道题一样只靠博客和推文发布,而要写成论文,让数学家能够消化和使用这些结果 。
据报道,OpenAI 是在听到有人即将解出该问题的「传闻」后,才调动数千个智能体进行攻关。纽约大学的 Tristan Buckmaster 指控 OpenAI 抢跑了他与 Levent Alpöge 私下合作的工作,Alpöge 本人是 Anthropic 员工,两人尚未发表成果,却一直在使用 OpenAI 的工具辅助研究。
相关链接:https://www.wired.com/story/openai-is-pissing-off-a-bunch-of-mathematicians-again/
数学家表示,「人们觉得这些头部 AI 公司有种黑帮式的行事作风。」
9 月 11 日,包括陶哲轩在内的 25 位菲尔兹奖得主联署声明。声明认为,攻克名题本是推动概念理解的工具和代理指标,而仓促的公告留不出时间来写好论文、做好引用,会带来严重的署名与抄袭问题。
相关链接:https://terrytao.wordpress.com/2026/09/11/a-severe-misalignment-of-ai-in-mathematics/
在此之前,一份由 4000 多名数学家联署的《莱顿宣言》已经要求 AI 公司遵守数学界的标准,内容涵盖披露 AI 使用、同行评审、引用前人工作和保持开放获取等,Bryna Kra 是起草者之一。
9 月 29 日,高等研究院(IAS)数学与人工智能独立咨询小组在汇总了 600 多份社区问卷后,发布了一份 AI 生成数学成果的发布建议。这正是 OpenAI 此次在推文和博客中特意援引的那份文件。
https://agmai.org/general-sep29/
IAS 的建议分两步。
第一步是「初次发布」:实验室要检索并引用相关已有工作,把证明写成符合传统数学论文惯例的样子;要公开模型名称、提示词、思维链摘要、耗时和算力成本估算;要尽可能形式化;要存放在「不受任何 AI 实验室控制」的中立仓库,带持久标识与修改记录;还要报告在可比问题上的失败率。
第二步是「支持理解」:资助会议、研讨会和阐释性写作,并向全球数学界提供广泛、公平的模型访问。
拿这份清单对照,OpenAI 的答卷可以说是「有选择地及格」。公开推理摘要、算力估计和尝试问题数,承诺资助一系列围绕 AI 重大成果的研讨会和会议,承诺版本留痕、修订以新版本发布,形式化做了六成以上。
不符合建议的地方也很多。尤其是未公开模型名称。仓库放在 OpenAI 自己的 GitHub 组织下,OpenAI 表示仍在探索社区托管的替代方案。OpenAI 也在博客里承认,未来的发布会在引用、数学阐述和呈现方式上继续改进。
瓶颈从「证明」移到了「理解」
如果说 9 月的 Navier-Stokes 公告证明了 AI 能啃下一道最难的题,那么这次发布证明的是另一件事:在相当宽的数学前沿上,产出可检验的新结果,已经可以按「每题几小时」的节奏批量进行。
这让陶哲轩在 9 月提出的那个判断变得更加尖锐:真正的冲突不是人类推理对机器推理,反而是充沛的证明产出与稀缺的专家注意力之间的错配。
372 个成果族里,有 235 族带有 Lean 证明,这确实大大降低了「证明是否正确」的验证成本;但 Connes 刚性猜想的插曲已经提醒过所有人,形式化能保证推理无误,却不能自动保证被证明的命题就是数学家心里那个命题。OpenAI 为每一族准备的 Lean 说明页里专门写明「形式化覆盖到哪里、没覆盖到哪里」,比如准黎曼猜想一族就注明论文中后续的应用部分不在形式化范围内,这本身就说明了陈述层面的核对仍然离不开人。
至于那些分量最重、却尚未形式化的结果,比如四维挂谷、CM 阿贝尔簇的霍奇猜想、有理数域上的希尔伯特第十问题,接下来几个月里能否经受住专家逐行审读,才是这次发布真正的成绩单。
一个更值得追问的问题是:当新定理的供给不再稀缺,数学共同体要如何重新分配自己最宝贵的资源,也就是读懂它们的时间?
Sam Altman 说我们正在进入一个发现的新时代。这句话的前半句,今天已经有了 722 份证据;后半句「发现」要真正成立,还需要人类把这些结果读懂、接住,再传下去。
参考链接
https://openai.com/index/sharing-ai-progress-in-mathematics/
https://github.com/openai/math/blob/main/lean/docs/003.md
https://huggingnews.com/ai/openai-math-release-includes-claimed-progress-on-three-millennium-prize-29a7cc5e
https://quantamagazine.org/hong-wang-wins-2026-fields-medal-the-third-woman-ever-20260723
https://www.remio.ai/post/terence-tao-ai-math-warning-challenges-the-benchmark-race
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com