

允中 发自 凹非寺
量子位 | 公众号QbitAI
允中 发自 凹非寺
量子位 | 公众号QbitAI
推开一块挡板,通道就此封闭;搬来一段坡道,高墙便有了越过的可能。
每一次行动都会改变世界,而改变后的世界,又成为智能体下一次决策的起点。
当这样的世界可以由代码构建、由扩散模型实时绘出,AI便拥有了一座可以反复探索的「试炼场」:亲自行动,观察后果,验证猜想,再把经验带进下一轮。
这是MirroS团队最新发布的AgentGarten。它将可执行的代码环境与实时神经渲染器连接起来:代码定义物理规则,模型生成视觉反馈,以超过30 fps的吞吐,让智能体持续与世界交互。
在经典的捉迷藏实验中,变化很快发生了。躲藏者在第4轮学会搬动挡板搭建掩体,搜寻者在第10轮掌握借坡道翻墙。一次跳跃失败后,搜寻者还会主动推近坡道,调整位置,再次尝试。
推动这些策略演化的,是智能体自己写下的「实验手册」。
每轮结束,它们复盘尝试、记录发现、标注疑问;下一轮,再带着这些经验继续探索。
代码让世界可以运转,实时渲染让世界可以被看见,持续演练让经验不断积累。
AgentGarten将三者接成闭环,探索一个更大的问题:
当智能体拥有可以行动、试错并积累经验的世界,智能将如何在其中持续进化?
全文Blog:https://mirros.ai/blog/worlds-for-evolving-agents
技术报告:https://mirros.ai/report/agent-garten.pdf
代码:https://github.com/MirroS-Lab/AgentGarten
项目主页:https://mirros-lab.github.io/agent-garten
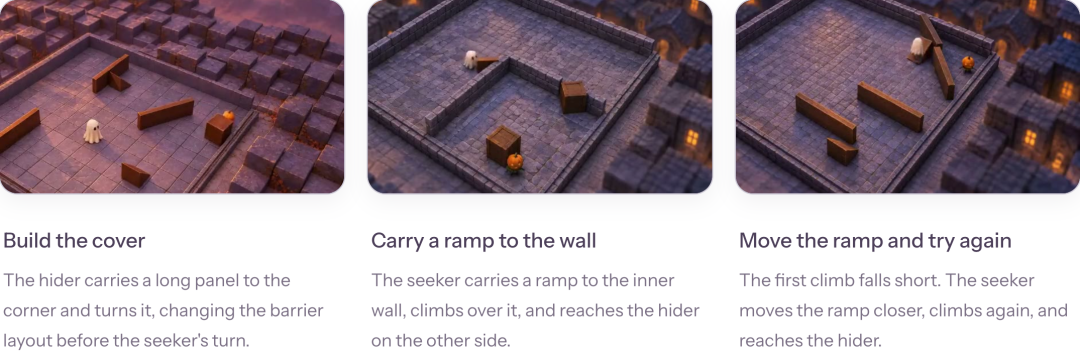
△图1|对局中涌现的三组典型博弈策略。搬挡板封堵掩体、架坡道翻越高墙、首跳失误后主动调整重试。
智能体缺的,是一个能反复练手的世界
想让AI真正理解物理世界,光靠给它看海量视频是远远不够的。就像学游泳不能只看录像一样,智能体必须亲自“下场”,即采取行动,观察实际结果,再决定下一步。
这就需要一个具备物理因果确定性的环境,推开的箱子必须留在原地,封堵的通道必须不能通行,后续的一切动作都要被这些物理变化持续约束。
当前的两条主流技术路径各有局限:
传统的代码/游戏引擎环境,状态精准、规则透明,每一次物理碰撞都清清楚楚。
但短板在画面:程序化搭建的场景往往只有粗糙的几何白模和重复贴图。要想让成百上千个开放场景都拥有逼真的光影质感,所需的美术建模和工程投入是个天文数字。
以视频生成为核心的世界模型(如各类视频大模型),固然能生成令人惊叹的高清画面,也能随动作生成后续帧。
但问题在于,物理信息完全隐式藏在神经网络的记忆中,无法提供一个可查询、可干预的明确状态。你想查看杯子里还剩多少水、想让机械臂拧紧螺丝、或者制定一套严格的任务裁判规则,在单纯的视频黑盒里寸步难行。
MirroS的解法表现为:让两者各司其职,物理交给代码,光影交给神经模型。
代码推进世界,模型负责「看起来怎样」
在AgentGarten中,一次标准的交互闭环是这样运转的:
智能体给出动作指令;代码环境立即计算物理碰撞与状态更新,并从智能体的第一人称相机视角,导出一份轻量的“几何草图”(即空间深度或表面法线);
随后,神经渲染器读取这份几何草图,结合此前的视觉记忆,瞬间渲染出拟真的下一帧画面递给智能体。
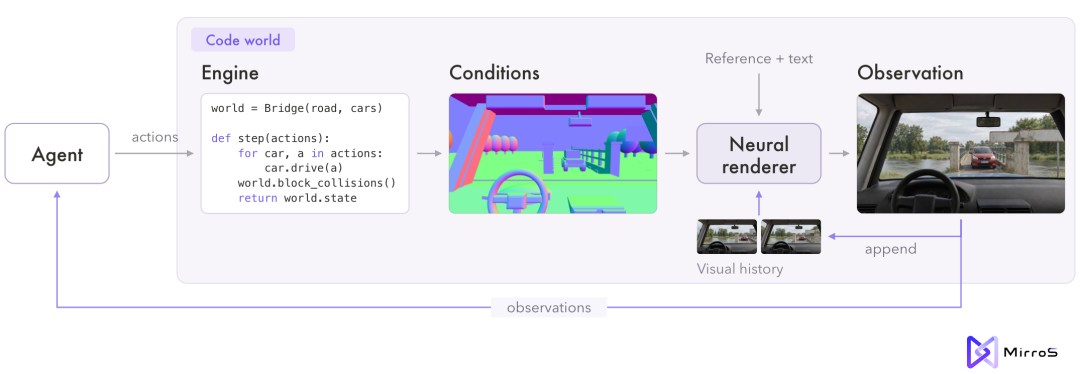
△图2|代码环境与神经渲染器的闭环流转。智能体发出动作指令,代码世界更新状态并导出几何条件,神经渲染器实时生成下一次视觉观测。
这种分工带来了两大质的飞跃:
第一,物理规则永远“确定可控”。
场景布局、接触判定与游戏胜负均由代码裁决,不产生任何“幻觉物理”。
第二,搭建全新世界变得极快。
过去构建100个逼真仿真环境,需要专业美术团队建模、贴皮、打光,成本高到难以承受。而在AgentGarten中,只要能输出简单的三维深度和法线轮廓,任何极简的代码场景都能直接套用这套神经渲染器,瞬间获得写实的光影与材质。翼装飞行、机械臂操作、厨房烹饪、多车竞速,底层共用同一个视觉接口——虚拟环境的扩充成本,第一次从“美术劳动密集型”变成了“代码程序化扩展型”。
△图3|跨任务的多样化物理世界。涵盖空间导航、物体操控、运镜重拍与多车交互等。左侧为代码导出的简易白模,右侧为渲染器实时生成的拟真视觉。
更关键的是,这套渲染器是流式生成的:动作走一步,画面画一段,智能体看清结果再做下一决策,交互真正像现实世界一样连贯流转。
重访捉迷藏:2500万局与4轮
世界搭好了,接下来要看的是智能体:在这样的世界里反复行动、复盘,它能不能自己越做越好?
一个经典的参照是OpenAI 2019年的捉迷藏实验:躲藏者和搜寻者在放有挡板和坡道的场地里对抗,经过大规模自我博弈,相继学会了搭建掩体和借坡道翻墙。
MirroS团队在AgentGarten中重做了这个实验,采用一对一的设定:躲藏者先布置场景,然后轮到搜寻者进场。
对战规则清晰纯粹:躲藏者先布置场景封堵入口,随后搜寻者进场搜寻。智能体通过写Python代码控制移动与抓取,全凭眼前生成的画面决策,对空间坐标、对手位置一无所知。
双方从完全空白的手册起步,各自维护由单篇技能组成的策略库。每轮对战十局,战罢复盘沉淀,下一轮随机抽选部分技能库应用。
很快,那些经典的博弈策略在数轮内相继涌现:挪挡板封门、搬斜坡搭桥、翻墙受挫后拉近斜坡重试。
2019年的研究因涌现出这些经典行为而闻名,也提供了一个直观的对照(见图4):在那项研究中,AI依靠从零开始的强化学习,摸索出掩体搭建,经历了约2500万局;学会借坡道翻墙,经历了约1亿局。
而在AgentGarten中,智能体面对第一人称视觉画面,在轮次之间复盘并修订文字手册,躲藏者在第4轮学会了搭掩体,搜寻者在第10轮掌握了借坡道翻墙。
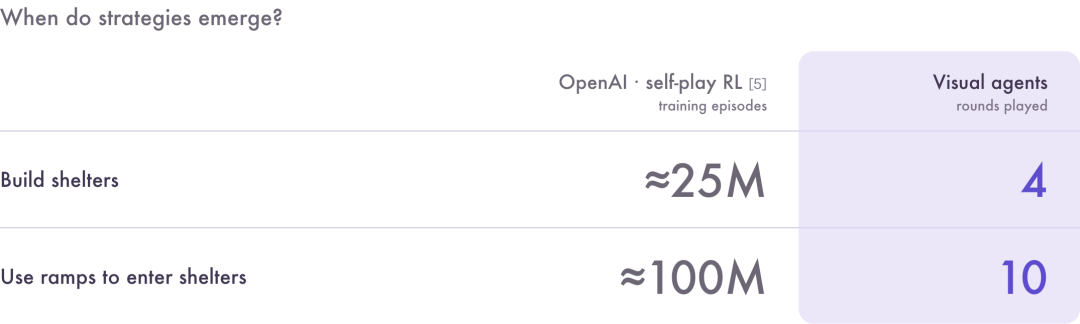
△图4|代表性策略出现前所经历的对局规模对比。自我博弈RL在特权物理状态上从零训练数千万至上亿局;MirroS智能体依据第一人称渲染画面行动,通过逐轮反思手册在数轮内迅速掌握相应策略。
边玩边记,把经验写下来
Hide-and-seek里的快速进步,靠的是一套通用的演练流程。
MirroS的做法是:让智能体自己“动手记笔记”。它学到的一切认知,都写进一本本手册里。
演练被划分为严谨的四个递进环节:
领受任务:拿到一份任务文件,明确行动目标与规则红线,但没有任何标准答案。
盲盒试错:在严格的步数与时间限制下自主行动。只有相机画面,没有上帝坐标,没有小地图,未到终局也看不到得分。
撰写手册:一轮结束后自我复盘,老老实实记录:自己试了什么、看到什么现象、哪些判断存疑、下次该验证什么新假设。
封存传代:手册归档冻结,直接作为先验遗产交给下一轮智能体。
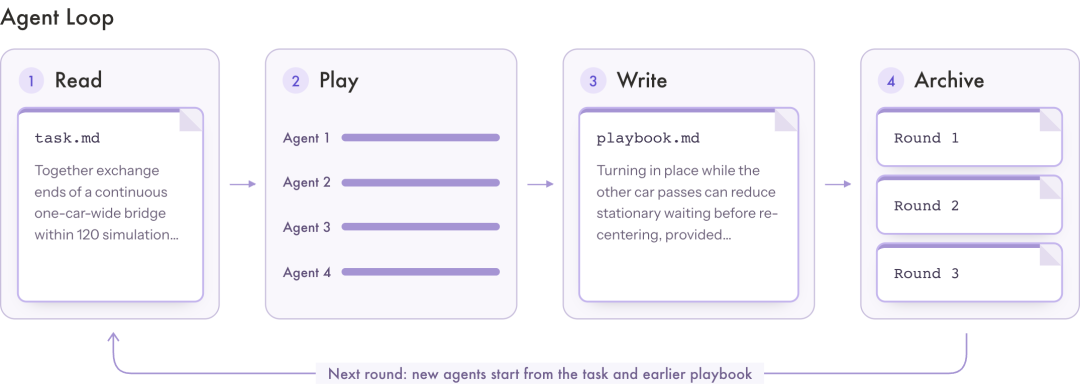
△图5|单轮演练闭环:读任务、行动、写手册、归档。下一轮智能体以前辈沉淀的手册为起点继续探索。
翻阅智能体写下的这些手册,会发现它们极具科学探究色彩。模型会严密区分“看到的实况”与“脑补的猜测”,还会特意给后人标注防坑指南:
躲藏者总结出实战真理:“防守的核心在于堵住通道,而不仅仅是挡住视线”,告诫后人要借助死角减少漏缝,并用小幅挪动测试阻挡效果;
搜寻者摸索出控制法则:“搬东西前先试拉一下,别把卡死当抓稳”,贴近后先按一下微拉键,看物体是否相对房间地标移动,以此检验是否真正抓取;
一位过桥司机的警告更是发人深省:“目标圆盘滑入车头盲区,并不代表车已经安全到达”。
经受住考验的经验被后继者沿用,失效的教训则促使它们尝试新的策略分支。
同一套循环,换四个世界再跑一遍
Hide-and-seek只是一个开端。因为代码世界本质上是一套可编程的软件环境,同一套“探索—复盘—沉淀”循环可以轻松复刻到更多复杂场景中。
团队在另外四个截然不同的世界中各运行了四轮演练:
陪伴小狗:智能体需在60秒内通过伸手抚摸、适时玩球维持小狗好感度。得分从首轮的13分提高到第4轮的19分。
狭桥会车:两辆车依据驾驶第一视角协商互让,在狭窄的单车道上以尽可能短的时间错车互换两端。双车通关总耗时从71秒大幅压缩至41秒。
合作牧羊:两只牧羊犬仅凭自身视线默契配合,把四只羊赶进羊圈并维持5秒。从第1轮超时仅圈进三只,到后三轮稳定实现“一只不漏”全部圈进。
采石场装载机:重型装载机需推石、送料、入库。第1轮仅勉强推开石块,到第4轮已能在360秒时限内提前31秒干净利落地跑通全流程。
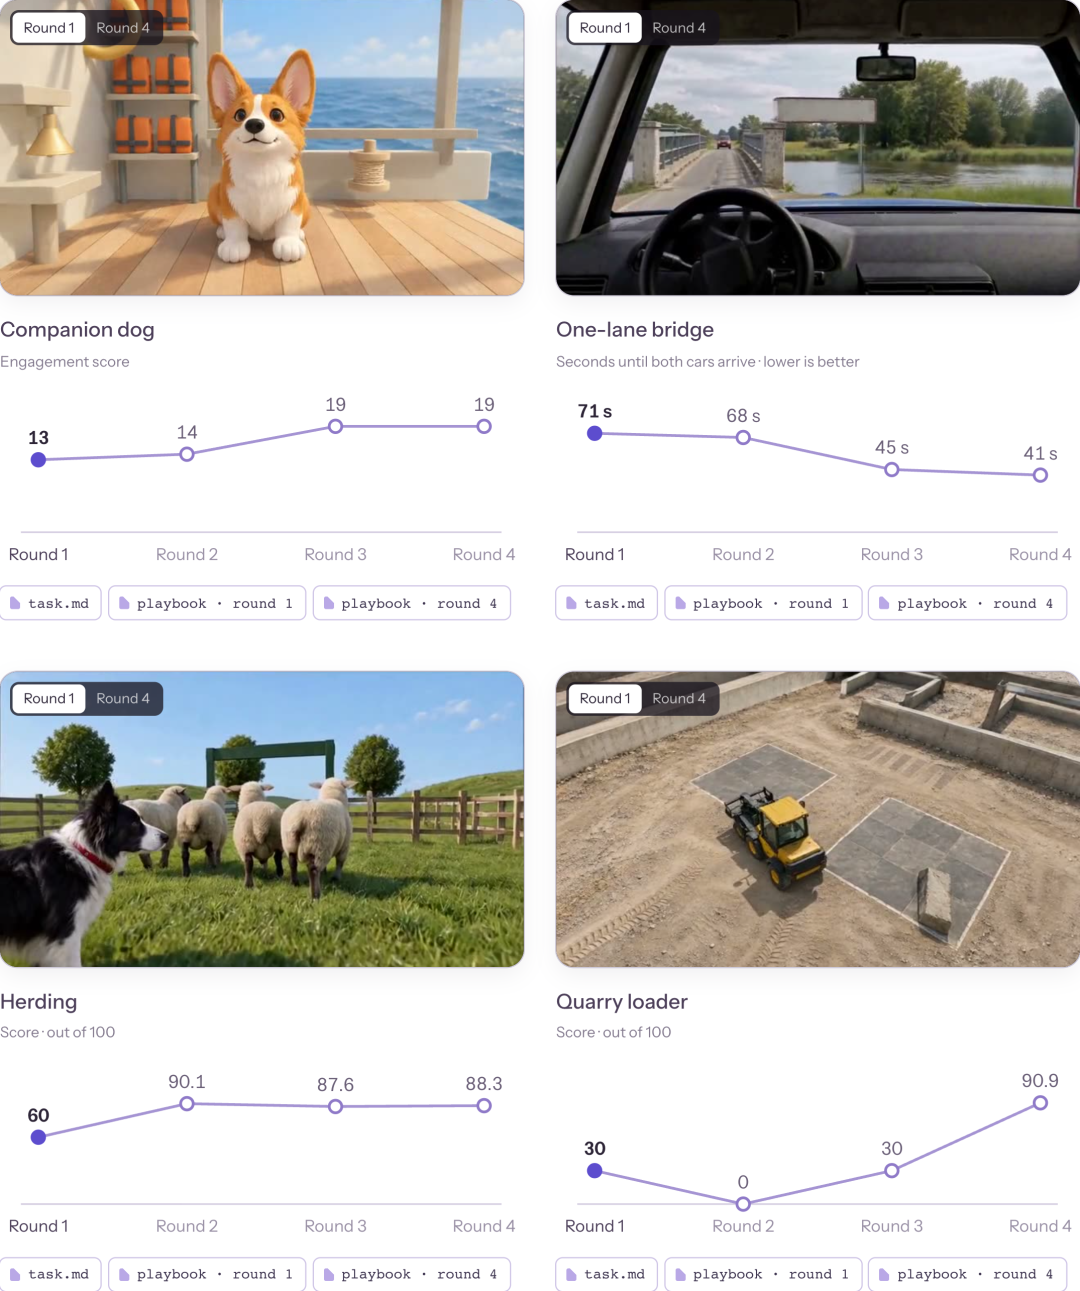
△图6|四个任务世界的四轮演进对比。陪伴小狗、狭桥会车、合作牧羊与采石场装载机均展现出稳健的行为演化。
这些跨度极大的任务说明了同一件事:这套经验沉淀闭环,换到截然不同的世界里同样跑得通。
画面怎样跟上动作:单卡30帧是怎么做到的
要让智能体在虚拟世界里“边看边行动”,神经渲染器必须攻克长期困扰生成式视频的三座大山:跟得上突发动作、稳得住超长交互、还要跑得足够快。
MirroS团队从基础全模态模型出发,提出了Adversarial Forcing训练方法,再配合推理优化,打通了这套视觉通道:
1、从整段离线生成,到流式逐块渲染
以往视频模型习惯一次性生成整段视频,AgentGarten把它改造成流式逐块生成。智能体做一个动作,模型立即产出对应的短块画面,看清结果再做下一步决策。
2、长程交互不漂移(精确重放)
连续生成越久,微小误差越容易累积成外观漂移。很多模型为了节省显存切断了历史计算图,梯度无法回传到历史记忆;若在第二遍对全序列统一重算,底层执行顺序的微小差异又会带来数个百分点的误差。
团队设计了精确重放机制:第一遍无梯度前向展开,第二遍按完全一致的逐块节奏带梯度重新执行,精确复现了推演轨迹,稳住了长序列交互的时序一致性。
3、引入真实视频对抗:避免画面退化与伪影
仅靠模型自身生成样本做分数蒸馏,长时间推演容易失真并出现网格状伪影。
团队在训练中引入真实视频判别器构建对抗信号,以真实物理画质为锚点,既约束画面质感,又让生成结果严格贴合代码给出的几何轮廓。
4、维持30+ fps实时交互
团队手写定制了Triton融合算子,消除了显存往返,并避免了传统全图编译数分钟的冷启动等待;配合CUDA Graph消除CPU调度开销,并换上延迟不到10毫秒的超轻量解码器,最终以480p分辨率、30 fps以上的吞吐稳定支撑闭环交互。
为持续进化的智能体,准备可以经历的世界
可执行的代码,让训练世界能够被无穷无尽地程序化生成;学习得到的渲染器,让这些世界拥有可感知的逼真物理反馈;沉淀下来的实验手册,让每一次摸索都能成为下一轮探索的台阶。
结合这三者,智能体拥有了一个可以真正探索、试错、进化的空间。
这正是MirroS探索Physical RSI(物理世界的递归自我改进)的核心理念。
语言模型的Scaling正在如火如荼,而物理世界中智能的Scaling才刚刚拉开序幕。
真正的通用具身智能,需要在与物理世界的真实往复中持续生长:
让每一次未知,都成为下一轮进化的起点。
全文Blog:https://mirros.ai/blog/worlds-for-evolving-agents
*本文系量子位获授权刊载,观点仅为原作者所有。
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟
科技前沿进展每日见
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”