


机器之心发布
Ola-Sem 正式开源版本来了!UniWAM 探索 Human-Robot Co-training 的 Scaling 趋势,实现世界理解、未来预测与动作生成的统一学习,代码与权重全面开源。
欧拉万象 x 香港科技大学(广州)(简称:港科广)此前曾联合发布 Ola-Sem,并在全球主流榜单上取得 SOTA 成绩。今天,Ola-Sem 的开源版本 ——UniWAM(Unified World-Action Model,统一世界与动作模型)正式发布,将语义理解、未来视觉预测与动作生成纳入统一架构,首次揭露 Human-robot Co-training 的 Scaling 趋势。同时,模型通过共享的物理语言监督,连接人类与机器人操作数据,探索如何将更丰富的人类经验转化为机器人可用的学习信号。
UniWAM 获得了多项基准 SOTA,在 LIBERO 上取得 99.2% 的平均成功率,在 LIBERO-Plus 上取得 92.6% 的整体成功率,在 RoboTwin 2.0 C2R 上取得 68.32% 的成功率,均达到论文所列方法中的领先水平。同时,UniWAM 进一步通过真机实验,验证了模型在指令跟随、复杂交互与长程任务执行中的能力。
这些成绩背后,是 UniWAM 对语义理解、世界预测与动作生成统一学习的探索。目前,模型代码与权重已正式开源。
一句 “收拾桌面”
机器人需要哪些能力?
面对摆满杂物的桌面,你会直觉对机器人说:“收拾一下桌面。” 这句话没有列出每一步。机器人需要识别物体,判断收纳策略,还要在执行中跟踪场景变化:杯子是否放好了?抽屉是否打开了?下一步该操作什么?
在 UniWAM 的长程桌面整理实验中,机器人在推理时接收的同样是一句高层指令:“Tidy up the desk.”。任务包含杯子放置、抽屉收纳盒笔的放置等多个子任务。而这些子任务彼此又存在因果关联:打开抽屉之后才能放入物品,完成收纳之后还需要关闭抽屉。机器人需要在连续操作中跟踪任务进度,并根据当前场景生成后续动作。
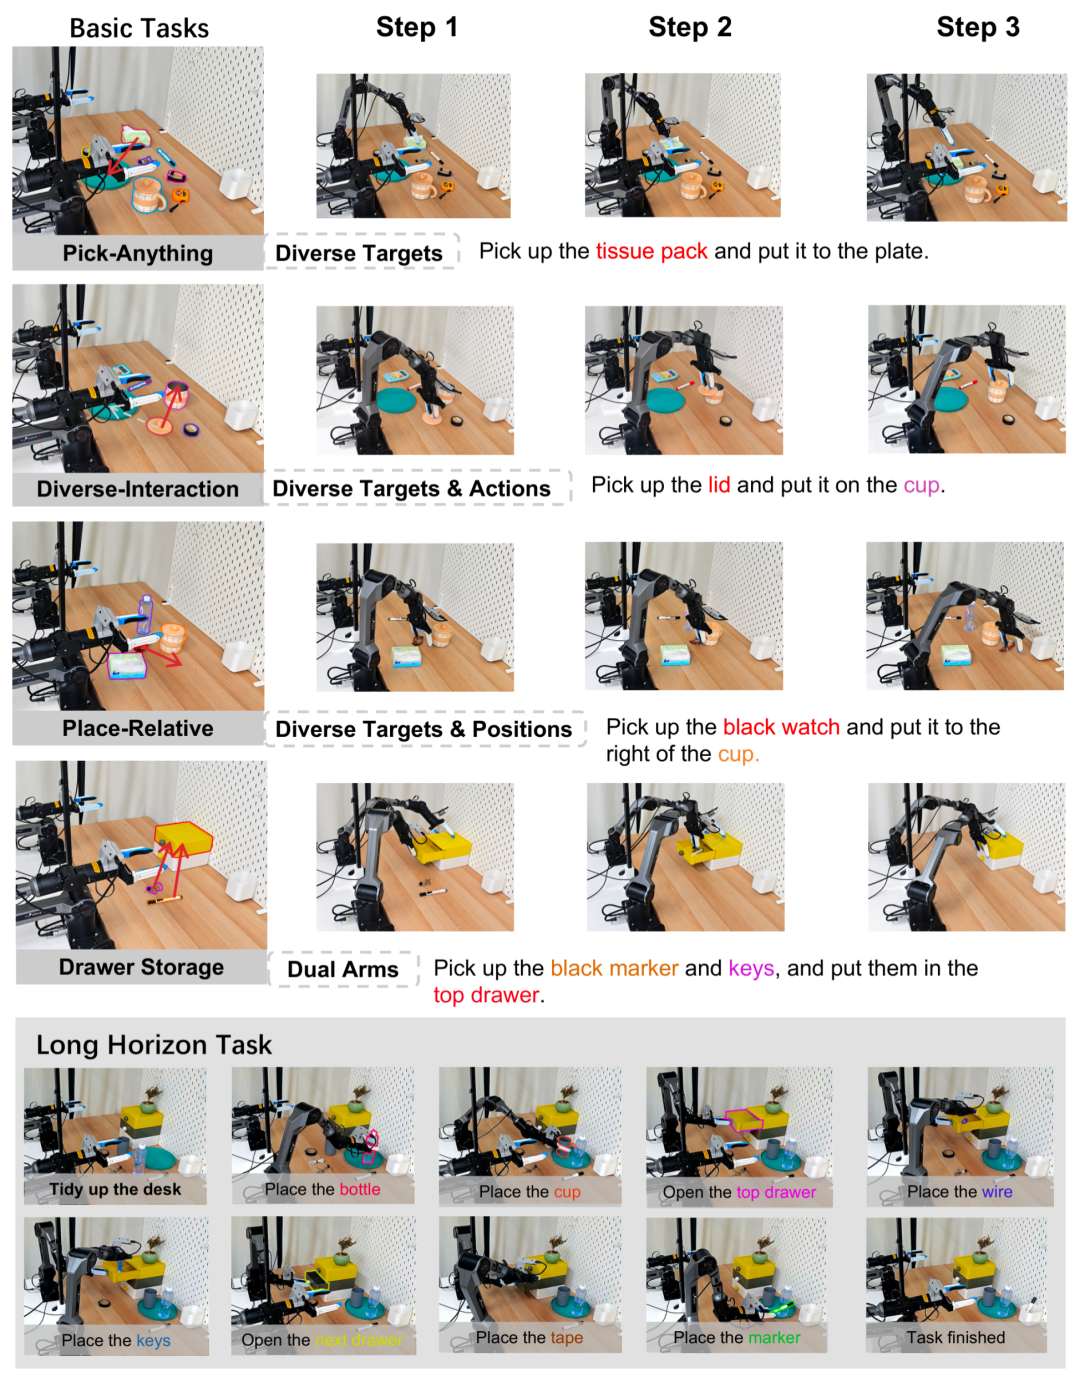
图 1|双臂平台上的多物体抓取、不同交互、相对位置放置、抽屉收纳与长程任务演示。
三种能力,一个统一架构
UniWAM 成功执行连续任务的目标引出了一个根本问题:机器人能否不再将理解、预测和行动视为彼此割裂的能力,而是在一个统一模型中学习、从而减少理解与执行之间的脱节,更好地应对复杂任务中的连续决策与环境变化?围绕这一目标,UniWAM 将语义理解、视觉动态与动作生成纳入统一架构,让任务要求、场景变化与动作信息在训练中相互关联,为更稳定、更连贯的机器人操作提供支持。
视觉 — 语言 — 动作模型(VLA)继承了视觉语言模型的语义能力,但仅靠动作监督,对世界动态的学习仍有局限。世界 — 动作模型(WAM)引入视频生成模型的时空先验,而面对环境变化,语义理解和推理同样重要。
UniWAM 将三类组件连接到统一架构中:
Physical Reasoner(物理推理器):基于 Qwen3-VL-2B-Instruct,理解当前视觉场景和任务指令,提供语义信息。
World Generator(世界生成器):基于 Wan2.2-TI2V-5B,学习预测未来视觉变化,为操作提供动态信息。
Action Predictor(动作预测器):建模连续动作的流场,生成机器人执行所需的动作片段。
三个组件通过联合多模态注意力交换信息,使动作预测能够结合任务要求与场景动态。UniWAM 的核心探索,是让理解、预测与行动在统一架构中相互关联、共同学习。
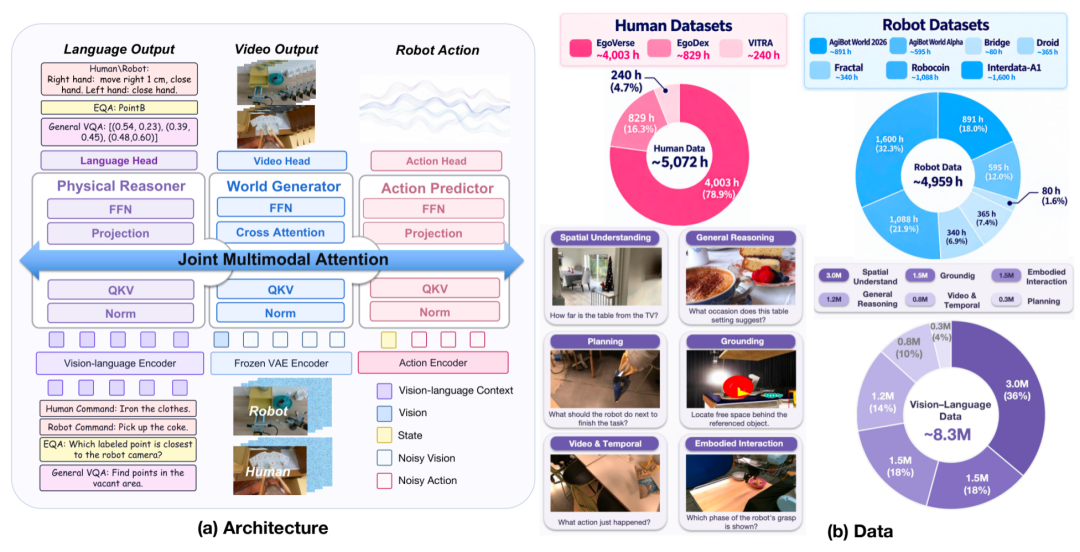
图 2|左侧为三个组件及联合多模态注意力,右侧为人类、机器人与视觉语言数据概览。
统一架构高效连接语义与动态
三个组件保留各自的特征处理方式,再把不同模态的 token 投影到共同注意力空间。语义、视觉和动作信息在该统一空间中交互,使动作预测可以结合任务语义和视觉动态线索。
世界生成器在冻结的视觉自编码器潜在空间中学习未来变化,动作预测器学习连续控制信号。两种生成目标通过共享信息建立联系,同时各自保留对应模态的建模方式。
物理推理器还保留语言预测目标,接受物理语言和视觉问答监督。这为语义能力提供直接训练信号:机器人既需要学会操作,也需要持续学习 “看到了什么”“指令要求什么”。
从架构设计,走向数据利用效率
人类操作视频包含丰富经验,但其中的动作标签往往需要通过估计获得。手部遮挡、相机运动和深度估计误差,都会影响轨迹的准确性。
团队在所分析的数据管线中观察到:二维轨迹的形状与运动趋势往往较可靠,误差更多集中在深度和绝对尺度。这意味着,一段轨迹即使难以提供精确的三维位移,仍可能保留运动方向和操作意图等可用信息。
UniWAM 因此探索一种共享监督方式:在学习视觉变化的同时,利用这些仍然有效的运动信息,帮助模型建立动作与场景变化之间的联系。
用物理语言表达动作段,加速动作学习
UniWAM 设计 physical language(物理语言),用自然语言描述动作,为人类与机器人数据提供共享监督。
例如,一个动作段可以写成 “向前移动 5.5 cm,再顺时针转动 30°”。这里的数值用于说明表示形式:语言可以把方向、位移与旋转可以通过已有语言组织起来,与 VLM 视觉语言模型的预训练表达方式相接。
这种设计侧重保留运动趋势和意图,降低对精确连续标签的依赖。语言描述为理解组件提供辅助监督,动作预测器仍学习连续控制,不要求机器人先逐字输出动作说明再执行。
提升数万小时的数据质量与数据规模
团队搭建清洗与标注管线,处理超过一万小时机器人与人类第一视角数据,并混合 VQA 问答数据进行预训练。机器人示范提供控制经验,人类操作扩大场景与行为覆盖,VQA 补充空间、物体与交互状态理解。
机器人数据经过时序、几何与视觉质量检查;人类数据使用子任务级描述。团队为 EgoDex 构建 EgoANT,先由粗到细定位操作事件,再生成并筛选描述,使语言与局部视频事件对应;EgoVerse 和 VITRA 的已有标注保留使用。
值得注意的是,数据清洗不仅要去除低质量样本,更要保留具有物理交互价值的信息。 例如,视觉变化很小的片段可能包含夹爪闭合,不能仅因画面静止就删除。结合视觉、状态与动作信息处理,能够让可用经验更完整地进入训练。
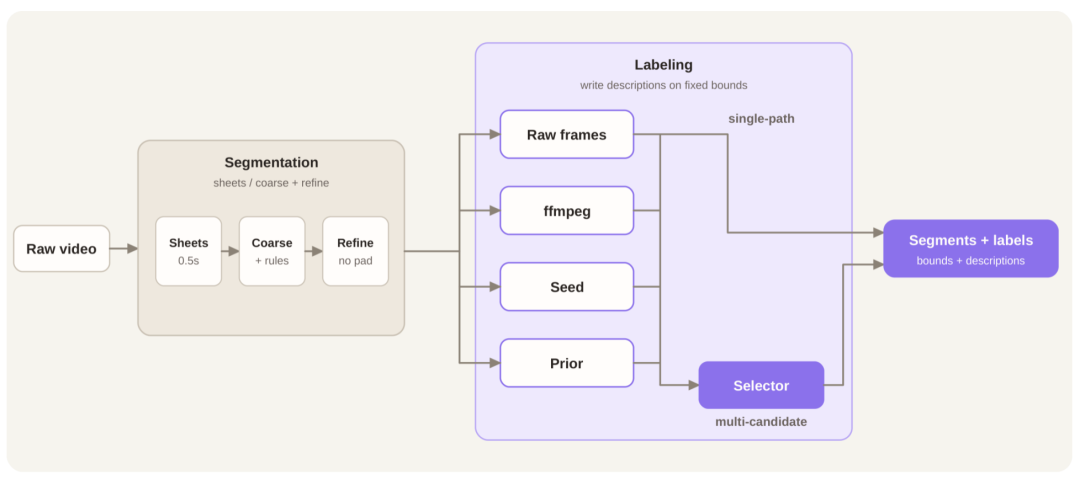
图 3|从长视频中定位操作事件,再为片段提供对应的子任务描述。
Physical AI,最终要落在动作上
理解之外,还要高效稳健行动
对于 Physical AI 而言,动作不应只是模型理解世界后的最终输出,更应成为学习物理世界的重要信息来源。在连续操作中,机器人的历史动作不仅记录了此前的执行过程,也为预测后续动作提供了重要线索。
基于这一思路,UniWAM 引入历史条件流匹配(History-Conditioned Flow Matching),不再完全从随机噪声开始生成动作,而是利用经过扰动的历史动作作为初始化,通过少量去噪更新预测未来动作片段。这种方式充分利用动作之间的时序关联,在减少生成步数的同时,保持较高的操作成功率。
与此同时,机器人对未来场景的预测并非总是准确。为此,UniWAM 在后训练中引入未来视觉噪声增强(Future Visual Noise Augmentation),通过对未来视觉表示施加扰动,降低动作生成对精确未来预测的依赖,使模型能够更好地应对预测中的不确定性。
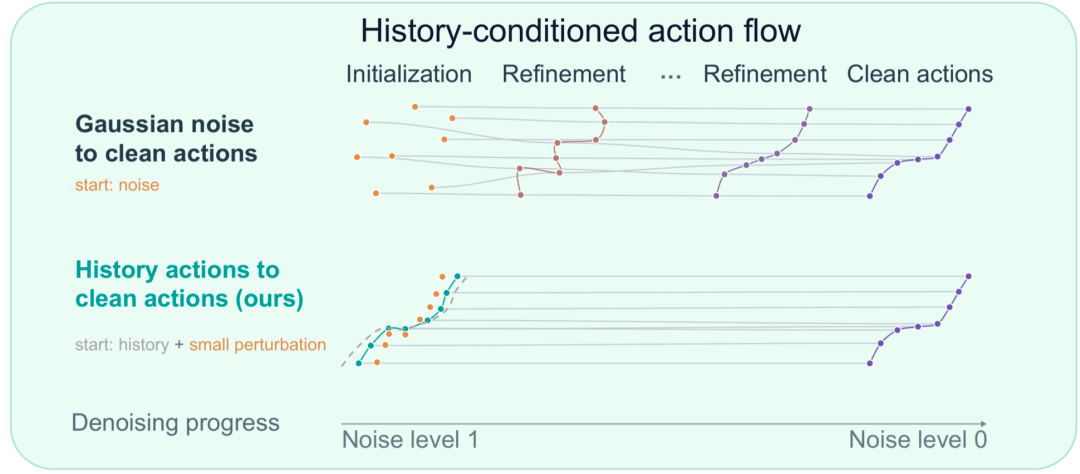
图 4|利用历史动作作为生成起点,通过去噪更新预测未来动作片段。
少步生成,保持高成功率
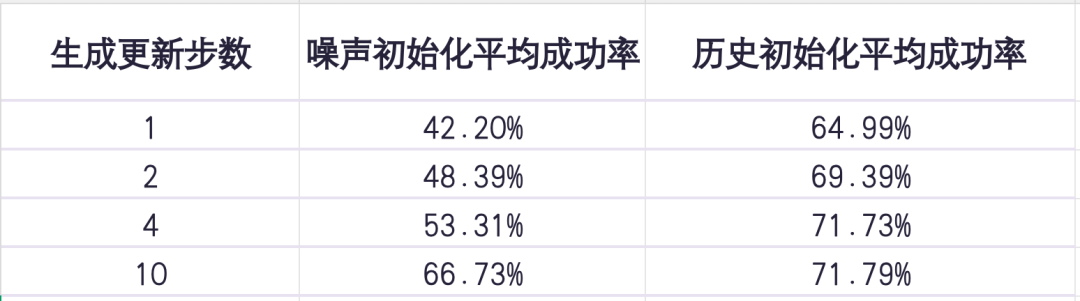
平均值为 RoboTwin C2C 与 C2R 的算术平均。
实验结果表明,历史动作初始化能够显著减少动作生成所需的更新步数。仅需 1 步,平均成功率就达到 64.99%,相比噪声初始化提升 22.79 个百分点;在 4 步时达到 71.73%,与 10 步生成仅相差 0.06 个百分点。这表明,利用历史动作信息,可以在保持操作表现的同时,有效减少生成过程中的迭代更新。
图 6 (c) 进一步的消融实验也验证了两项设计的作用:历史动作初始化将平均成功率从 64.80% 提升至 69.73%,加入未来视觉噪声增强后进一步达到 71.34%。这一结果表明,历史动作信息与未来视觉增强能够共同改善模型的动作生成表现。
从仿真到真机
验证复杂场景下的机器人操作能力
仿真评测:从标准操作到复杂环境变化
UniWAM 在多个机器人操作基准上取得领先成绩,展现了模型在任务执行与环境泛化方面的能力。
在标准操作基准 LIBERO 上,UniWAM 取得 99.2% 的平均成功率;在引入多种环境扰动的 LIBERO-Plus 上,整体成功率达到 92.6%;在 RoboTwin 2.0 的随机化环境测试中,成功率达到 68.32%。
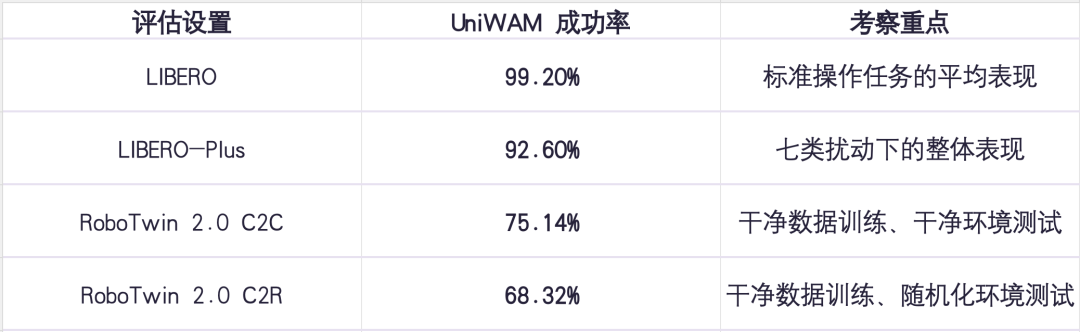
上述三项为多项基准 SOTA:排名限定于论文对应表格所列方法中的最高值。
真实环境往往不会完全符合训练时的条件。光照可能变化,物体可能被移动,相机视角也可能发生偏移。因此,除了标准任务成功率,机器人能否适应环境变化,是衡量模型能力的更加重要的指标。
LIBERO-Plus 从背景、相机视角、语言指令、光照、物体布局、机器人初始状态和传感器噪声七个维度评估模型的鲁棒性。
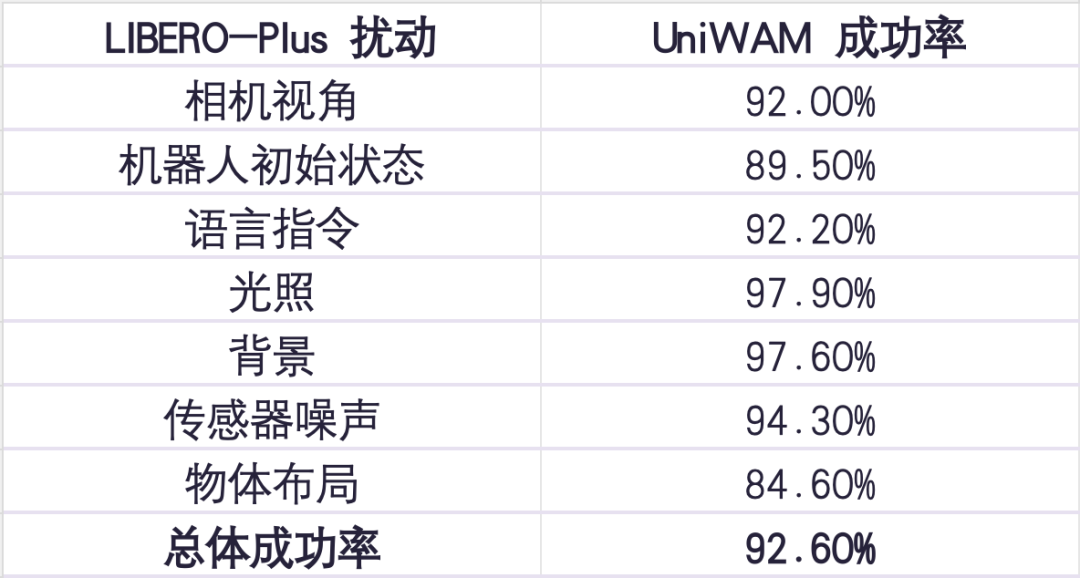
LIBERO-Plus 评测结果。
UniWAM 在机器人初始状态、语言、光照与背景四项评测中,均取得论文所列方法中的最高成绩。即使面对更具挑战性的物体布局变化,仍达到 84.6% 的成功率,展现了模型对不同环境条件的适应能力。在涵盖 50 项任务的 RoboTwin 2.0 基准上,UniWAM 进一步接受随机化环境测试。
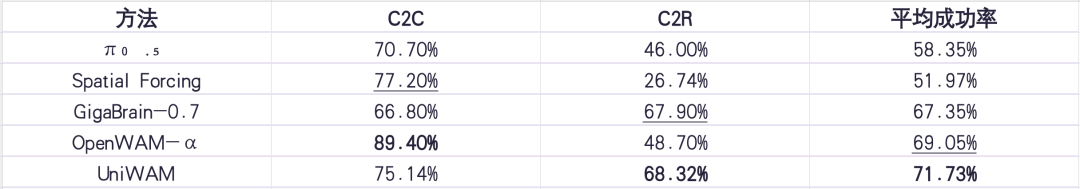
平均成功率为 C2C 与 C2R 的算术平均;加粗与下划线分别标示本表各列的最优与次优值。
从标准环境(C2C)切换至随机化环境(C2R),UniWAM 的成功率仅下降 6.82 个百分点,并在 C2R 测试中取得所列方法的最高成绩。这表明 UniWAM 不仅能够完成标准操作任务,也在面对环境变化时表现出较好的泛化能力。
真机验证:从指令理解到连续操作
仿真基准验证了模型在不同任务与环境下的表现,而真实机器人实验则进一步检验这些能力能否转化为实际操作。
UniWAM 在双臂 AgileX Piper 机器人平台上开展真机实验,涉及多达 18 种物体,并设计了四类不同难度的操作任务:
多物体抓取: 考察能否根据指令正确选择目标物体。
不同交互: 考察能否同时理解操作对象与动作要求。
相对位置放置: 考察能否理解并执行空间关系指令。
抽屉收纳: 考察双臂协作与复杂操作能力。
实验将 UniWAM 与 π₀.₅、Motus 进行对比,各方法均采用每任务 200 条示范数据,并在相同训练协议下联合训练单个策略。
在四类真机任务中,UniWAM 取得 67.5% 的平均任务成功率和 82.5% 的指令跟随率。其中,在不同交互任务中,UniWAM 的任务成功率达到 72.5%,显著高于 π₀.₅ 的 40.0%;指令跟随率达到 80.0%,相比 π₀.₅ 的 50.0% 同样有所提升。
这两个指标分别衡量机器人是否正确理解任务要求,以及是否真正完成操作。理解指令并不意味着能够成功执行,只有将任务理解与动作生成有效结合,才能把用户的要求转化为实际结果。
除了单项操作,UniWAM 还进一步挑战了长程桌面整理任务。
机器人需要根据一句高层指令,连续完成杯子放置、抽屉开合与物品收纳等六个相互关联的操作阶段。训练阶段采用细粒度子任务描述提供监督,而推理阶段仅输入高层任务指令。
在这一任务中,UniWAM 取得平均 5.0/6 的任务进度得分,优于 π₀.₅ 的 4.8 和 Motus 的 3.2,展现了模型在多阶段连续操作中的执行能力。
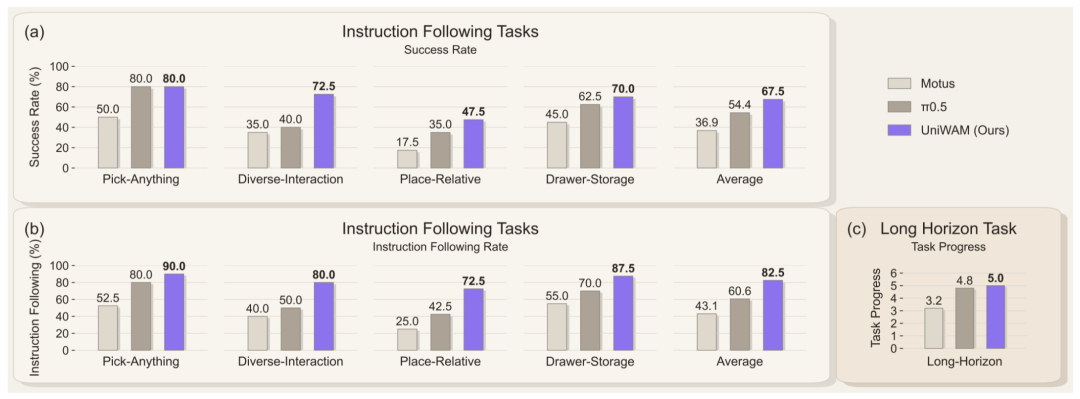
图 5|四类真机任务的成功率与指令跟随率,以及长程任务的平均进度得分。
消融实验
人机联合训练与物理语言监督的价值
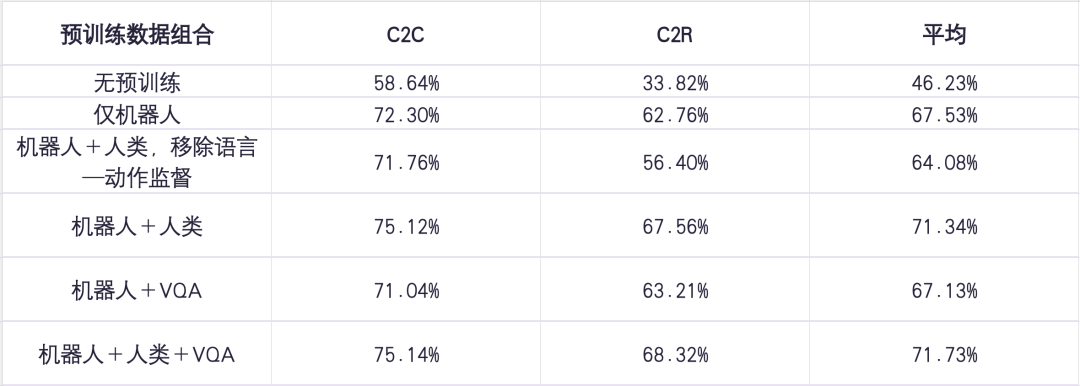
预训练数据组合消融。
机器人数据预训练把平均成功率从 46.23% 提升到 67.53%,加入人类数据后达到 71.34%,三源混合达到 71.73%。但仅在机器人数据上加入 VQA,并未在平均指标上超过机器人单源方案,这说明对于好的模型效果,数据来源与组合方式都需要具体设计。
在机器人+人类设置中,移除语言 — 动作监督后,C2R 从 67.56% 降至 56.40%,相差 11.16 个百分点。这是对共享监督价值的实验支持。
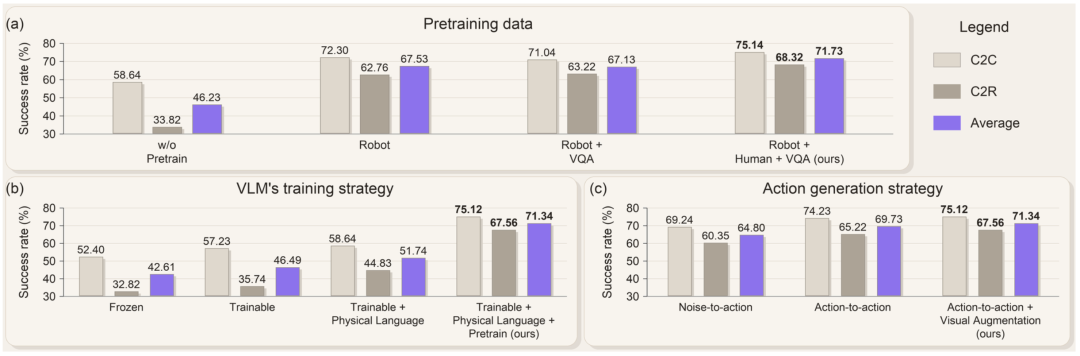
图 6|三组消融分别考察预训练数据、理解组件训练策略和动作生成。
图 6(b)理解组件的累积消融也呈现逐步改善:冻结 VLM 时平均为 42.61%,解冻后为 46.49%,加入物理语言监督后为 51.74%,进一步预训练后为 71.34%。这组实验支持对理解组件进行具身适配,也显示训练配方与统一架构需要配合发挥作用。
规模化人机联合训练
展现 Scaling 趋势
如何让更大规模的人类操作经验真正转化为机器人能力,是具身基础模型 Scaling 路上的重要问题。
UniWAM 的实验呈现出两个值得关注的趋势:随着机器人预训练数据规模扩大,模型的下游任务表现持续改善;而当机器人数据达到一定规模后,引入人类第一视角数据能够带来进一步收益,且增益随规模扩大更加明显。
同时,在当前实验范围内,人机混合预训练的收敛验证损失与数据规模呈现近似对数线性关系,拟合 R² 达到 0.983,初步展现出具身预训练的 Scaling 潜力。这为进一步探索更大规模的人机联合预训练提供了实验依据。
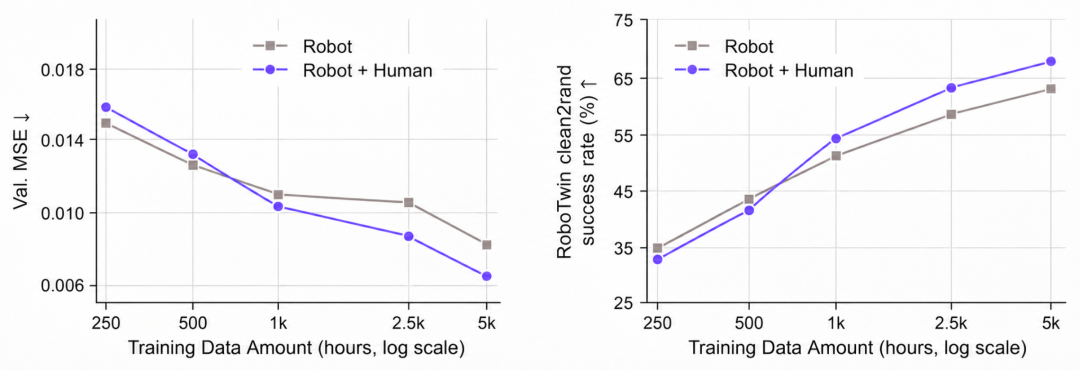
图 7|左侧为验证损失,右侧为 RoboTwin C2R 成功率;横轴为机器人数据小时数,混合组额外加入人类数据,各组均包含 VQA。
人机表征是否出现更多共同结构?
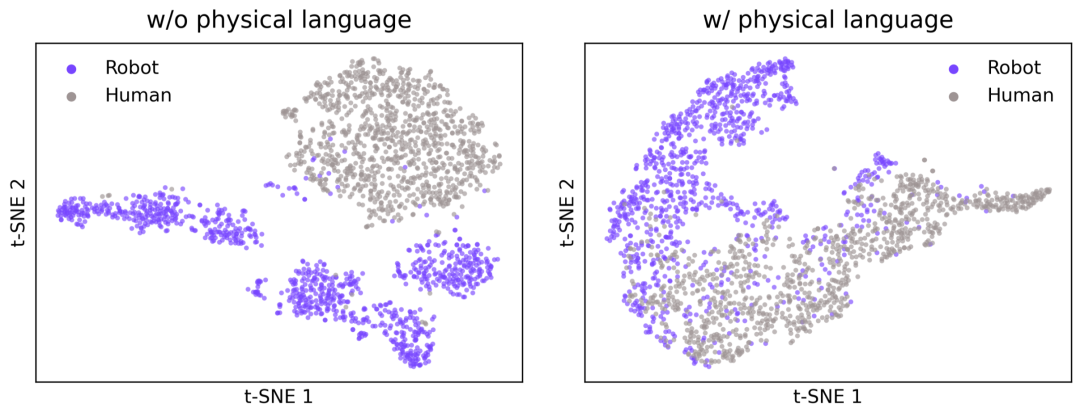
在 t-SNE 可视化中,加入物理语言监督后,人类与机器人数据的表征呈现更多重叠。这一现象与共享监督促进共同表征的研究目标相一致。
结合前面的操作评测与数据消融,可以从表征变化和任务表现两个角度观察这一设计的作用。可视化提供了辅助线索,跨本体经验能否有效用于操作,仍需要通过具体任务评测判断。
从 UniWAM 到 Real-World RSI
让机器人在真实世界中持续成长
UniWAM 并非一项孤立的模型研究,而是欧拉万象沿着 Action-Native Foundation Model 技术路线,与港科广联合开展的一项阶段性探索。通过统一学习语义理解、未来视觉预测与动作生成,UniWAM 不仅关注机器人如何执行动作,更尝试让动作参与物理世界表征的学习,建立动作与环境变化之间的联系,为更复杂的真实任务提供模型基础。
这一探索也是欧拉万象长期构建 Real-World RSI(真实世界递归自进化)的重要基础。在 UniWAM 的基础上,机器人不断进入真实环境执行任务,由 AI 系统识别执行过程中的失败、异常与能力不足,并将这些信息转化为下一轮模型、基础设施或本体改进的输入。UniWAM 所探索的世界与动作联合建模、人机数据规模化联合训练,以及多维度的任务评测,正是在为这样的持续改进过程构建基础。我们的长期目标,不是训练出一个在 Benchmark 上表现更好的模型,而是让机器人的能力能够随着真实世界中的经验积累,持续成长。
目前,UniWAM 的模型与训练代码、预训练及后训练权重已全部开源,并提供相关基准的训练与评测资源,欢迎研究者基于开源成果开展进一步探索。
开源入口:
GitHub 代码:https://github.com/UniWAM/UniWAM
ModelScope 模型权重:https://www.modelscope.cn/collections/Kosmos524/UniWAM
|(注:部分内容由豆包工作 AI 生成)
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com