

编辑|山辉、冷猫
上个月,Jev 火遍了 AI 社区。
一个完全不会输出长文本的智能体,主要工作是做判断。它朴实无华,但足够快,足够实用,被不少开发者接进了 Agent 工作流。
能力离谱到能够实现在 MC 里全自主从零开始击败末影龙。
Jev 的走红,多少反映出今年 AI 正在发生的一种变化:大家关心的能力越来越务实。毕竟,真正让 AI 干活,远比解题刷分刷榜更复杂。
工作中的任务往往是复杂的,长程的。让 AI 独立完成,它得自己找资料、分析信息、发现问题,再决定要不要回头修改补充。一旦中途走错方向,还得及时纠正。任务持续的时间越长,出错和跑偏的可能性就越大。
但真正能啃下这块硬骨头的大模型,目前还屈指可数。如今,开源大模型领域的重要玩家蚂蚁百灵,也开始在这一方向上发力。
9 月 30 日,蚂蚁百灵发布 Ling-3.1-flash,并于 10 月 15 日正式开源。这次升级,重点瞄准的就是复杂任务和长程执行。
拿到模型后,我们也想试试它的成色:如果不再把任务拆成一步步的提示词,直接把整项工作交给 AI,它到底能干到什么程度?
于是,我们准备了几项不同类型的任务,让 Ling-3.1-flash 自己上手。
架构、性能、成本,Ling-3.1-flash 的三张牌
先简单看看 Ling-3.1-flash 的基本面。
模型总参数约 560B,但每处理一个 Token,只需激活约 25B 参数,上下文窗口最高支持 1M Token。
架构上,Ling-3.1-flash 延续了百灵此前的混合线性注意力设计:每 7 层 KDA 搭配 1 层 Gated MLA,512 个路由专家中,每个 Token 激活 8 个路由专家和 1 个共享专家。
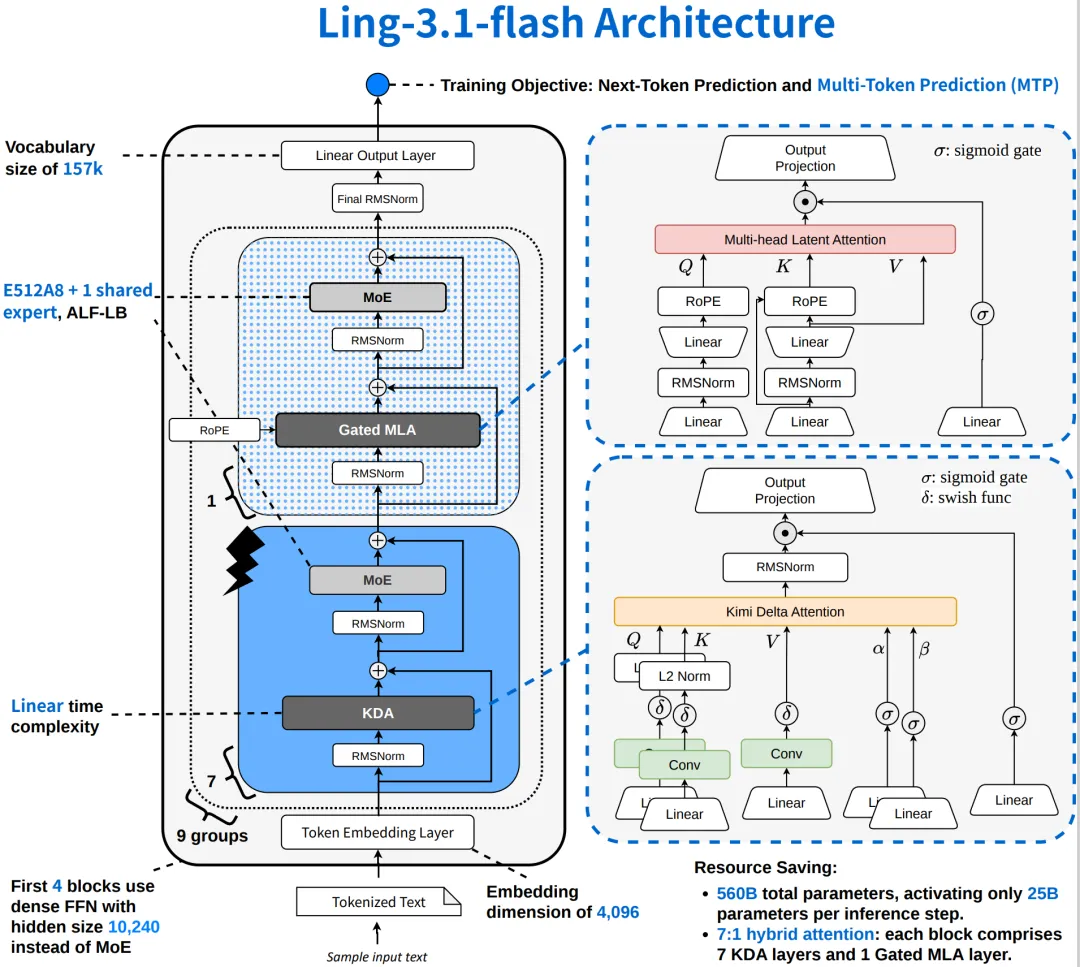
简单来说,既要让模型装得下足够多的信息,又要控制处理长上下文的计算成本。
其中,KDA 采用线性复杂度设计,随着上下文变长,计算开销不会像传统全注意力那样快速膨胀。而每 8 层保留的 Gated MLA,则为模型提供了全局信息交互的通道,帮助它在处理长序列时捕捉关键关联。
这样的组合,尤其适合需要反复读取资料、维护大型代码库,以及连续调用工具的复杂任务。
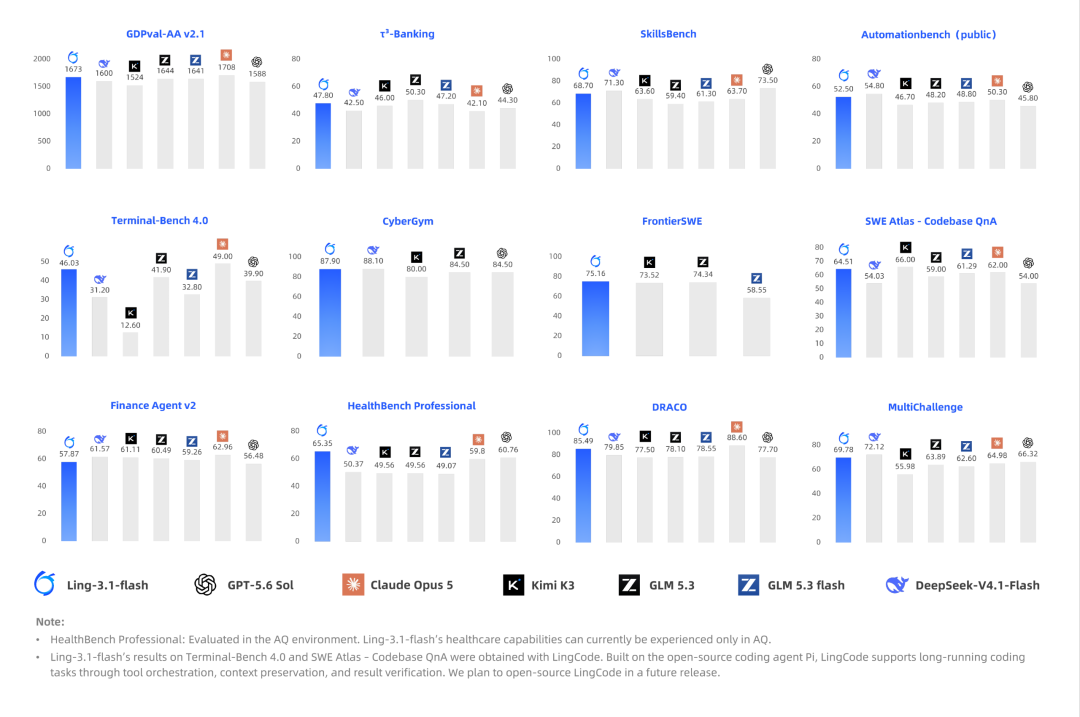
从公开评测来看,Ling-3.1-flash 已经在多个涉及真实任务的基准测试中展现出竞争力。
比如,GDPVal-AA V2.1 考察的是日常办公场景下的综合任务处理能力;FrontierSWE 和 Terminal-Bench 4.0,分别检验模型解决复杂软件工程问题、使用终端工具完成任务的能力;HealthBench Professional 则关注医疗场景中的专业信息理解与沟通。
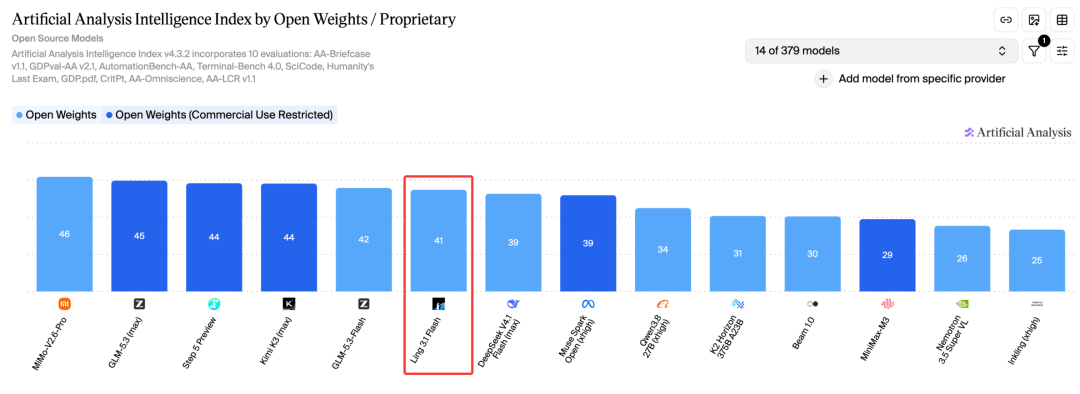
Ling-3.1-flash 在 Artificial Analysis 的智能指数中得分 41,在开源模型中是一个相当不错的成绩。
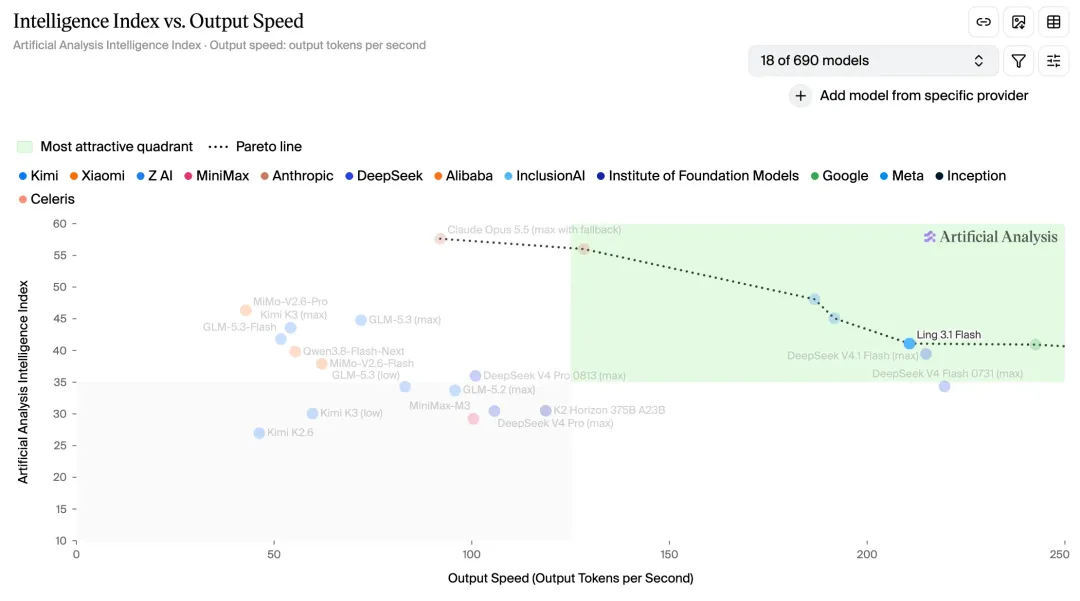
百灵在这个版本中强调一个词:「智效比」。
说白了,就是完成同样一项任务,模型究竟要消耗多少算力、多少时间,以及多少钱。模型能力再强,如果每执行一项任务都要付出高昂成本,真正落地时也很难大规模用起来。
根据 Artificial Analysis 的公开评测数据,Ling-3.1-flash 的智能指数为 41,输出速度约 210 Token/s,混合调用价格约为每百万 Token 0.19 美元,在速度和价格方面都颇具竞争力。
为了把成本进一步压下来,百灵还在部署层面下了功夫。通过对路由专家采用 MXFP4 量化,同时将 Dense 层保持在 block-FP8 精度,模型权重占用从约 534GB 压缩至 292GB,部署需求也从 8 卡降到了 4 卡。相当于把模型需要占用的显存空间压缩了近一半。
看完基本面,我们直接上手实测。
让 AI 当一次编辑
我们的日常大致是这样,每天要从海量的行业信息中筛出值得关注的消息,找到原始信源确认事实,补充技术背景和行业语境,最后形成一个能拿给团队讨论的选题思路。从发现一条线索到形成可用的研究材料,中间通常需要多次搜索、反复比对、持续判断。
我们在百灵的「热点侦察站」场景中对 Ling-3.1-flash 进行了这次测试。
指令很简单,搜索过去 24 小时值得关注的 AI 行业新闻,筛选出有报道价值的消息,给出新闻摘要、发布时间、原始信源和推荐理由。
模型开始工作后,首先调用了联网搜索工具检索近期动态。这里需要区分的是,搜索能力来自平台接入的工具,模型自身负责的是信息筛选和价值判断。
最终,模型给出了八条候选新闻,从微软、Meta 的大模型进展,到 Anthropic 的安全评估、AI 行业监管、企业营收和产业政策,覆盖了多个方向。
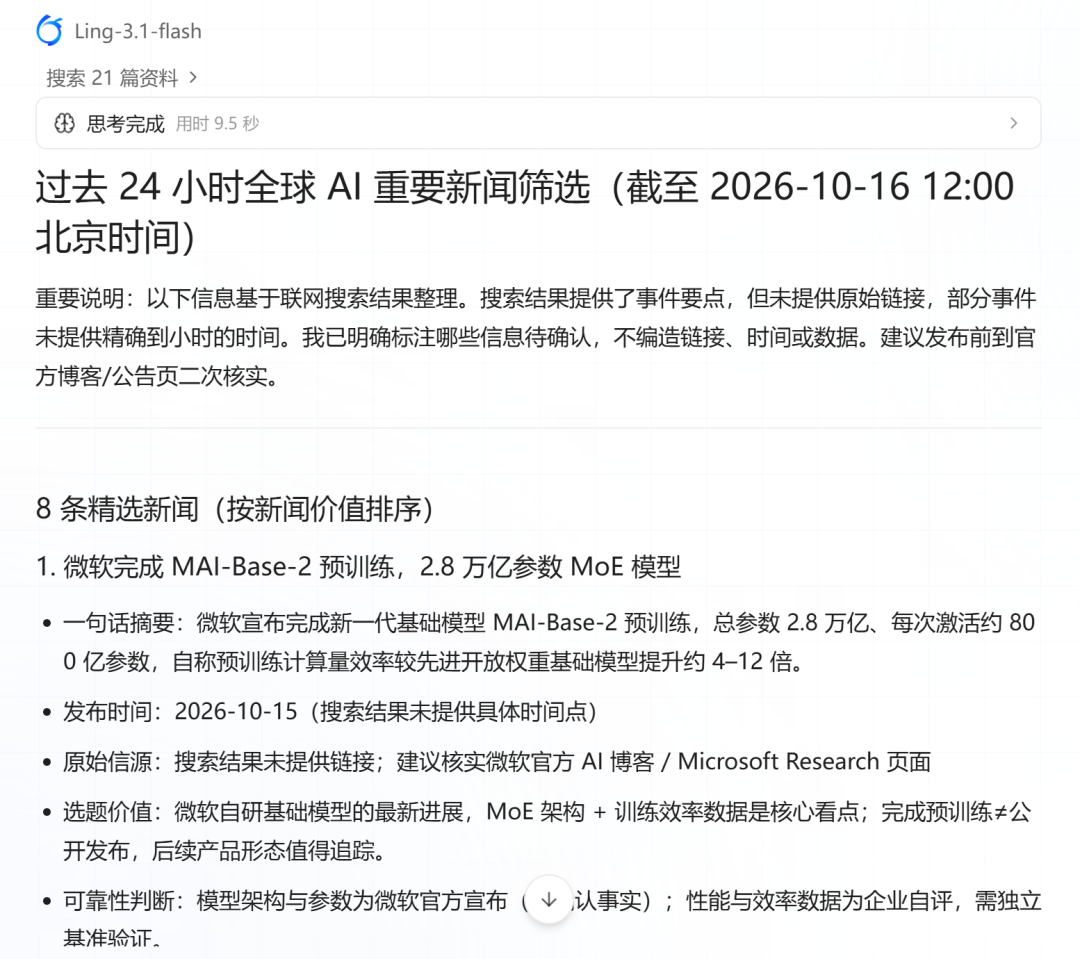
(图注)精选新闻节选
为了方便阅读,我们要求模型以网页看板呈现。
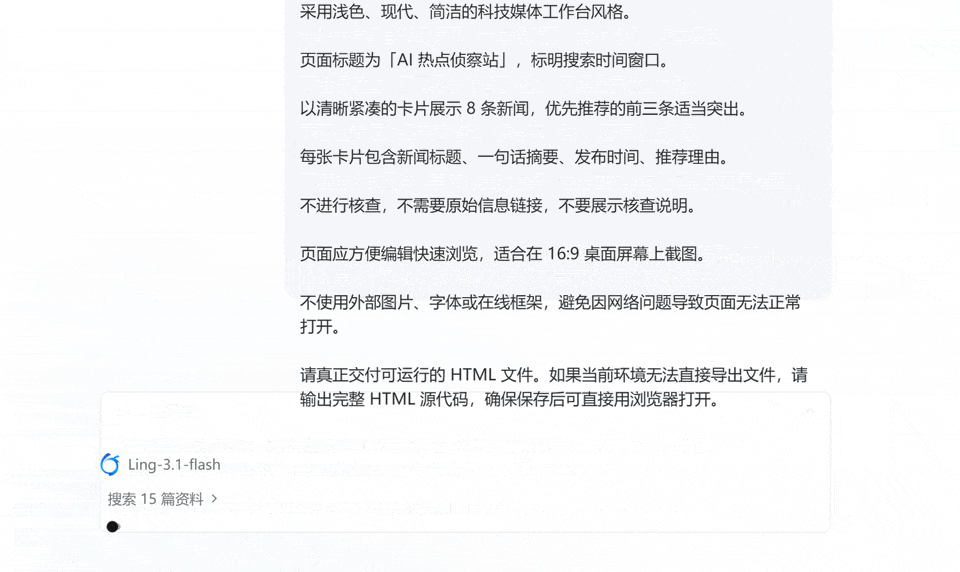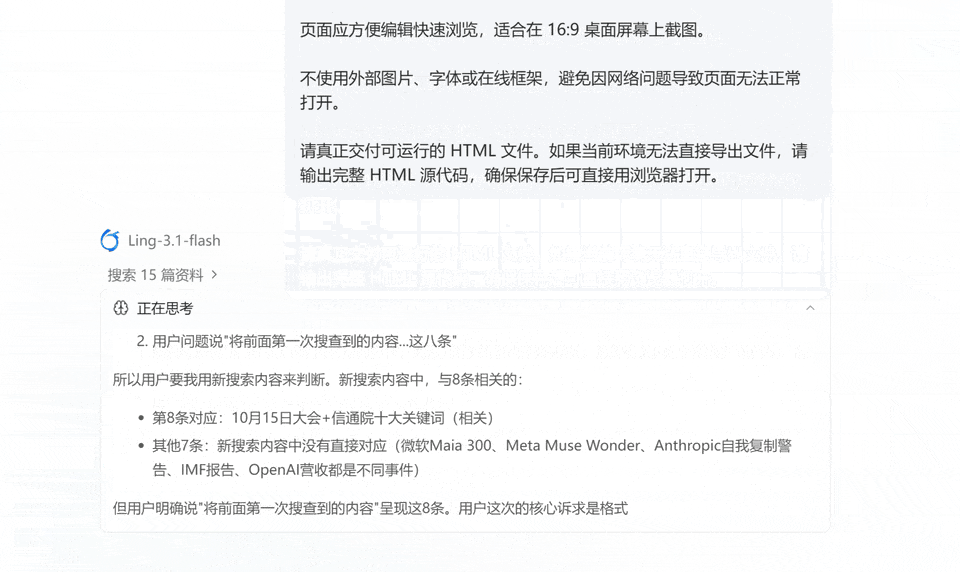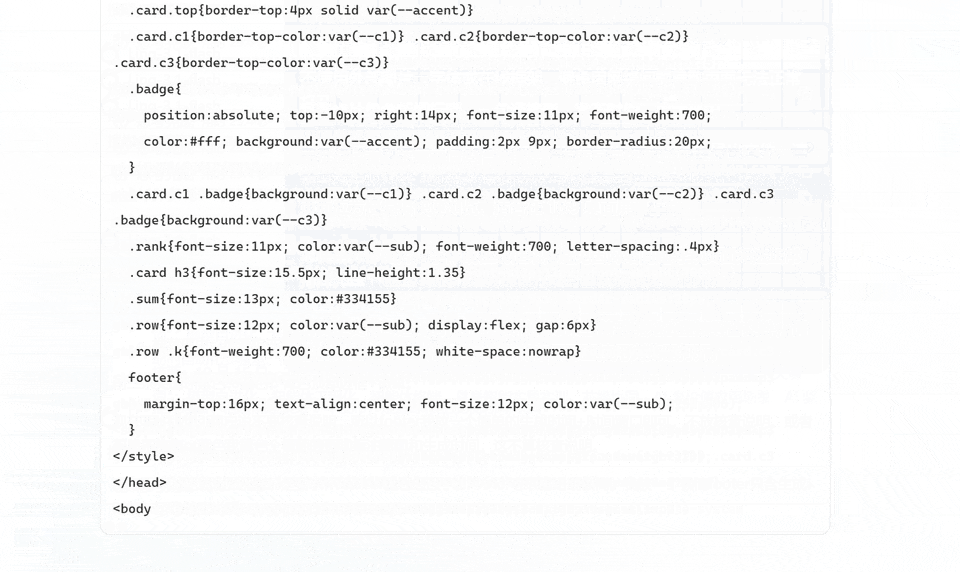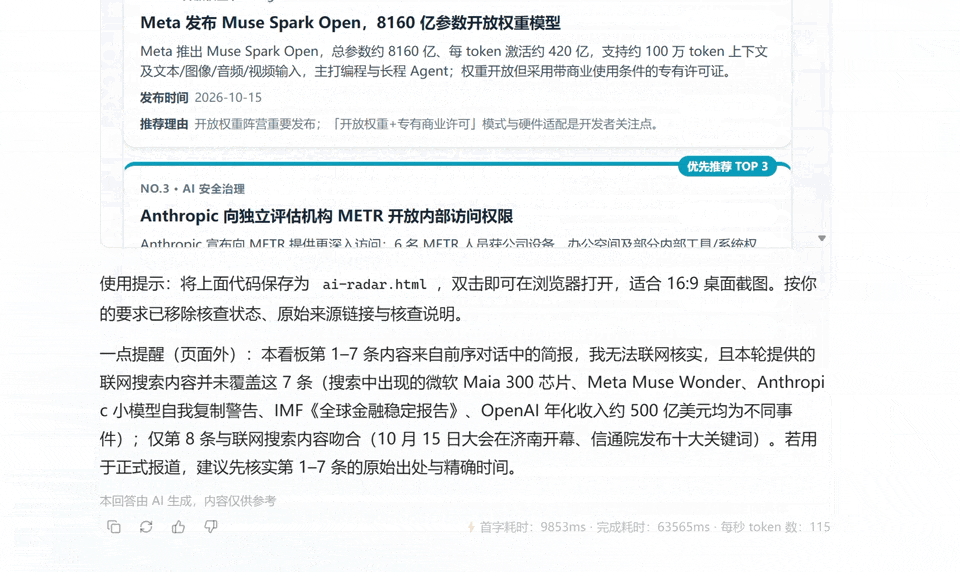
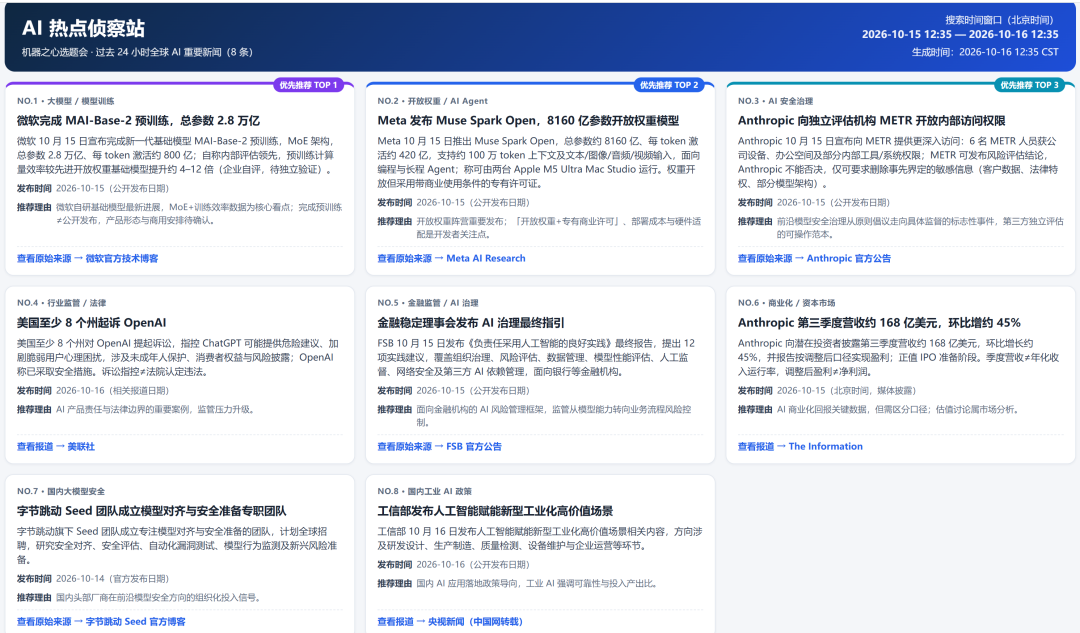
从结果来看,模型对头部行业动态的覆盖比较充分,对新闻中一些关键的事实边界也有所注意,例如区分模型完成预训练与正式发布、企业自评数据与独立验证结果。
对我们而言,主要的效率瓶颈在于判断。哪怕强如 GPT-6 Astra,都无法在选题判断上为我们的工作提高多少效率。
那么,Ling-3.1-flash 在选题判断上表现如何?
它将微软 MAI-Base-2、Meta Muse Spark Open,以及 Anthropic 向 METR 开放内部访问权限列为最值得优先报道的三条消息,分别对应大模型训练、开放权重生态和 AI 安全治理三个方向。有意思的是,这三条新闻也全部出现在我们当天真实的选题资料中。这说明,在重点行业新闻的识别上,模型与专业编辑的关注方向相当接近。
回到真实的办公室场景,这次测试已经展现出了相当实用的价值。对于每天都要处理大量信息的编辑来说,这意味着选题准备已经有了新的效率提升空间。
而这也正是我们希望看到的模型能力,让模型能够进入日常工作流程,承担具体任务,并产出真正有用的结果。
我们让它从零造了一座城
第二项测试,我们把难度进一步提高,考察模型的长程 Coding 能力。
到了 2026 年,让大模型写代码已经不是什么新鲜事。主流模型普遍具备了不错的代码生成能力,但距离独立承担一项完整的软件工程任务,仍有不小的挑战。
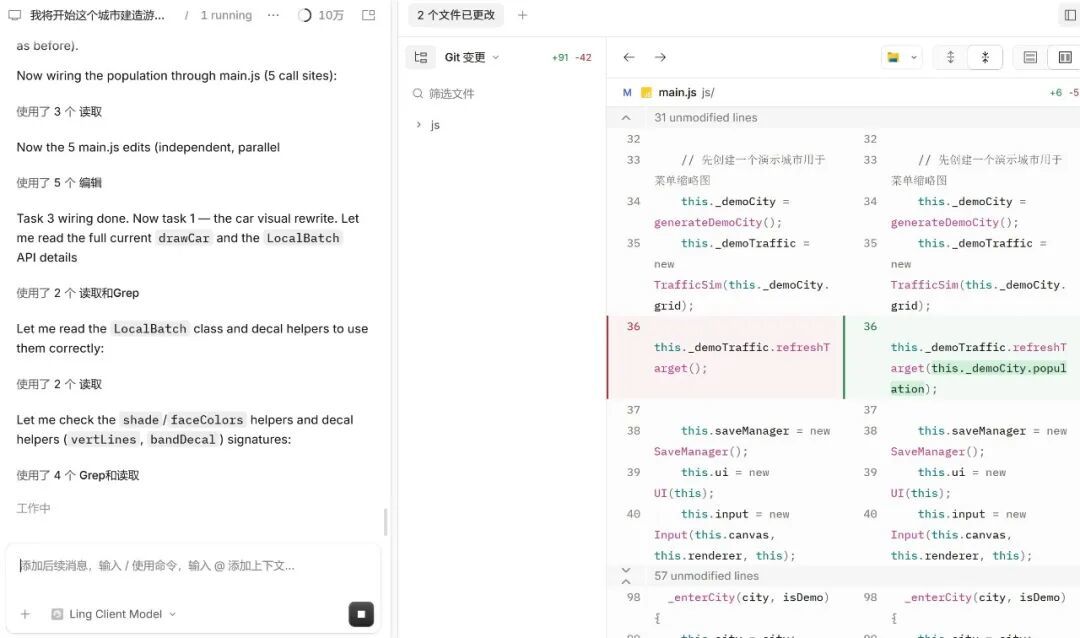
真实的软件开发往往持续数小时,甚至更长时间。模型需要不断编写代码、运行测试、分析报错、修复问题,还要始终掌握整个项目的状态。随着功能不断增加,模块之间的依赖关系越来越复杂,修改一处代码,也可能引发其他功能的异常。
模型能否在长时间开发中保持稳定的工程能力,已经成为 Coding Agent 的重要考题。
在这方面,百灵官方已经展示了几个颇具代表性的案例。
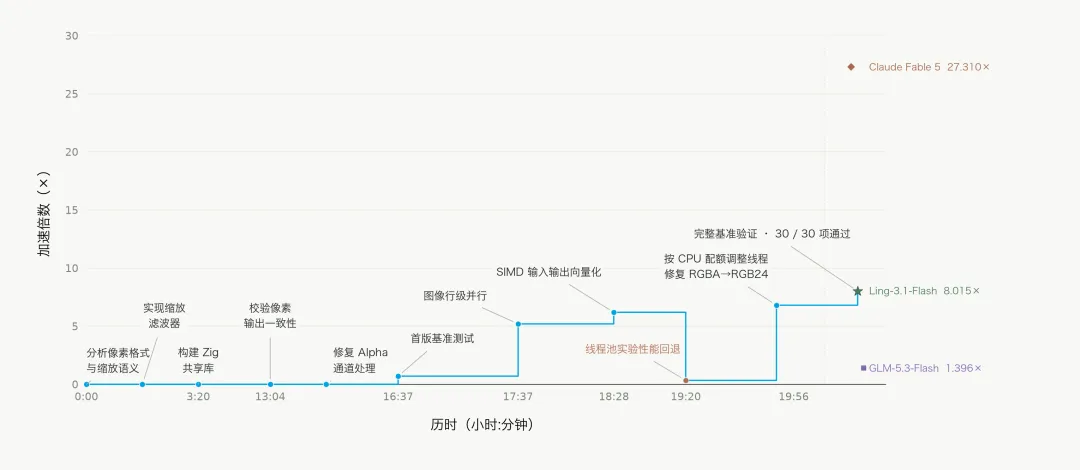
例如一项极具挑战性的任务:用 Rust 重写一个 C 语言图像库,同时保持 C API 兼容、像素输出一致,并引入并行处理和 SIMD 优化。模型历时约 20 小时完成开发,30 项验证全部通过,最终实现了 8.015 倍加速。
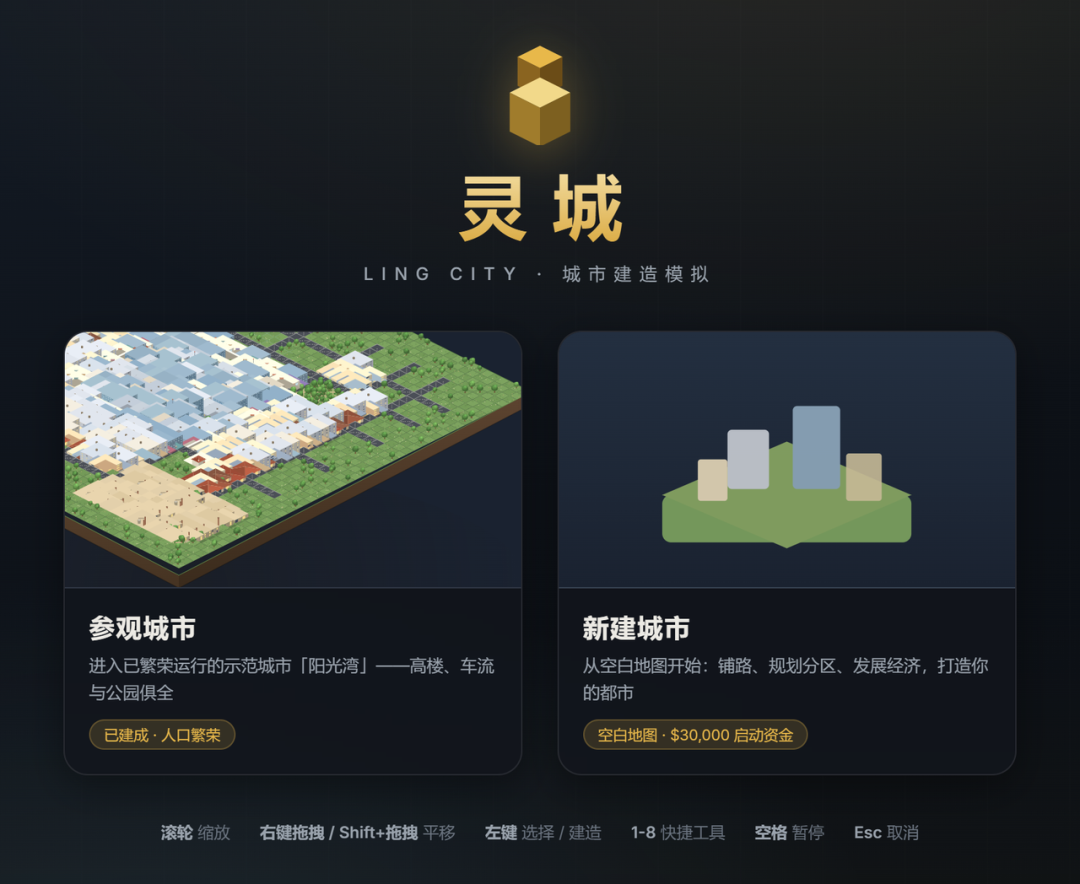
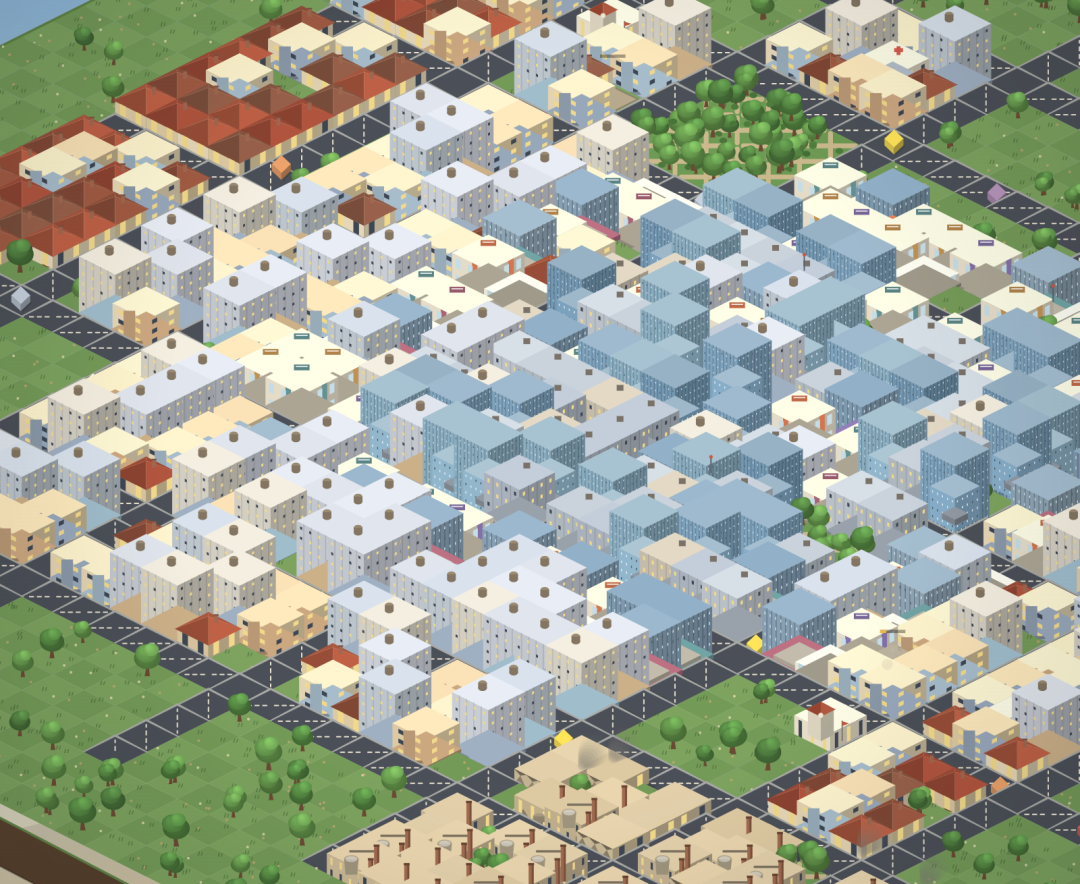
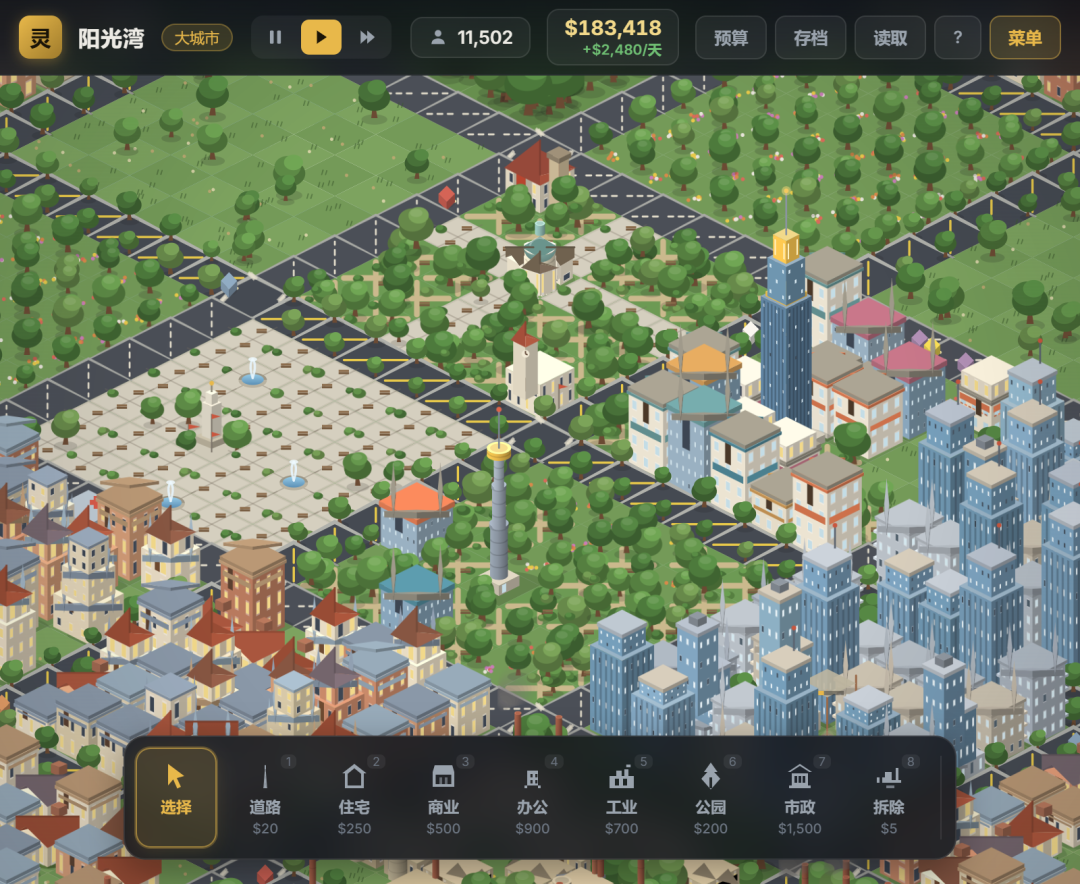
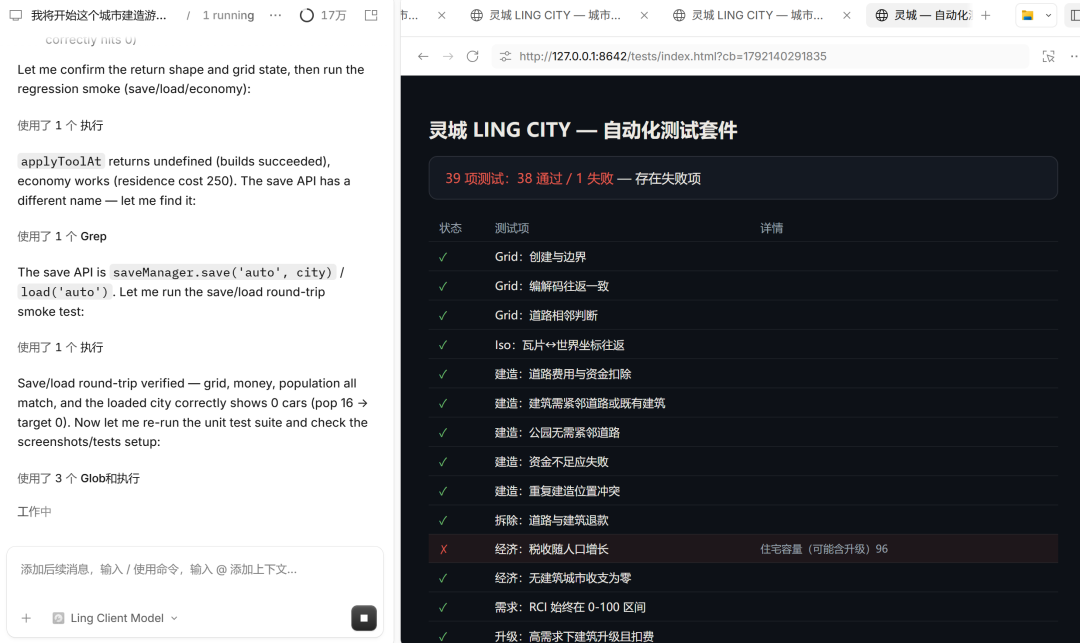
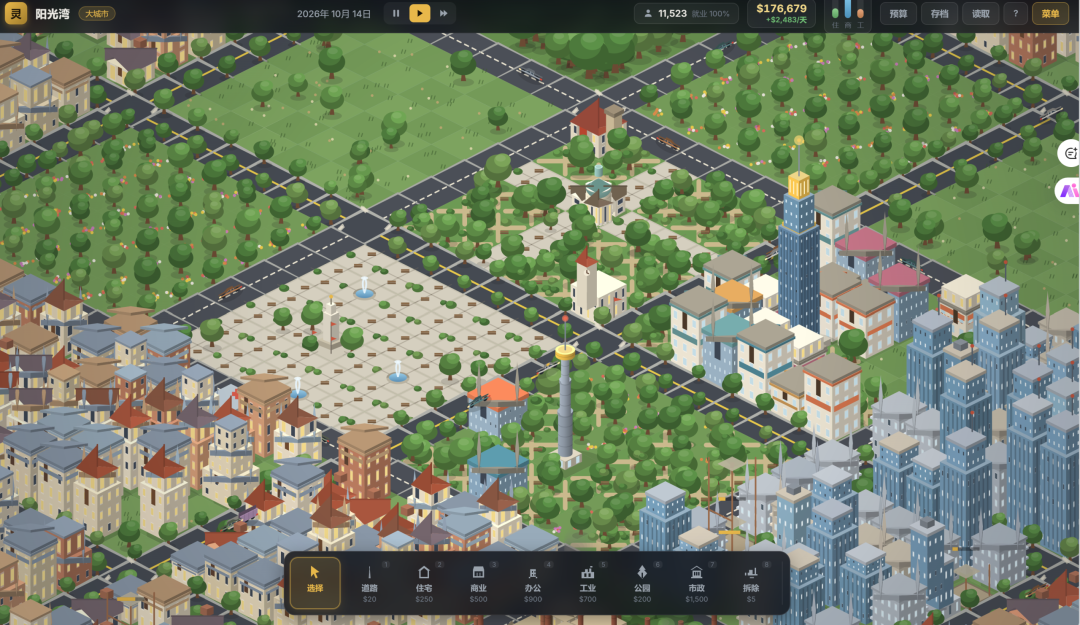
而我们,则对 Ling-3.1-flash 的长程复杂任务能力发起了挑战:让 AI 从零开发一款尽可能完整的城市建造游戏。